


从 Anthropic 招股书看智谱、MiniMax、DeepSeek 和 Kimi:国产大模型的机会与难题
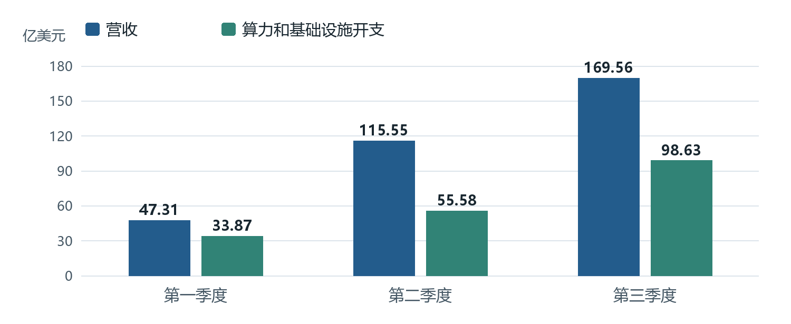
一个季度做了将近 170 亿美元营收,怎么还亏? $Anthropic(ANT)$ 11 月 2 日更新的招股书里,2026 年第三季度营收约 169.6 亿美元,算力和基础设施开支就有约 98.6 亿美元,当季经营亏损约 5.7 亿美元。再看钱从哪儿来,前三季度约 79% 的收入按使用量计费。对市场来说,这份账本同时回答了两个问题。企业愿意把多少钱花在模型上,厂商要花多大代价接住这笔生意。[1] 见图 1。
图 1 Anthropic 2026 年前三季度营收和算力开支
市场在等国产模型兑现什么
国内也有类似的一笔账。2026 年上半年,智谱收入同比增长 399.7%,MiniMax 增长 283.1%,两家的经调整净亏损却都比上年同期更大。MiniMax 年初上市首日涨了约 109%,10 月 22 日收在 160.70 港元,跌破 165 港元发行价。股价还受大盘和资金流向影响。把这段行情和中报放在一起看,就能理解为什么有增长,市场还是要追问利润。[2][3][4]
外界过去容易给国产模型贴上“便宜、量大”的标签。OpenRouter 的数据解释了这个印象从哪儿来。2026 年 9 月第二周,开放权重模型已经拿到过半的 token,闭权重模型仍占平台支出的 73%。不过,从 1 月到 8 月,用户在月之暗面、智谱和 DeepSeek 模型上的月支出,各自都升到了 1 月的至少十倍。三家合计仍只占平台支出的个位数,但花在它们身上的钱已经多了。[5]
从资本市场看,接下来有三件事值得拆开。企业用模型的预算能长多大,国产厂商能从中留下多少收入,以及这一轮技术变化会不会让竞争格局重新洗牌。
市场预期
一 全球企业需求在涨 国产模型已经有了入口
Anthropic 的增长里,最值得看的是企业把模型用到了什么程度。截至 2026 年 9 月底,过去 12 个月给 Anthropic 带来至少 10 万美元收入的客户超过 11,900 家,一年前是超过 950 家。一个团队最初可能只让模型帮忙写代码。用顺了,再让它查故障、补测试,或者接到别的部门的流程里。这样的扩张会带来持续调用,也会把预算从个人工具拉到企业采购。[1]
国产模型已经摸到了全球开发者市场的门。开放权重便于部署,价格降低了试用门槛,编程和长任务的表现则决定试完会不会接着用。OpenRouter 的样本里,2026 年 6 月初,中国模型处理的 token 已超过美国模型。这是一个开发者渠道的用量,不能直接当作全球市场份额。等需求从聊天扩到编程、智能体和企业流程,国产厂商有机会接到更多工作。接下来要看有多少试用能走到生产环境和正式采购。[5][13][15]
二 从低价获客到高价值服务
便宜适合打开第一扇门。真到日常使用时,客户会算另一笔账。比如一次代码迁移,单价低的模型如果反复重试,最后花的时间和钱未必少。简单任务交给 Flash 跑,复杂任务交给旗舰,是一种可以理解的分工。GLM-5.3 系列已有这样的价格分层。OpenRouter 快照里,Flash 有规模,报价更高的旗舰在近 30 天也处理了 19.1 万亿 token。它给高价档的需求提供了一个观察点,渠道用量还要和实际成交价、付费留存分开看。[6][7][14]
财报里也能看到企业付费在增加。2026 年上半年,智谱开放平台及 API 收入约 8.25 亿元,同比增至约 28 倍。MiniMax 开放平台及其他 AI 企业服务收入约 7,390 万美元,同比增至约 8 倍。两个增速都起于较小基数,收入分类也有差异。这些数字说明,生意已经从试用往付费走了一步。下一步要看客户会不会续用、高价值任务能否支撑成交价,以及扣掉推理成本后,新增调用能多留下多少毛利。[2][3]
三 技术路线还在变 各家都有机会做出长板
基座规模仍然重要。现在竞争又多了几块,强化学习怎么做,任务环境怎么搭,模型出了错怎么拿到反馈。DeepSeek 从架构和缓存入手,降低长任务的资源开销。Kimi 把联合强化学习扩到数百个领域。智谱用可运行、能验收的长程任务做后训练,也试着让模型改进自己的推理系统。MiniMax 则让模型在限定条件下做后训练实验。几家公司在不同环节试出了进展,下一代模型怎么练、怎么用,中国团队有机会用这些工程结果参与定义。[7][8][9][10][12]
这类进展值得看,但要落到可复验的结果上。后训练要看换一批真实项目还能不能提分,推理改进要看流量上来以后还能省多少,模型参与研发要看换个环境是否还跑得通。能从实验走到量产,再从量产走到客户长期使用,技术领先才有机会变成经营优势。
$智谱(02513)$ 做到了哪一步
基座没换 模型怎么变强了
GLM-5.3 沿用的还是 GLM-5.2 的基座,智谱的改动主要在后训练:加了更多贴近实际工作的题。比如让模型从代码和实验记录里找出系统慢在哪儿,改完要跑测试,既要确认结果算得对,也要确认真的变快了。在智谱自家的 Z.ai Code Bench 上,同样开到 Max 档,得分从 23.4% 升到 34.5%,每项任务的输出从约 9.6 万降到 7.5 万 token。不过这是自家的测试,换到别人的项目里,还得再测一遍才作数。另外要说明,这里讲的是旗舰版,Flash 用的是另外训练的多模态基座。[7][14]
聊 RSI 先看模型怎么帮自己提速
递归式自我改进(RSI)的远期目标,是让 AI 自己设计、训练下一代模型。智谱先拿 Flash 的推理系统做了一次尝试:工程师定目标,由 GLM-5.3 驱动的 Infra Agent 去查瓶颈、改代码、跑实验。光告诉模型“吞吐量掉了”不够,它很难判断该改内核还是调度。智谱的看法是,得给模型能定位问题的反馈,它才知道下一步往哪试。据公司披露,工程师和智能体配合着做,Flash 从初步适配到可上线用了不到两周,端到端吞吐量达到初始基线的约 3 倍,关键改动仍由人把关。[8]
发布两个多月后还有多少调用
再看模型上线之后的表现。按这份 OpenRouter 快照,Flash 一周处理了 15 万亿 token,排全站第二。拉长到 30 天看,Flash 和前一个 30 天基本持平,旗舰 GLM-5.3 则多了 54%。在 DeepSeek 和 Kimi 相继上新的这段时间里,两款 GLM 合计用量近 7 天涨了 5%,近 30 天涨了 8%。这只是同期的变化,不好直接下结论。按快照里的标价,旗舰约是 DeepSeek V4.1 Flash 1017 的 7–9 倍,用量约是对方的 1/11;不过现在平台上各条路由的报价不一样,这个倍数已经复现不了。榜单只能告诉我们模型处理了多少 token,至于有多少客户留下来付费,还得看别的数据。[6] 用量变化见图 2。
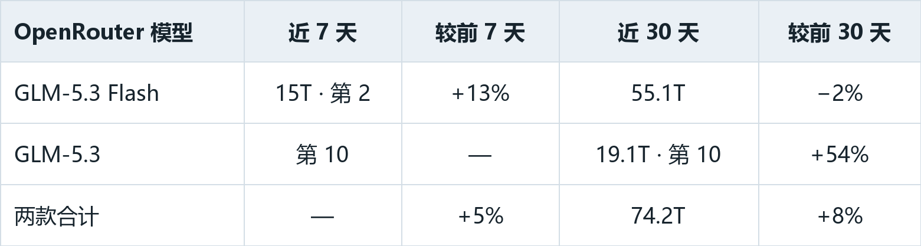
图 2 GLM 在 OpenRouter 的用量变化
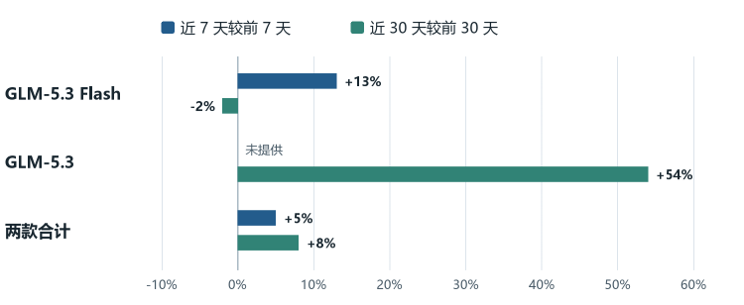
MiniMax DeepSeek 和 Kimi 怎么做
MiniMax 让模型试着训练另一个模型
在 PostTrainBench 里,MiniMax 给 M3 四个已经预训练好的基座,限时 12 小时:合成什么数据、怎么训、测完再改什么,都由 M3 自己决定,人只定了目标、时间和训练对象。跟智谱把模型用在推理系统里不同,MiniMax 想验证的是另一件事:能不能把一段后训练工作整个交给模型,让它在给定条件下自己跑完?[8][10]
MiniMax 也在想办法降低实际使用成本。公司称,10 月上线的 M3.1 Flash 在其智能体任务测试中,使用成本比前代低了约 70%。再看生意本身:公司上半年开放平台及其他 AI 企业服务收入为 7,390 万美元,占总收入的 63.4%,这笔钱上半年就已经入账。至于新模型省下的成本最终能带来多少增量,要等后面的财报来回答。[3][11]
DeepSeek 从长任务里省时间和资源
DeepSeek 抓的是长任务里一个容易被忽略的点。模型读完前面的内容,会留下一部分计算结果供后面接着用,这就是 KV 缓存。V4.1 Flash 把能共用的缓存拿来复用,再用低精度存储压缩占用,给内存腾出空间。10 月的 1017 版,按官方模型卡的说法,做完任务用时更短,输出也更少。对需要反复读文件、调工具的应用来说,这些节省是实打实的,不过具体能省多少,要看任务和部署方式。另外有一笔账得分开算:开放权重可以交给第三方去跑,第三方处理的用量,未必会变成 DeepSeek 自己的收入。[5][12]
Kimi 让同一个基座多练几种活
Kimi K3.1 Pro 同样沿用了上一代基座。它把更多算力投到后训练上,让模型拿数百个领域的任务一起做强化学习。摊子铺这么大,训练环境得搭得起来,大量尝试得调度得过来,每道任务给出的反馈也得靠谱。智谱的例子说明同一个基座还能继续提分,Kimi 则更具体地讲了怎么把训练扩展到更多领域。产品上,编程用 Kimi Code,研究和创作可以在 Kimi Work 里做,也能通过 API 接入。入口已经铺好了,客户会把哪些工作长期留在里面,还有待观察。[9]
用量上来了 难题还在哪
先看新增收入能留下多少。2026 年上半年,智谱经调整净亏损约 19.64 亿元,MiniMax 同期约 2.93 亿美元。API 和企业服务收入的增速很快,训练和交付却也要持续投入。推理成本降了,如果成交价也跟着降,毛利未必会等比例改善。接下来几期,可以看毛利额能不能追上研发投入,经营现金流有没有好转。[1][2][3]
第二个很现实的问题是算力能不能及时到位。买少了,高峰期接不住单;买多了,闲置也要花钱。智谱讲 Flash 的适配时提到,芯片的内存、带宽和算子支持都还有功课要补。在一套设备上跑通只是第一步,接下来要看高峰期稳不稳,换一批任务还跑不跑得动。[8]
第三个是客户能不能留住。接入方便,换起模型来也方便。企业采购会问数据放在哪、服务出错谁负责,到了续约,还要算这一年到底省了多少工时。以智谱为例,OpenRouter 能看出模型有没有被持续调用,而公司 API 的付费客户、复购和毛利,能补上另外一块信息。[2][6][13]
最后是怎么判断模型把活干对了。训练任务越接近真实工作,就越难用一个分数说清楚;只看最终输出,有些错误会藏在中间步骤里。让智能体改代码、跑实验之后,还得划清它能碰哪些数据、哪些操作必须人批准。智谱和 MiniMax 已经在一些边界清楚的任务上跑出了结果,但换成更复杂的研发工作,能不能复现、风险管不管得住,都还要继续验证。[7][8][10]
下一批模型发布,榜单很快会刷新。对资本市场来说,更值得回头看的是下一份财报。客户有没有续用,复杂任务能不能卖出好价,收入多了以后经营现金流有没有改善。企业需求已经在长,国产厂商也有了参与竞争的技术和渠道。能把机会做成多大的生意,要靠这几笔账一季一季来回答。
资料与统计口径
[6] GLM 的用量、名次、环比和价量倍数来自供稿方提供的 OpenRouter 快照。快照未注明采样日和比价路由。近 7 天与前 7 天相比,近 30 天与前 30 天相比。公开资料核对于 2026 年 11 月 3 日。 OpenRouter 榜单 GLM 报价 DeepSeek 报价
[1] Anthropic 修订招股书 [2] 智谱中期业绩 [3] MiniMax 中期业绩
[4] 东方财富港股行情报道 [5] OpenRouter 用量与支出 [7] 智谱后训练
[8] 智谱 RSI 实验 [9] Kimi K3.1 Pro [10] MiniMax M3 实验
[11] MiniMax M3.1 Flash [12] DeepSeek 1017 模型卡 V4.1 Flash 技术报告
[13] OpenRouter 区域路由 [14] 智谱 Flash 发布说明 [15] OpenRouter 中国模型用量样本
文中品牌标识取自各自官网。 智谱 Z.ai MiniMax DeepSeek Kimi
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
