


82亿美元买一张船票:AMD为什么要收购李飞飞的World Labs
作者 |肖恩
编辑 |德新
2012年,多伦多大学的三位研究者用两块英伟达GTX 580游戏显卡,花了五六天训练出一个名叫AlexNet的神经网络。在当年的ImageNet图像识别挑战赛中,它的错误率是15.3%,而第二名是26.2%。
深度学习从那一年起和GPU绑在了一起。那场比赛使用的数据集ImageNet,由当时还是斯坦福教授的李飞飞牵头建立。
14年后,李飞飞即将去一家GPU公司当首席科学家,这家公司是英伟达的老对手AMD。
9月28日美股收盘后,AMD宣布以约82亿美元的股票收购李飞飞在2024年初创办的World Labs,交易预计年底前完成。交割后,李飞飞出任AMD执行副总裁兼首席科学家,直接向苏姿丰汇报。
这是AMD历史上第二大的收购,仅次于2022年约500亿美元的赛灵思。而World Labs成立不到三年,员工约70人,从未公布过营收,如果按收购价折算,每名员工的身价将超过1亿美元。
三周多以前,英伟达刚宣布以约129亿美元收购Hugging Face。不到一个月,两家GPU公司花了200多亿美元,买的都是不造芯片的AI公司。
一家芯片公司为什么要买一家做世界模型的公司?
一、学会了看图识字,但机器还看不懂世界
ImageNet收录了1400多万张人工标注的图片,推动了此后的图像识别研究。它教给机器的,相当于小孩子的看图识字:看到一张图,说出上面有什么。
但认出照片里的杯子和桌子,不等于知道杯子离桌边还有多远,碰一下会不会掉下去。机器要在现实中行动,就得理解物体的位置、形状,以及它们之间的关系。
李飞飞参与的研究“Thinking in Space”做过专门的测试。研究者给多模态大模型看室内视频,再问房间多大、家具相距多远、从门口走到某处该怎么转弯,被测模型在这些任务上仍然落后于人类。
2025年11月,她在长文《From Words to Worlds》中把大语言模型形容为“黑暗中的文字匠”。在她看来,语言能传递关于世界的知识,却不能代替对空间和物理关系的理解。AI需要补上这部分能力,才能从谈论世界走向与世界互动。她把这一研究方向概括为空间智能。
据《连线》杂志报道,2023年初,李飞飞与a16z合伙人Martin Casado的一次饭局,促成了她的创业决定。Casado认为,AI可能重走电子游戏的路,从文字到二维画面,再到三维世界。他还帮助李飞飞寻找了联合创始人。
World Labs于2024年初成立。李飞飞在收购当日的文章中回忆,生成式AI兴起后,大规模前沿研究逐渐从学术界转向产业界。为了继续推进自己的研究,她选择了创业。
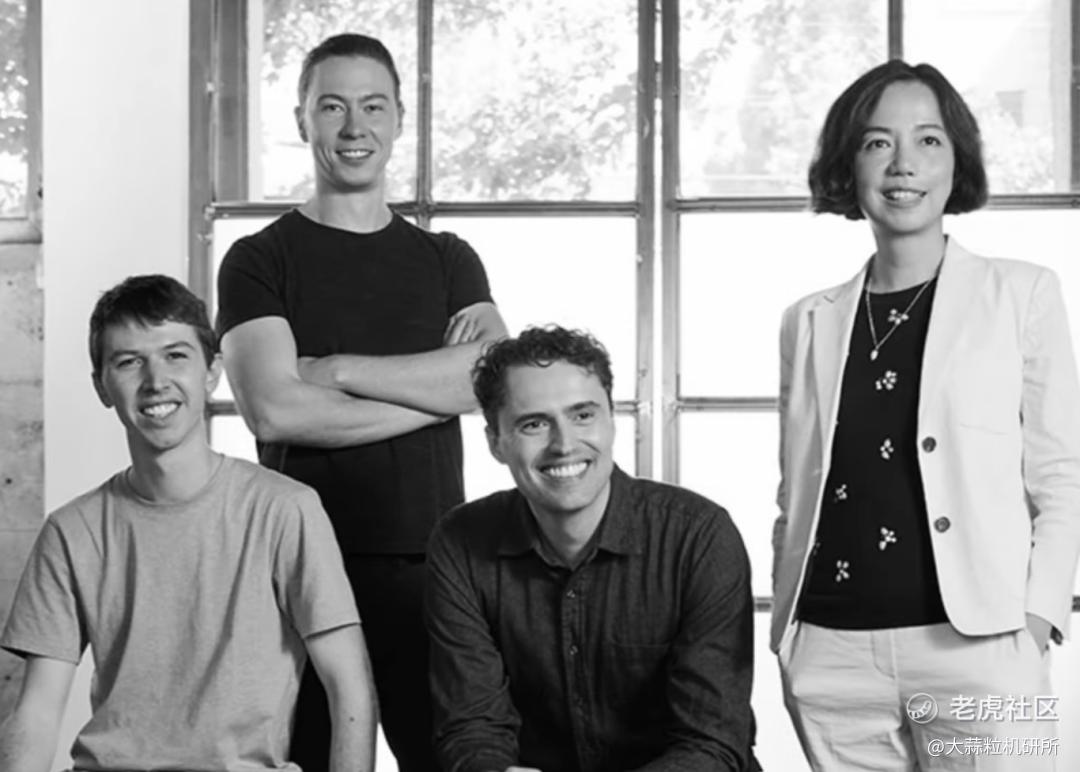
创始团队中的Justin Johnson是李飞飞的博士生,曾与她和Andrej Karpathy合讲斯坦福的CS231n计算机视觉课程。他后来参与的SynSin和PixelSynth,研究的是如何从一张图片生成新视角下的场景。这与World Labs早期演示要解决的问题直接相连。
Ben Mildenhall是NeRF的主要作者之一。2020年,他和合作者提出用神经网络表示三维场景:给模型看不同角度的照片,再让它生成没有拍过的视角。
Christoph Lassner则带来图形工程经验,他开发的Pulsar渲染器进入了PyTorch3D工具库,让图像生成和三维结构学习能够放进同一套训练流程。
这支团队既有人研究机器如何看懂图像,也有人研究如何重建三维、生成画面。World Labs把这些工作放在了一起,试图让模型根据几张照片生成三维场景,让用户可以从不同位置和角度观察,而不再局限于原照片的视角。
二、从一张照片到“子弹时间”
1999年拍摄《黑客帝国》时,为了让镜头绕着躲避子弹的演员移动,剧组在现场架起了上百台相机。
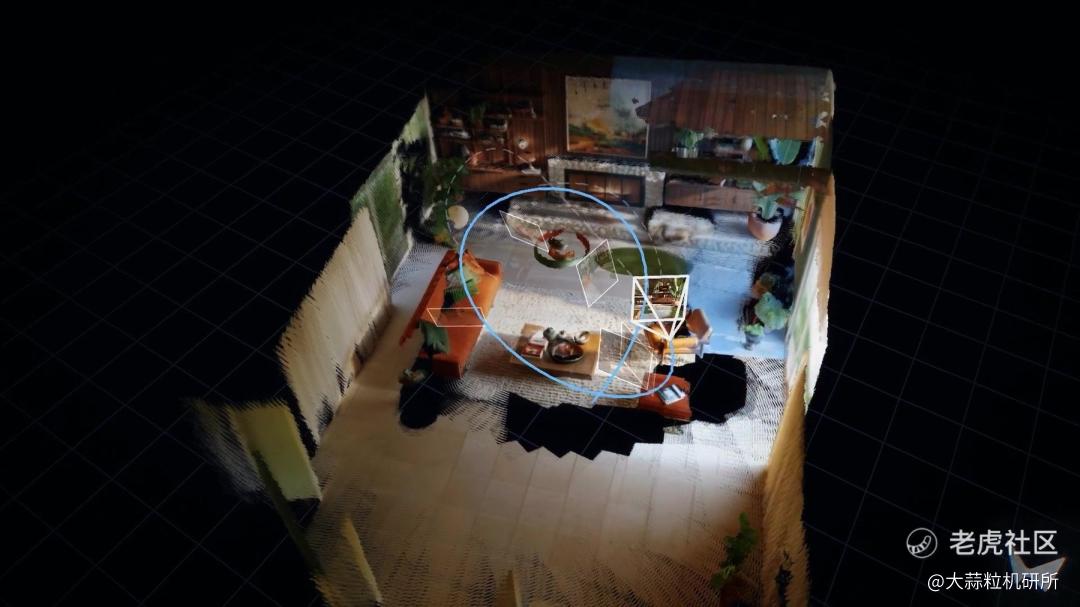
今年9月1日,World Labs发布Atlas。它展示了另一种做法:只用三台普通相机拍下的素材,就能生成类似的“子弹时间”效果。画面定格,镜头绕到现场没有摆放过相机的位置,观看同一个瞬间。团队说,这些素材来自几部手机和运动相机。
Atlas把相机的位置和朝向直接作为输入。给它几张照片,再指定一个观察位置,它就生成从那里看到的画面。李飞飞用预测作类比:大语言模型预测接下来的文字,Atlas预测新的视角。
这种控制与播放一段已经生成的视频不同。用户可以自己决定往哪里看,模型则要让不同角度下的物体对得上。你走出房间再回来,不能发现沙发换了位置、门消失了。
World Labs早期采用的办法,是先建立三维场景,再从中渲染画面。2024年12月的演示已经能让用户在一张图片生成的空间里移动,但是场景很小,走几步就会遇到边界。
2025年11月上线的Marble把这条路线做成了产品。
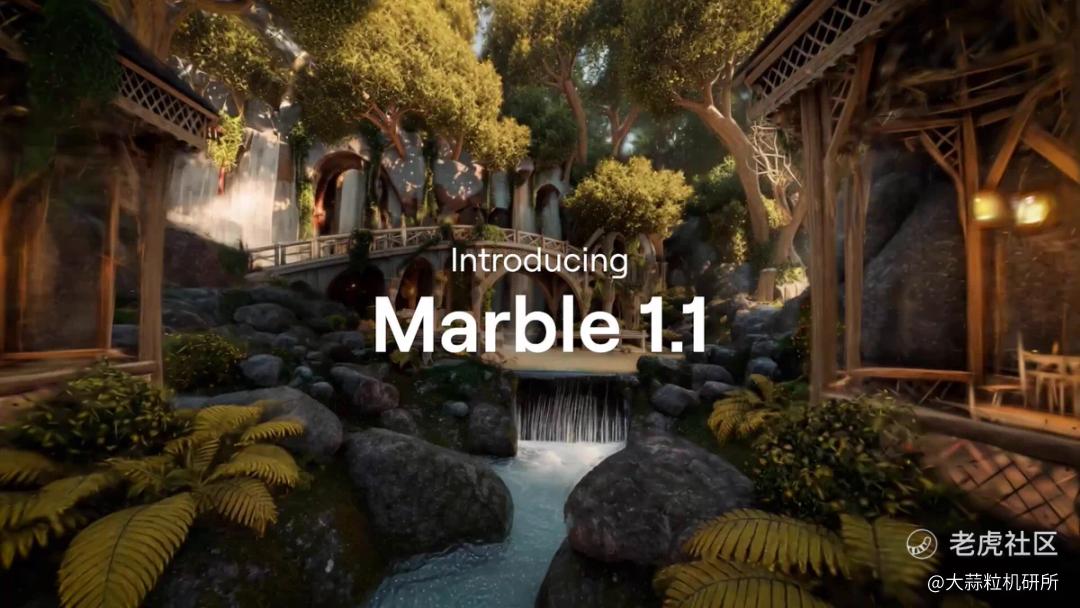
用户可以生成、修改、扩展三维场景,也能导出资产交给其他工具使用。通过它的三维布局工具,可以先用方块安排物体的位置,再由模型补上细节。创作者不必反复要求视频模型“把镜头再往左挪一点”,而可以在场景中安排机位和运动轨迹。
World Labs团队同时研究了另一条路线。
RTFM(Real-Time Frame Model,实时帧模型)是一种根据用户视角变化实时生成画面的世界模型。不先建立显式的三维场景,而是根据用户的观察位置生成画面。它给历史画面记下位置和朝向,镜头回到附近时,再调出相关画面作为参考。
Atlas进一步将图像生成和三维重建放进同一个模型。对于照片没有拍到的区域,模型会补出它认为合理的内容。输入的真实图像越多,需要推断的部分就越少。World Labs还演示过,用手机拍摄环境、取出24帧重建空间,再模拟机器人沿不同路线移动,生成它们身上摄像头会看到的画面。
对电影特效来说,补出的场景只要符合创作意图,就能用。但机器人却不能只凭“看起来像”来行动。桌子的尺寸、物体的碰撞关系,以及推一下之后会发生什么,都可能影响训练结果。
World Labs在今年7月收购的SceniX,补齐了机器人仿真方面的能力。它把真实任务复刻为可交互的仿真环境,再改变物体摆放、外观和物理参数,生成更多训练与测试情境。公司展示的一组双臂装箱实验中,仿真与现实执行同一串动作,物体运动和最终结果很接近。
李飞飞在今年6月按功能区分过三类世界模型:渲染器输出画面,模拟器描述世界及其变化,规划器输出行动。Marble、RTFM和Atlas生成场景与画面的能力,对应的是渲染器。Atlas还能重建用于机器人仿真的空间,SceniX则进一步模拟物体运动和物理交互,为模拟器这一方向补充了能力。
World Labs下一阶段的产品可能就是决定机器人下一步如何行动的规划器,
三、已经合作一年,AMD为什么还要收购
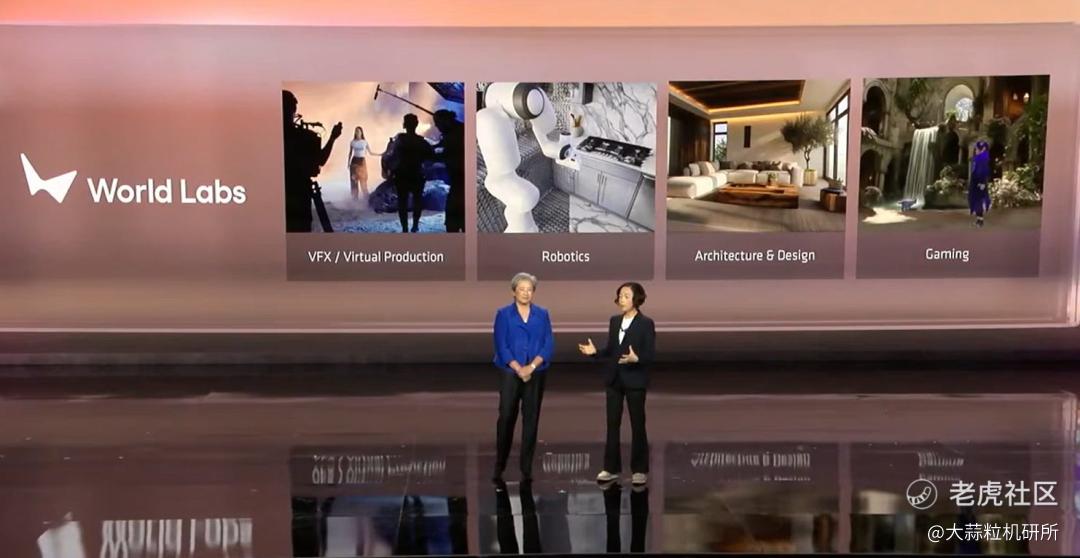
今年1月的CES上,苏姿丰把李飞飞请上AMD的主题演讲舞台,两人演示了Marble如何用几张图片生成三维场景。李飞飞谈到,机器人和汽车可以先在数字世界里学习,再进入现实环境。
在这之前,AMD已经通过B轮融资成为World Labs的股东。双方从2025年起共同优化模型在AMD GPU上的训练和推理,今年2月,AMD又参与了World Labs的新一轮融资。
苏姿丰在接受彭博采访时解释,收购World Labs,是为了把李飞飞团队的研究能力,与AMD在硬件、软件和系统上的能力结合起来。在她看来,对整个过程理解得越深,就越能做出更好的系统。
芯片研发需要数年,等新GPU出货时,主流模型的架构和使用方式可能已经改变。苏姿丰在收购公告中谈到,要为下一代AI打造计算平台,需要深入理解模型如何演进。
在RTFM的技术博客里,团队算过一笔账。如果沿用当时的视频生成架构,要生成4K、每秒60帧的交互画面,每秒就需要产出超过10万个token,也就是模型处理信息的基本单位。要让场景在持续一小时的交互中保持一致,需要处理的上下文可能超过1亿个token。
RTFM采用的办法,是避免每次生成都处理全部历史画面。镜头移到哪里,模型就按照空间位置找出附近的历史帧,作为生成新画面的参考,团队借助这类设计,在单张H100上做出了交互式预览。
哪些信息需要缓存,哪些画面只需在用到时读取,哪些计算可以通过修改模型省去,都会影响模型对硬件的要求。
芯片工程师越早参与这些工作,就越有机会在设计下一代GPU时作出相应调整,而不只是等模型发布后,再想办法提高它在现有硬件上的运行效率。
长期合作虽然也能开展联合研发。但收购之后,AMD能直接参与人员、预算和研究计划的安排,让模型与芯片团队在更长的研发周期内共同工作。
World Labs在今年2月完成的融资达到10亿美元。李飞飞在彭博采访中谈到,随着公司发展,团队的研究目标不断扩大,算力需求也随之增加。她希望加入AMD后,软硬件研发能够相互推动,加快开发进度。
李飞飞在解释为何加入AMD时,提到扩大研究规模和应用范围,也提到让团队更靠近硬件。除了获得更多算力,研究人员还能与AMD的工程师共同解决训练、部署中的问题,参与后续计算系统的设计。这也是单纯采购更多GPU难以替代的部分。
交割后,Johnson和Mildenhall将继续与李飞飞共同领导团队,推进前沿模型研究。
英伟达已经在把模型研究与硬件业务结合起来。2025年初,它发布Cosmos世界模型平台,开发者可以用这些模型,将Omniverse中的三维场景转成用于物理AI开发的训练视频。GPU、仿真工具和模型,都在它的业务范围内。
World Labs的研究也可能用于游戏。
AMD是PlayStation 5和Xbox Series X|S的芯片供应商,还与索尼开展了Amethyst机器学习图形合作。收购公告尚未披露游戏业务的整合计划,但如果未来更多游戏场景由神经网络生成和渲染,这支团队的工作就可能用于这些平台。
四、用这轮热潮的钱,买下一轮的船票
在收购World Labs之前,AMD已经多次用股票争取大客户的订单。
2025年10月,AMD向OpenAI提供最多1.6亿股、行权价0.01美元的认股权证,对应双方最多6GW的GPU部署合作。今年2月,Meta也获得了最多1.6亿股的认股权证。这些权益按约定的部署和其他条件分批兑现。
7月,AMD又承诺向Anthropic投资最多50亿美元,对应最多2GW的GPU部署。到了9月,82亿美元的股票将用于收购World Labs。此前的交易围绕客户采购展开,这次AMD希望获得的是研发能力。
AMD近期市值一度突破1万亿美元,82亿美元不到其市值的1%。股价越高,支付同样一笔收购款需要增发的股份就越少。
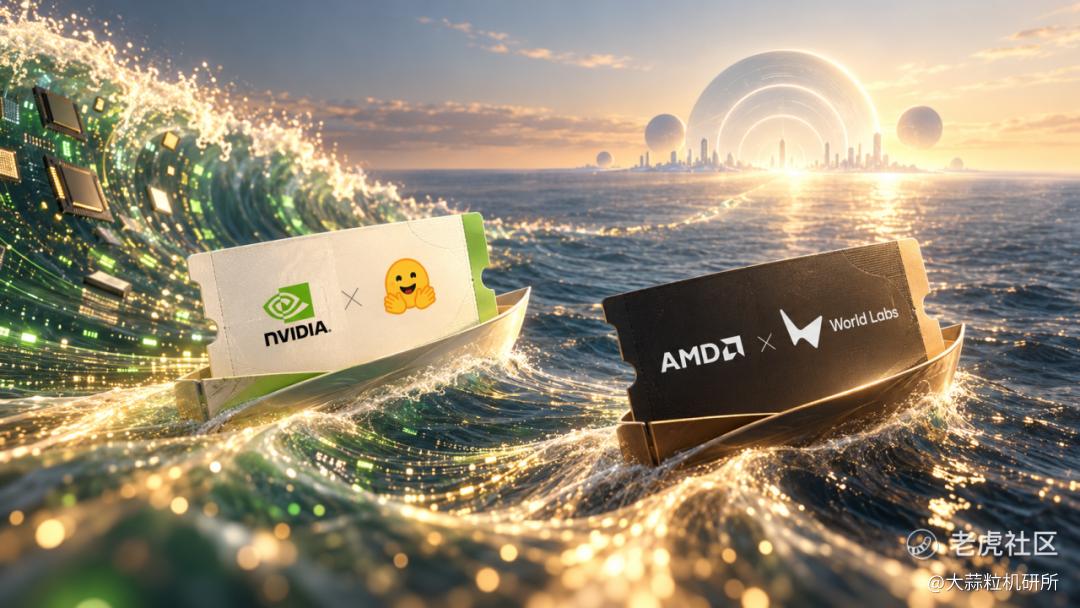
在AMD宣布收购World Labs的三周多前,英伟达已宣布以约129亿美元收购Hugging Face。不到一个月,两家GPU公司宣布的收购总额超过200亿美元,买的都不是芯片公司。
AMD用股票支付,英伟达则从AI业务中积累了充裕的现金。上一财年,英伟达的净利润约1200亿美元,自由现金流965亿美元。除了向多家模型公司承诺投资,它还取得了Groq的技术授权,并吸纳了核心团队。
两家公司忙于扩大业务时,大客户也在寻找更多芯片供应来源。Anthropic计划使用最多100万颗谷歌TPU,亚马逊持续扩大自研芯片业务,OpenAI与博通合作的推理芯片也计划在年底前开始部署。
算力需求还在增长,但新增需求未必都会变成他们的GPU订单。
今年,微软、谷歌、亚马逊和Meta四家的资本开支合计约7300亿美元,比去年增长近八成。这些投资支撑了眼下的需求,但芯片公司不能把今后的增长都寄托在客户保持同样的投资速度上。
英伟达在CUDA上的投入,早于深度学习热潮。到AlexNet取得突破时,研究者已经有了可用的GPU计算工具。此后,更多模型、软件和工程经验围绕CUDA积累,新的研究又可以沿用这些成果。
开发者更换硬件,除了比较性能,还要考虑已有代码能否运行、工具是否齐全,以及团队需要花多少时间重新适配。
英伟达决定收购Hugging Face,看中的是聚集在这里的开放模型和开发者。黄仁勋在接受CNBC采访时说,云服务商只占英伟达生意的一半,另一半主要由开放模型驱动。这些模型最终用来开发什么应用、部署在什么硬件上,同样关系到英伟达今后的生意。
Hugging Face已有庞大的开发者基础,World Labs则仍在探索新的模型。
英伟达希望扩大现有生态,AMD选择在世界模型的工具和应用方式还未定型时投入。两家公司都在利用这一轮AI热潮提供的资金和估值,争取下一轮应用增长的机会。
四、结语
14年前,李飞飞团队建立的ImageNet,见证了AlexNet与GPU的结合。14年后,她将带着World Labs加入AMD,参与下一代计算系统的研发。
世界模型还在探索如何理解和模拟现实,芯片公司却必须提前数年作出产品决策。AMD希望这两项工作能一起推进,让研究者在芯片定型之前参与设计,而不只是拿到硬件后设法用好它。
苏姿丰在接受彭博采访时说:“我们的目标,是定义AI计算的未来。”
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
