


零跑造出了机器人,为什么不肯拿出来遛一遛
作者 | 本一
编辑 | 德新
9月零跑汽车的技术日上,朱江明在台上抛了一个问题,很多人问他零跑为什么不搞具身智能。
他的回答是:「能遛一遛的机器人不算本事,能赚钱的机器人我们才拿得出手。」
他说零跑是最具条件做这件事的车企,但公司的理念是不炒概念,目前只做了小规模投入,处于跟随的状态。
他透露零跑已经做出了自研的机器人,同事建议让机器人上台遛一遛,被他否了。
这是公关层面的措辞,那真实的情况呢?
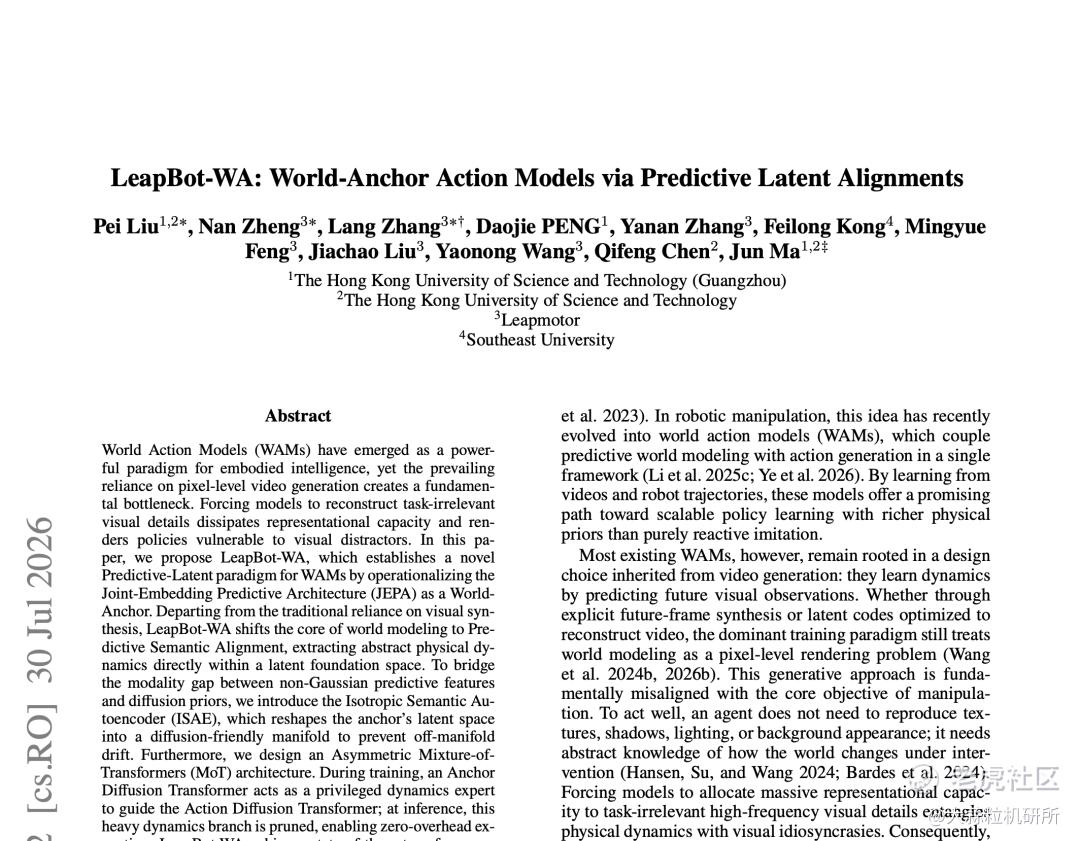
7 月 27 日,一篇叫 LeapBot-WA 的机器人论文传上 arXiv,方向是机械臂操作。
7 月底,零跑旗下浙江凌升动力全资设立的湖州凌升精密制造有限公司成立,注册资本 2.1 亿元,经营范围包含工业机器人制造和智能机器人研发。
零跑高级副总裁周洪涛在技术日次日的专访里透露,零跑智能技术研究院下设五个部门,数据闭环、端到端模型、量产开发、算力平台,第五个就是具身智能。机器人样机已经研制完成,人形和轮式方向都有技术储备,短期锚定工厂自动化和物流运输。
2025年3月,朱江明说过「已组建几十人的人形机器人研发团队」,「未来将主要用于整车生产线装配」。
机研所把这篇 LeapBot-WA 的论文从头到尾读完了,今天给大家拆解一下零跑目前在具身智能研究上的技术方向和成果。
一、做智驾的那批人,顺手写了篇机器人论文
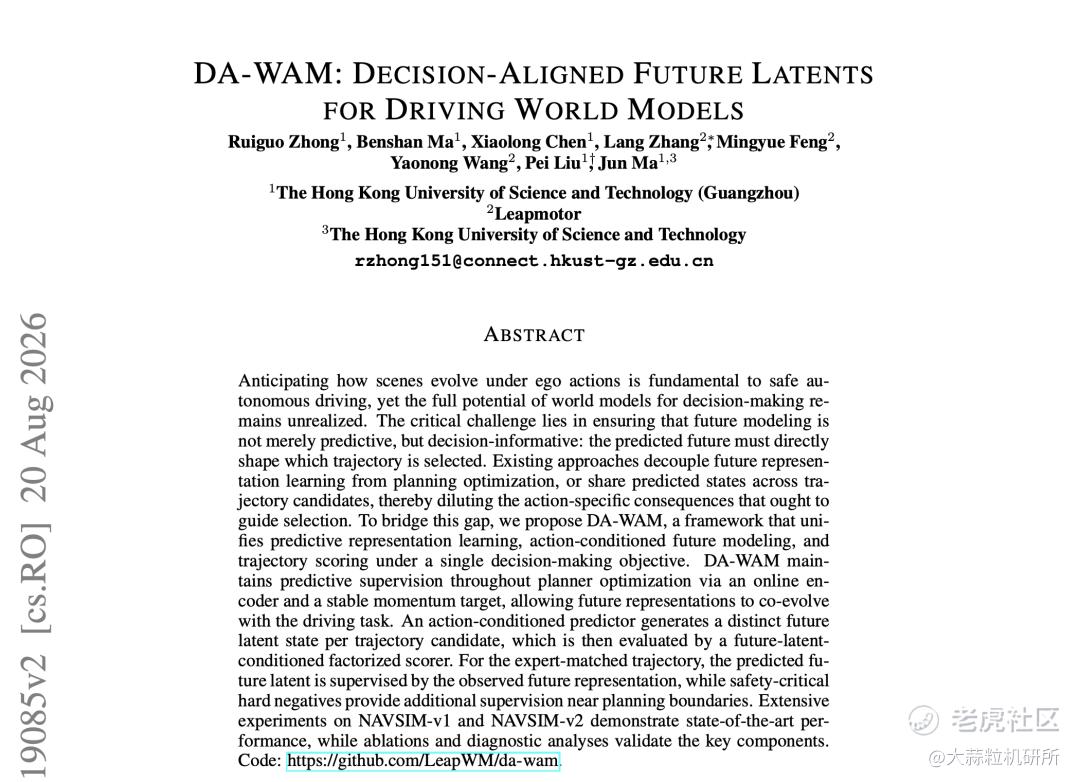
在查阅论文的时候,我们发现零跑 DA-WAM 和 LeapBot-WA 的作者存在一组清晰的交集。
DA-WAM 是零跑的驾驶世界模型,零跑这边署名的是 Lang Zhang、冯铭月(Mingyue Feng)、王耀农(Yaonong Wang)。机器人这篇 LeapBot-WA,有 Nan Zheng、Lang Zhang、Yanan Zhang、冯铭月、Jiachao Liu、王耀农。
以及这两篇的核心作者都包含 Pei Liu 和 Jun Ma,均来自香港科技大学(广州),LeapBot-WA 还挂了香港科大的陈启峰(Qifeng Chen)。两篇论文的代码仓库属于同一个 GitHub 组织 LeapWM。
显然这是一次校企联合研究,港科广那个课题组在其中的分量不轻。零跑侧 DA-WAM 的三位作者全部出现在 LeapBot-WA 中,两篇的核心作者 Pei Liu 和 Jun Ma 也重合。至少从署名看,做智驾世界模型的研究者参与了这次机械臂研究,但仅凭作者名单无法判断两支团队的完整人员构成。
二、一条少有人走的路
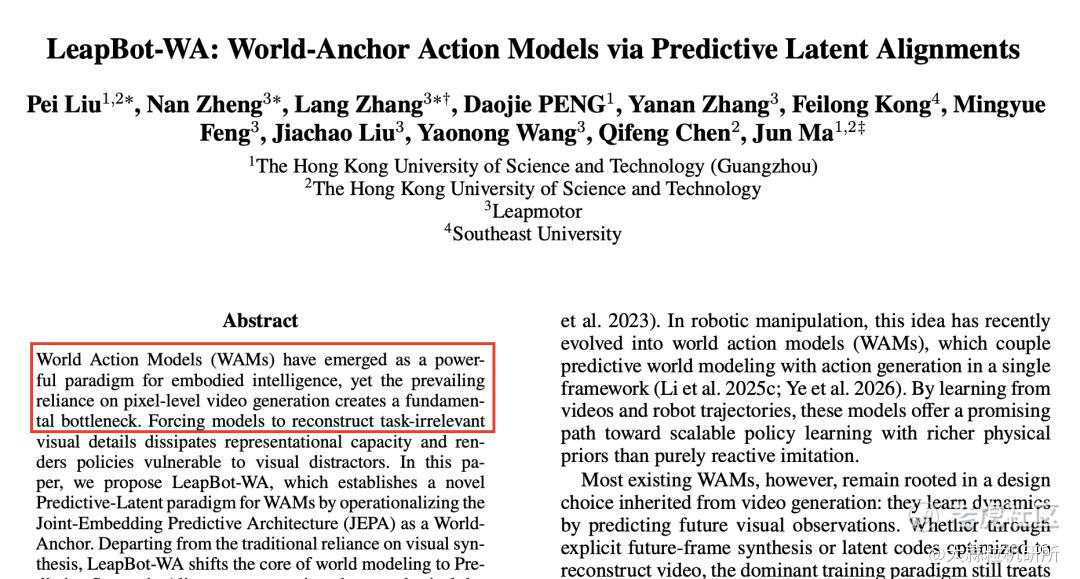
LeapBot-WA 论文摘要开头就阐明了作者对世界模型的立场。
论文原话是:「依赖像素级视频生成造成了根本性瓶颈,强迫模型去重建与任务无关的视觉细节,会耗散表征能力,并让策略在视觉干扰面前变得脆弱。」
「机器人操作」这个方向现在有一类模型叫世界动作模型,缩写 WAM。它和智驾圈说的世界模型是同一个思路,都是让模型在动手之前先推演一遍接下来会发生什么。智驾推演的是路口、车流和自车轨迹,机器人推演的是手往哪移动、物体会被推到哪里。
主流做法是在像素空间里完成这次推演,也就是生成未来的视频帧,模型一边预测画面一边输出动作。英伟达的 Cosmos Policy、腾讯 Robotics X 参与的 ImageWAM、蚂蚁灵波的 Lingbot-VA 都走的是这条路。
零跑选择的是另一条技术路线。
论文中,表 2 把世界动作模型分成 Pixel Space WAMs 和 Latent Space WAMs,零跑属于后一个分类,只在潜空间里预测状态,全程不重建画面。(注:这是零跑自己的分类,不代表行业共识。)
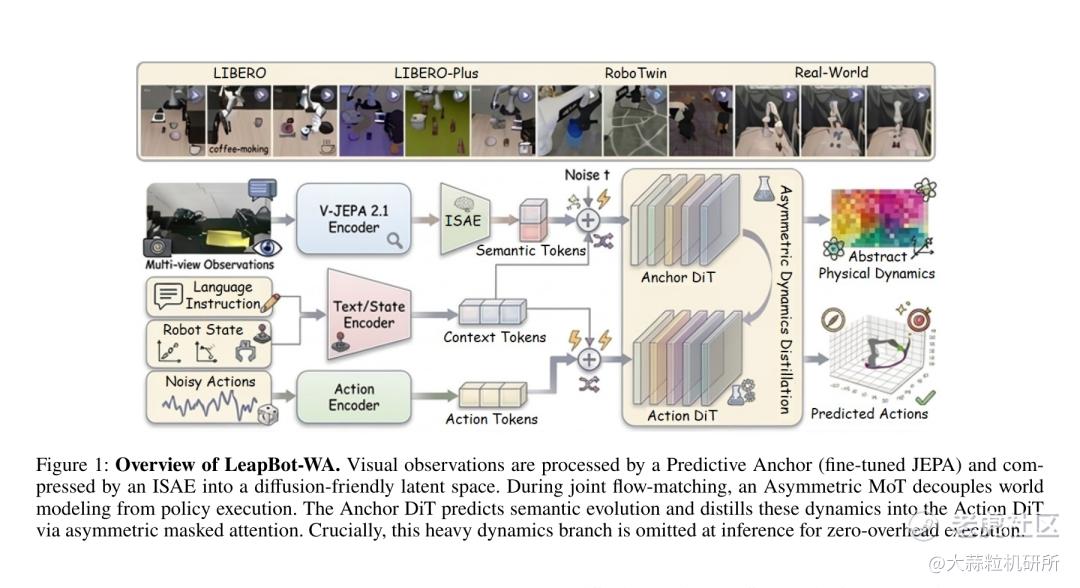
不重建画面,推演靠什么完成?
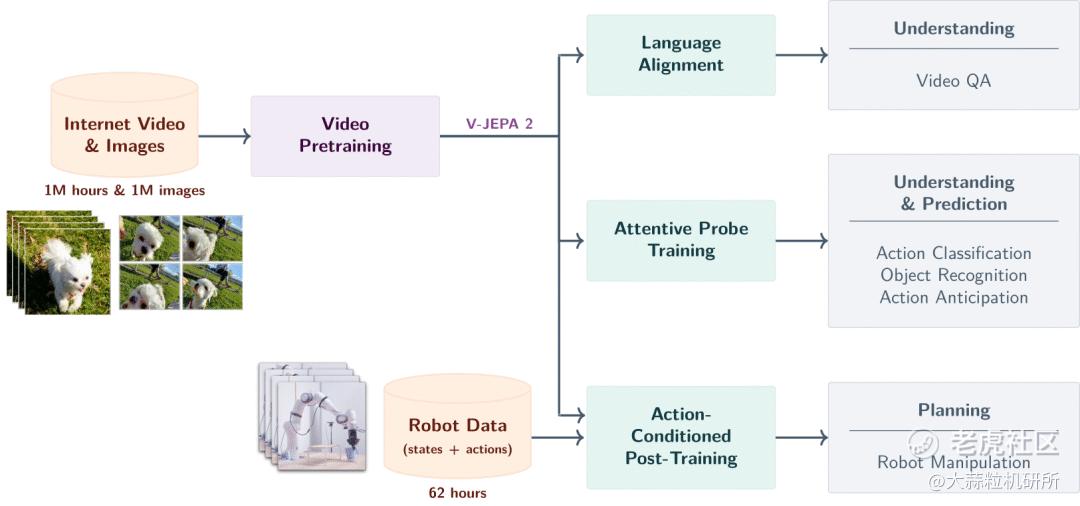
零跑的做法是用 Meta 的 V-JEPA 2.1 做底座,在机器人轨迹上做 LoRA 微调,构成一个叫 Predictive Anchor 的预测锚点。JEPA 这套架构只在潜空间里做预测,它学的是物理状态怎么转移。锅从左边挪到右边,它记下来的是一个物体发生了水平位移,锅的反光和桌布的花纹不进入它的表征。
这中间有个接口问题。
JEPA 输出的特征强结构化而且非高斯,下游的扩散模型要的是各向同性高斯先验,两边直接对接会让去噪轨迹漂出流形。零跑为此设计了 ISAE——各向同性语义自编码器,把 JEPA 特征压进一个 96 维的扩散友好潜空间。训练时用了三项约束,一个带余弦项的重建损失保证特征不失真,一个 KL 散度把后验往标准高斯上拉,还有一项正则专门防止维度塌缩。
第三块设计更有意思了。它决定了这条路线的成本结构。
LeapBot-WA 用了一个非对称混合专家结构,里面有两个分支。Anchor DiT 负责预测语义怎么演化,Action DiT 负责生成动作。训练的时候,Anchor DiT 通过非对称掩码注意力把动态蒸馏进 Action DiT,掩码只允许动作分支去读语义分支,反向不通。
到了推理阶段,Anchor DiT 整条剪掉。论文里把这个叫做「零开销执行」(zero-overhead- execution)。推演未来这件事只发生在训练阶段,机器人干活时不再推演未来,只从当前画面取一次语义特征。
推演到底有多贵,做智驾的朋友应该都有体感。
生成式世界模型每推进一步都要产出一批未来帧,帧数、清晰度、时序连贯性,三项都会推高算力开销,这在资源受限的部署平台上尤其敏感。
论文给出的 LeapBot-WA 推理延迟是 546 毫秒,比同类像素派的 Lingbot-VA、Motus 快约九成。这里的「零开销」特指推理时剪掉未来动态预测分支,并不意味着整套模型没有推理开销。零跑的选择是把预测未来动态的重分支留在训练期,部署时仍需从当前画面提取一次语义特征并生成动作。
两个分支各 30 层,隐藏维度 1664,24 个注意力头,24 张 H200 训练,总参数 2.9B。
三、零跑为这条路线付出了什么?
任何技术路线都有取舍。零跑选的是推理阶段零开销,那它在别的指标上表现如何,LeapBot 论文里有三张表写得很清楚。我们一张一张看。
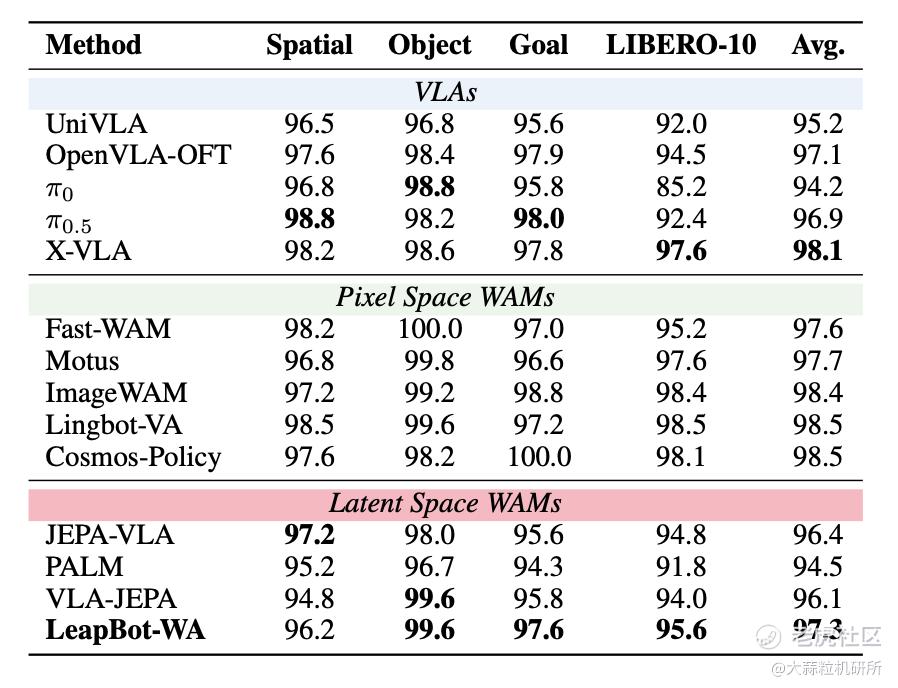
第一张是 LIBERO,机械臂操作最常用的仿真基准,4个子集合计40个任务。
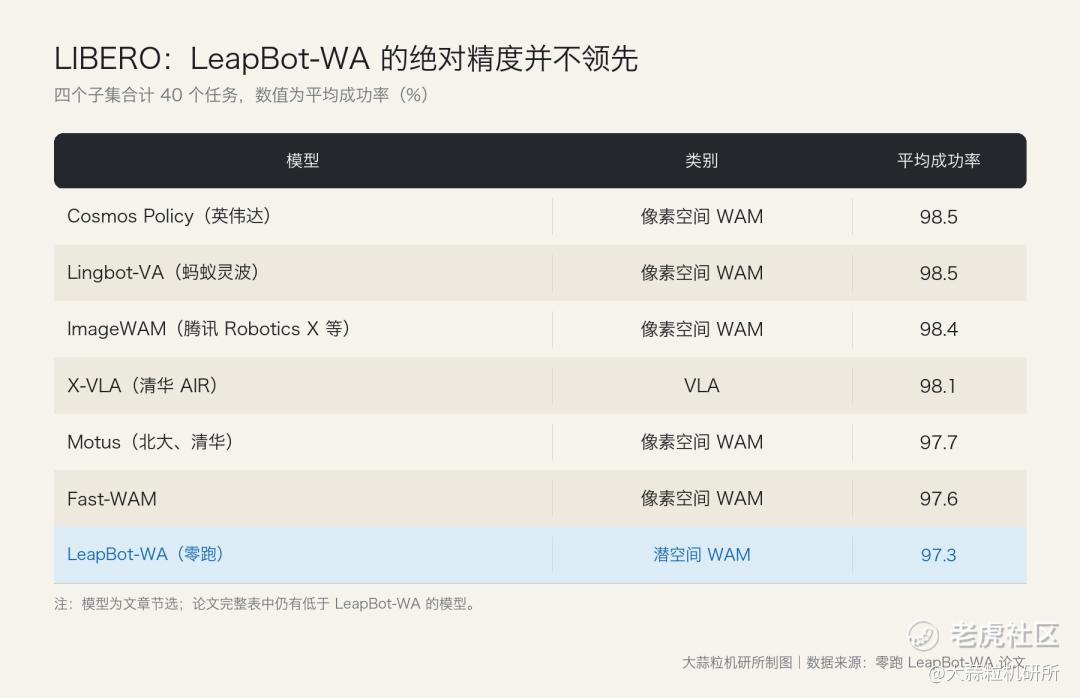
这张节选表比的是绝对精度,零跑在列出的七个模型中排在末位;完整表中仍有低于它的模型。论文里说的是,在所有 predictive WAM 中最好,加粗也只在潜空间那一栏内部进行。
第二张是 RoboTwin 2.0,比 LIBERO 难一些,50 个双臂协作任务,两只手要配合,而且分干净环境和随机化环境两栏分别测。随机化那一栏会把光照、材质、干扰物、物体摆放全部打乱。
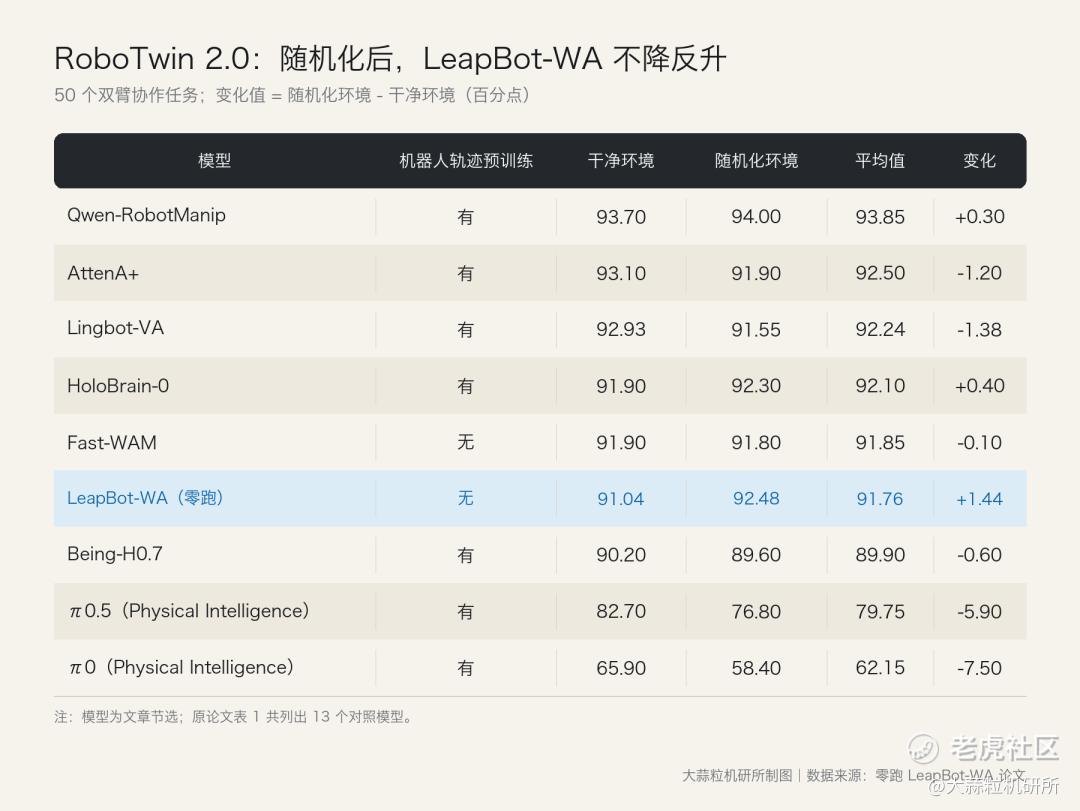
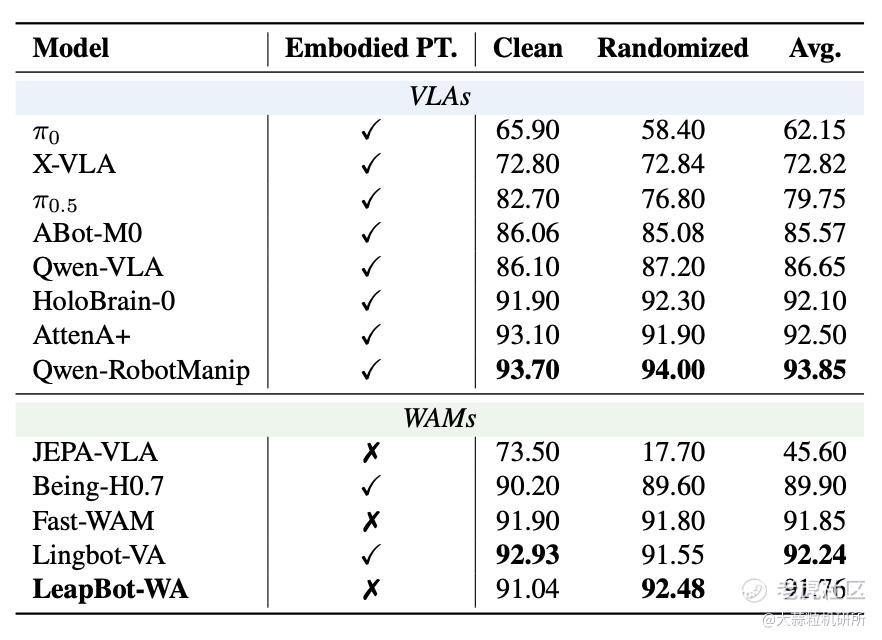
上面表中所列模型只是节选,原论文中提供了 13 个模型的表现作为对照参考。
这张表中,零跑在一个类别的成绩最为突出。请看最后一列,论文原表的 13 个模型里,环境被打乱之后成绩还能往上走的只有五个,零跑的 +1.44 是其中最大的增幅。大部分模型在随机化之后往下掉,但零跑不降反增,是往上走的。
零跑的平均成绩是 91.76,比 Qwen-RobotManip、AttenA+ 和 Lingbot-VA 都低,这三个模型都做过大规模机器人轨迹预训练,零跑这一栏的预训练标记是「无」。同样做过预训练的 π0、π0.5 和 Being-H0.7 则低于零跑。
结论是,零跑在没做预训练的前提下,超过了一部分做过预训练的模型,但并没有超过这一类里最强的那几个。同样没做预训练的 Fast-WAM 均分略高于零跑(91.85),零跑胜在随机化上的成绩。
第三张表涵盖的信息量最大,也是暴露零跑技术取舍结果最充分的一张。LIBERO-Plus 把泛化能力拆成七个扰动维度分别打分,看模型在没见过的条件下还能保留多少性能。
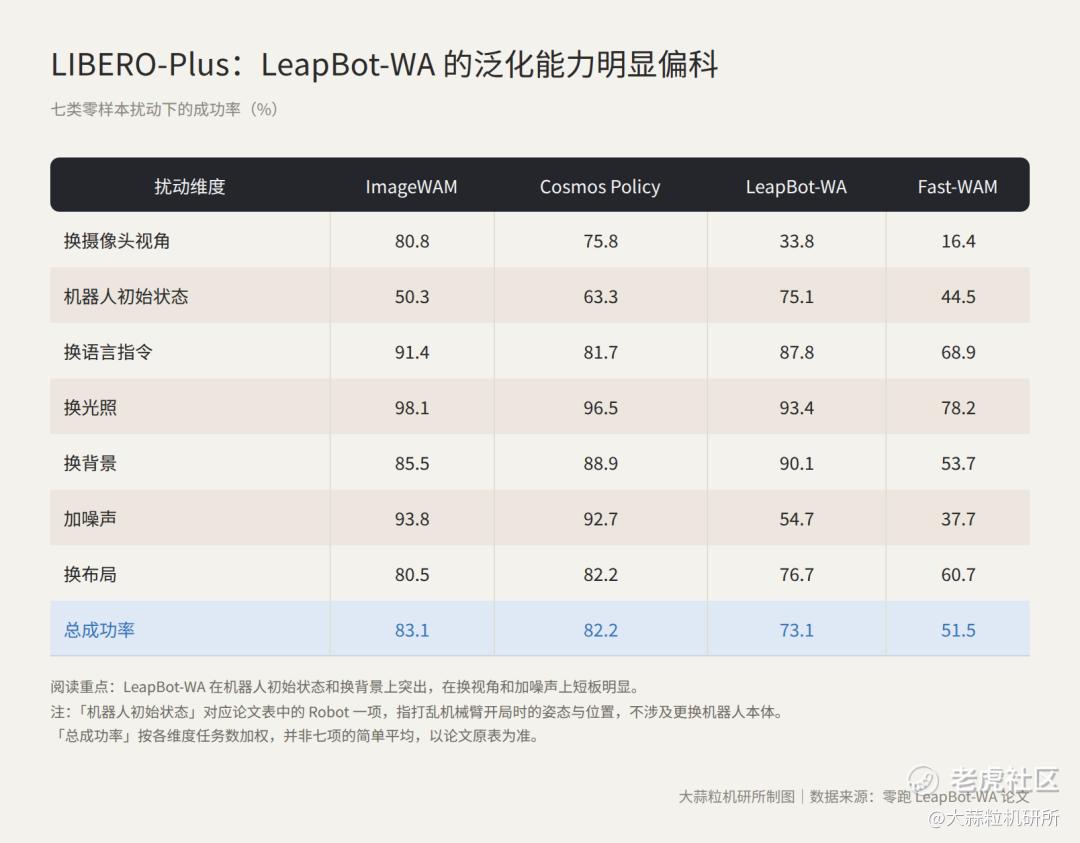
总成功率零跑落后九到十个点,但零跑比 Fast-WAM 高二十多个点。七个维度拆开看,差距分布得很不平均。
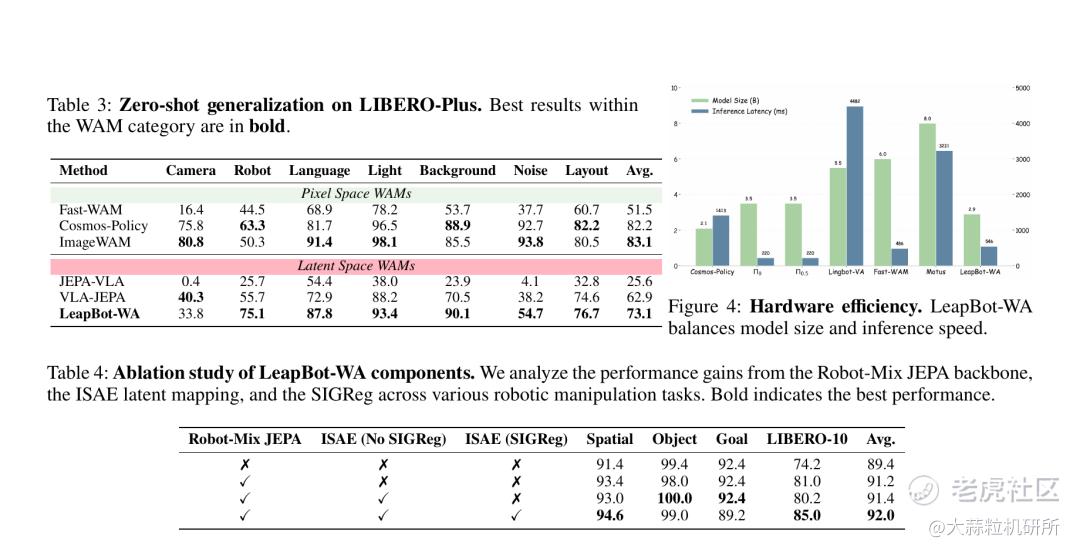
机器人初始状态这一项,也就是把机械臂开局时的姿态和位置打乱,零跑拿到 75.1,两个像素派分别是 50.3 和 63.3,领先幅度在 11.8 到 24.8 个点之间。换背景零跑也是三者最高(90.1)。在另外两项,换摄像头视角和加噪声这两项,表现不佳,其中换摄像头视角零跑只有 33.8,落后 42.0 和 47.0 个点;加噪声 54.7,落后 38.0 和 39.1 个点。
需要说明的是,表里写作「Robot」的这一项,LIBERO-Plus 原论文的定义是机器人初始状态扰动。整个测试始终用的是同一台仿真机械臂,并不涉及更换本体,所以这项成绩说明不了零跑的模型能在机械臂、轮式和人形之间迁移。
四、为什么这两项落了下风?
论文没有直接解释为什么这两项明显落后。一种可能的机制解释与 JEPA 的表征方式有关。
潜空间里保存的是手和物体之间相对关系的演化,这套关系需要从图像里反推出来。视角一改变,同样的物理关系投到画面上就完全变了样。一个可能的解释是,像素派的模型在训练中见过大量不同视角的画面,投影关系已经写进了权重;零跑这套没有这一层,必须在推理时现场把关系还原出来,还原不出来动作就停在那儿。加噪声掉到 54.7 是同一个机制,噪声干扰的正是从画面到关系这一步推断。
消融实验的实验结果同样值得一提。三个组件全部去掉的时候平均 89.4,全部加上 92.0,三个组件合计带来的增益是 2.6 个点,其中加入防塌缩正则之后,Goal 子集反而从 92.4 掉到了 89.2。
不过,零跑表现不佳的这两项扰动,在它锚定的场景里通常更容易被工程化控制。
按照周洪涛的描述,零跑短期锚定工厂自动化和物流运输。周洪涛在专访里明确说,不考虑商超导购、家政服务等通用场景。
相比开放服务场景,工厂和仓库的视角、光照、背景和人员干扰通常更可控,部分固定工位还可以让摄像头长期保持不动;但这不等于所有工业现场都没有这些扰动。
零跑成绩最差的两项,恰好是在固定工位里相对容易控制的条件。短板还在,只是在它选的场景里没那么致命。
商超导购的条件刚好相反,摄像头可能跟着机器人移动,人流也会形成持续的视觉干扰,正好落在 33.8 和 54.7 这两个结果所代表的能力短板上。
五、和同行们的路线差异
我们核对了这篇论文的对比模型,结果出乎我们的预料。
表 1 和表 2 去重后一共对比了 19 个模型,来自英伟达、Physical Intelligence、阿里通义与高德、腾讯 Robotics X、蚂蚁灵波、地平线、**诺亚方舟、星海图、智在无界,以及清华、北大、斯坦福、港科广等高校。
这里边没有任何一家车企。小米、理想的机器人论文其实和零跑跑过同一个 LIBERO,小米 Xiaomi-Robotics-0 的成绩是 98.7%,但零跑没有把它们放进来对比。
按技术路线归类,用于具身智能的世界模型大致分三派。
像素生成派,规模最大。
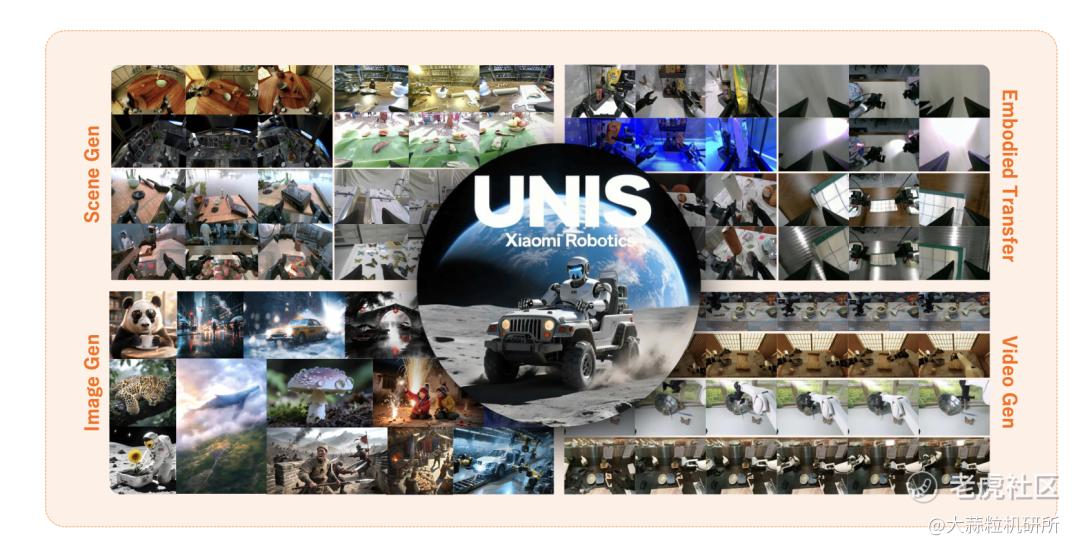
小米的 Xiaomi-Robotics-U0 是 380 亿参数的多模态自回归模型,把具身生成当作基础图像和视频生成的延伸来做。小鹏的 XPACE 说得更直接,论文提出的核心洞见是,视频预测既能把异构经验连接到动作学习,又能生成新经验用于策略改进,实验是在自家 IRON 人形机器人上完成的。
潜空间预测派的人不多。除了零跑,VLA-JEPA、PALM 出自高校,JEPA-VLA 有**诺亚参与,产业方里走得最远的是创业公司智在无界的 Being-H0.7。
第三派不依赖世界模型,直接把真机数据规模做大。小米的 Xiaomi-Robotics-1 用了超过 10 万小时 UMI 采集的真实操作轨迹做预训练,配一条自动标注流水线。
小米和零跑正好站在这条轴的两端。一头是 10 万小时真机数据加 380 亿参数,另一方在论文里明确写着不需要大规模轨迹预训练。
理想还提供了一份可以当交叉验证用的材料。
它 7 月发布的 VLAFlow 是一项受控对比实验,在同一个 π0 式架构、同一个视觉语言骨干、同一个 14 维动作空间下,用约 5000 小时异构语料比较了四种预训练范式。其中的 MindWPI 做的正是未来潜特征对齐,也就是零跑这一派的核心机制。
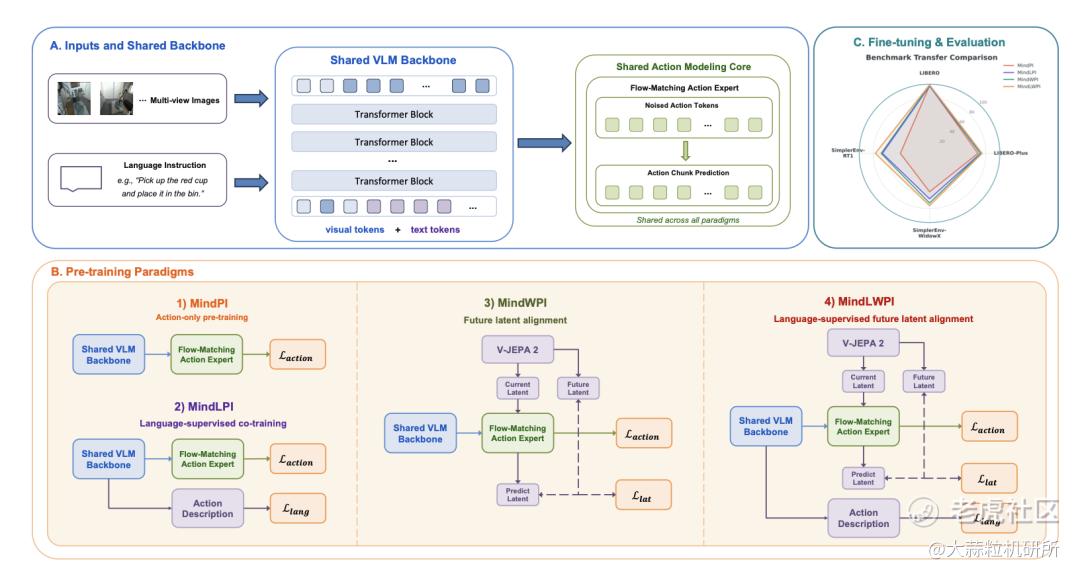
理想给出的结论是,未来潜特征对齐确实改善了状态转移和动作后果建模,但单独用的时候稳定性不够,和语言监督结合之后整体迁移表现才最好。
像素派内部其实也在权衡成本。
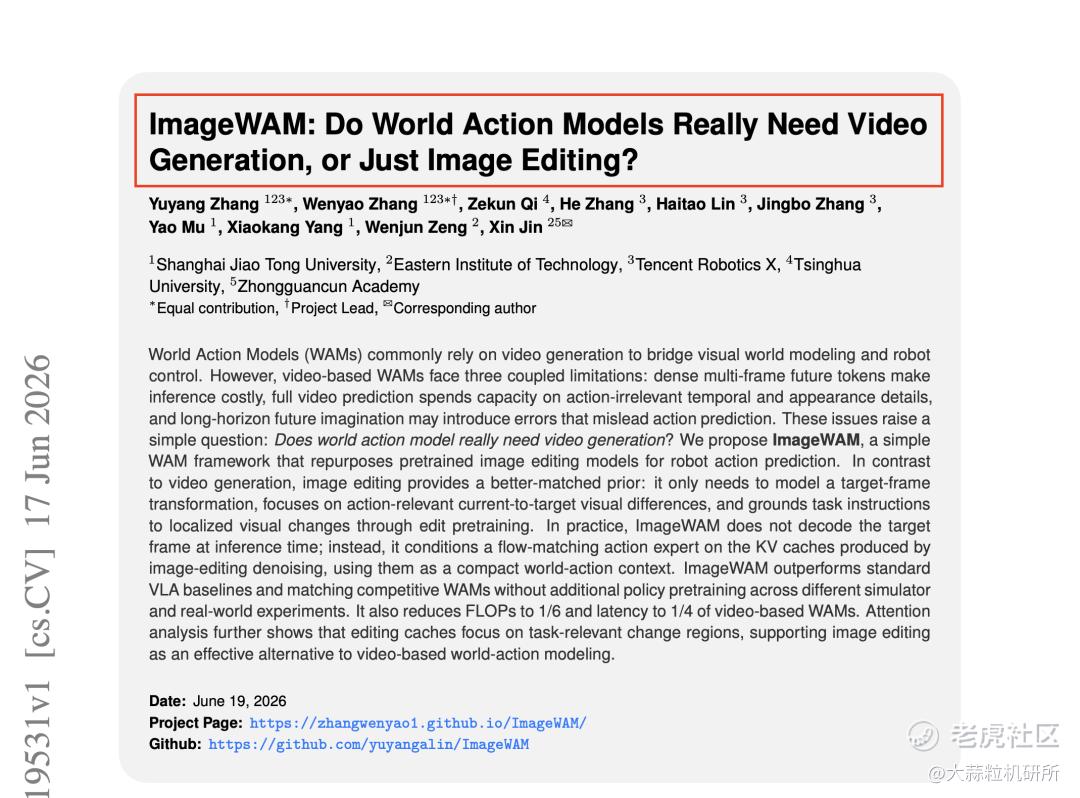
腾讯 Robotics X 参与的 ImageWAM 论文,标题是一个问句:世界动作模型真的需要视频生成,还是图像编辑就够?它和零跑的出发点一致,都认为生成开销太高,区别在于 ImageWAM 和 Fast-WAM 都已经在推理时跳过画面生成,零跑的不同在于训练时也不在像素空间学,从头到尾都在潜空间里。
六、进军具身,零跑想干什么?
我们再回到零跑自己的语境里,现在看这套取舍的动机就比较清楚了。
朱江明 2025 年 12 月底谈工厂自动化时给过一条标准,投入自动化设备必须能在三年内通过节省的人力成本收回投资,做不到就不做。这条标准决定了零跑的机器人从研发的第一天起就要开始算账。
账目的第一项是算力。零跑长期强调在成本受限的平台上部署智驾能力。论文没有说明 LeapBot-WA 的路线由成本目标直接决定,但把未来动态预测留在训练期、在推理时剪掉重分支,和零跑一贯的成本逻辑是一致的。
第二项是数据。LeapBot-WA 在 RoboTwin 上没做大规模机器人轨迹预训练,成绩仍超过了一部分做过预训练的模型。对一家不打算先砸钱采十万小时真机数据的公司来说,这比榜单上的名次更实用。
第三项是场景。工厂和仓库的扰动通常比开放服务环境更可控,零跑在视角泛化和抗噪能力上的短板,可以通过固定工位和环境管理部分规避。选这条路线不等于永久放弃通用服务市场,但至少说明零跑眼下优先考虑的是封闭场景里的成本和落地效率。
把这三个方面拼起来,我们会发现,零跑做机器人的逻辑和它做车是同一套,先用架构把成本压到能落地的位置,再等场景和本体价格往下走。
七、论文里的机器人,是一台买来的机械臂
按这个逻辑往下推,零跑现在应该已经在自家样机上验证了这条技术路线。但从这篇 LeapBot-WA 论文里,我们并没有找到蛛丝马迹。
LeapBot-WA 的真机实验用的是一台 UR5,优傲的标准协作机械臂,公开销售,谁都买得到。
论文第五张图里,这台 UR5 正在把香蕉和杨桃放进容器,论文拿这两种水果举例,一个是弯的,一个截面是星形,用来说明模型能处理形状不规则的物体。
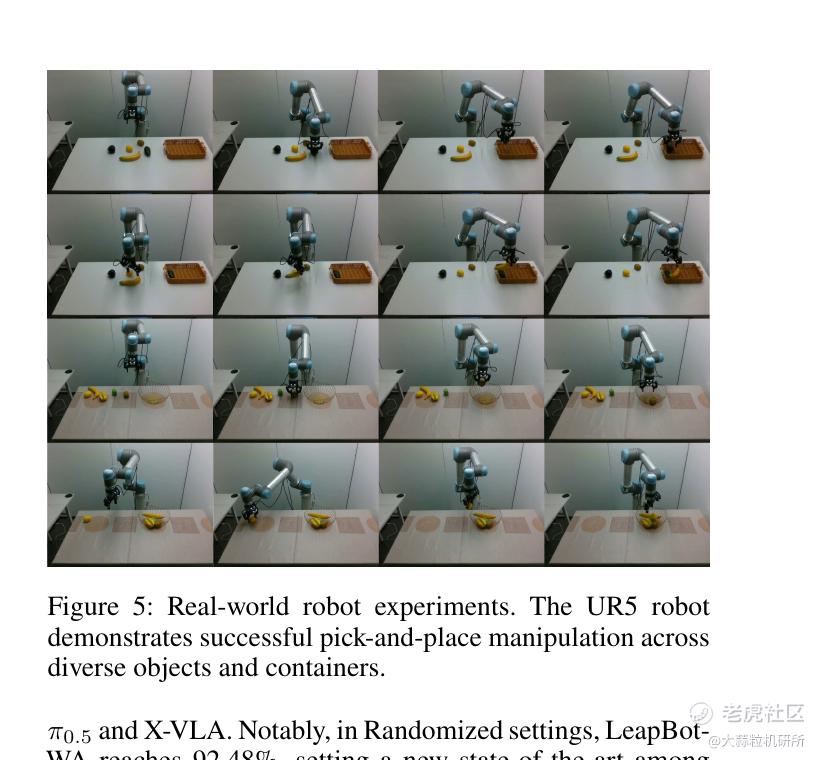
按照周洪涛和朱江明透露的,零跑的机器人样机已经研制完成,但这篇论文的实验对象并不是这台样机。
样机已经研制完成,真机验证却选了一台最常规的工业机械臂,是样机还没到能跑这套模型的状态,还是跑了但没写进论文,这是我们比较困惑的地方。
与此同时,论文对应的开源代码也没有放出。leapbot-wa 仓库建在 GitHub 的 LeapWM 组织下,两次提交,README 正文只有一句 comming soon(原文如此),既没有代码,也没有模型权重。论文 7 月 27 日上传,到现在将近两个月。同一个组织下还有一个 levelk-wam 仓库,一次提交,零星标,同样是空的。
这个阶段,同行们都干了些什么?
小鹏的机器人论文在自家 IRON 人形机器人上完成实验,小鹏机器人业务首轮股权融资超过 9 亿美元。9 月 8 日,小鹏宣布机器人生产线在广州启用,首台由该产线制造的 IRON 自主走下产线;官方最新信息是 2026 年底进入规模量产阶段,2027 年面向中国及海外市场上市交付。
小米的机器人从年初开始在自家汽车工厂实训,自攻螺母上件的成功率一个季度从 90.2% 提到 98%,Xiaomi-Robotics-0 完整开源。
但零跑目前公开可核验的机器人研究成果仍主要是这一篇论文,实验对象是一台商用 UR5 机械臂,GitHub 仓库写着「敬请期待」(comming soon)。
朱江明说能赚钱的机器人才拿得出手。
按他自己给的三年回本标准,那台已经研制完成的样机,可能现在还没有找到好的,能商业化的场景。
参考资料
零跑 2026 技术日朱江明现场发言与问答,2026 年 9 月 16 日
LeapBot-WA: World-Anchor Action Models via Predictive Latent Alignments,arXiv:2607.23969
DA-WAM: Decision-Aligned Future Latents for Driving World Models,arXiv:2608.19085
Xiaomi-Robotics-U0,arXiv:2607.11643;Xiaomi-Robotics-1,arXiv:2607.15330
XPACE,arXiv:2609.17372;AnyWorld,arXiv:2608.29242
VLAFlow,arXiv:2607.01586
ImageWAM,arXiv:2606.19531
LIBERO-Plus: In-depth Robustness Analysis of Vision-Language-Action Models,arXiv:2510.13626
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
