


网易LobsterAI发布《中国办公Agent用户行为报告》(9月版)
近年来,人工智能产业的快速发展离不开政策的保驾护航,省市级的政策“组合拳”正在为高性价比国产模型的普及扫清障碍。浙江省正积极推广算力券并将Token定位为价值新锚点,而杭州市级层面也已形成以“算力券+智能券”为核心的系统性支持框架。
这套从省级统筹到市级补贴的政策链条,系统性地降低了模型调用门槛,让用户能以更低成本享受高效模型带来的AI生产力。政策红利与产业趋势的交汇,也在最新的行业报告中得到了详实的印证。
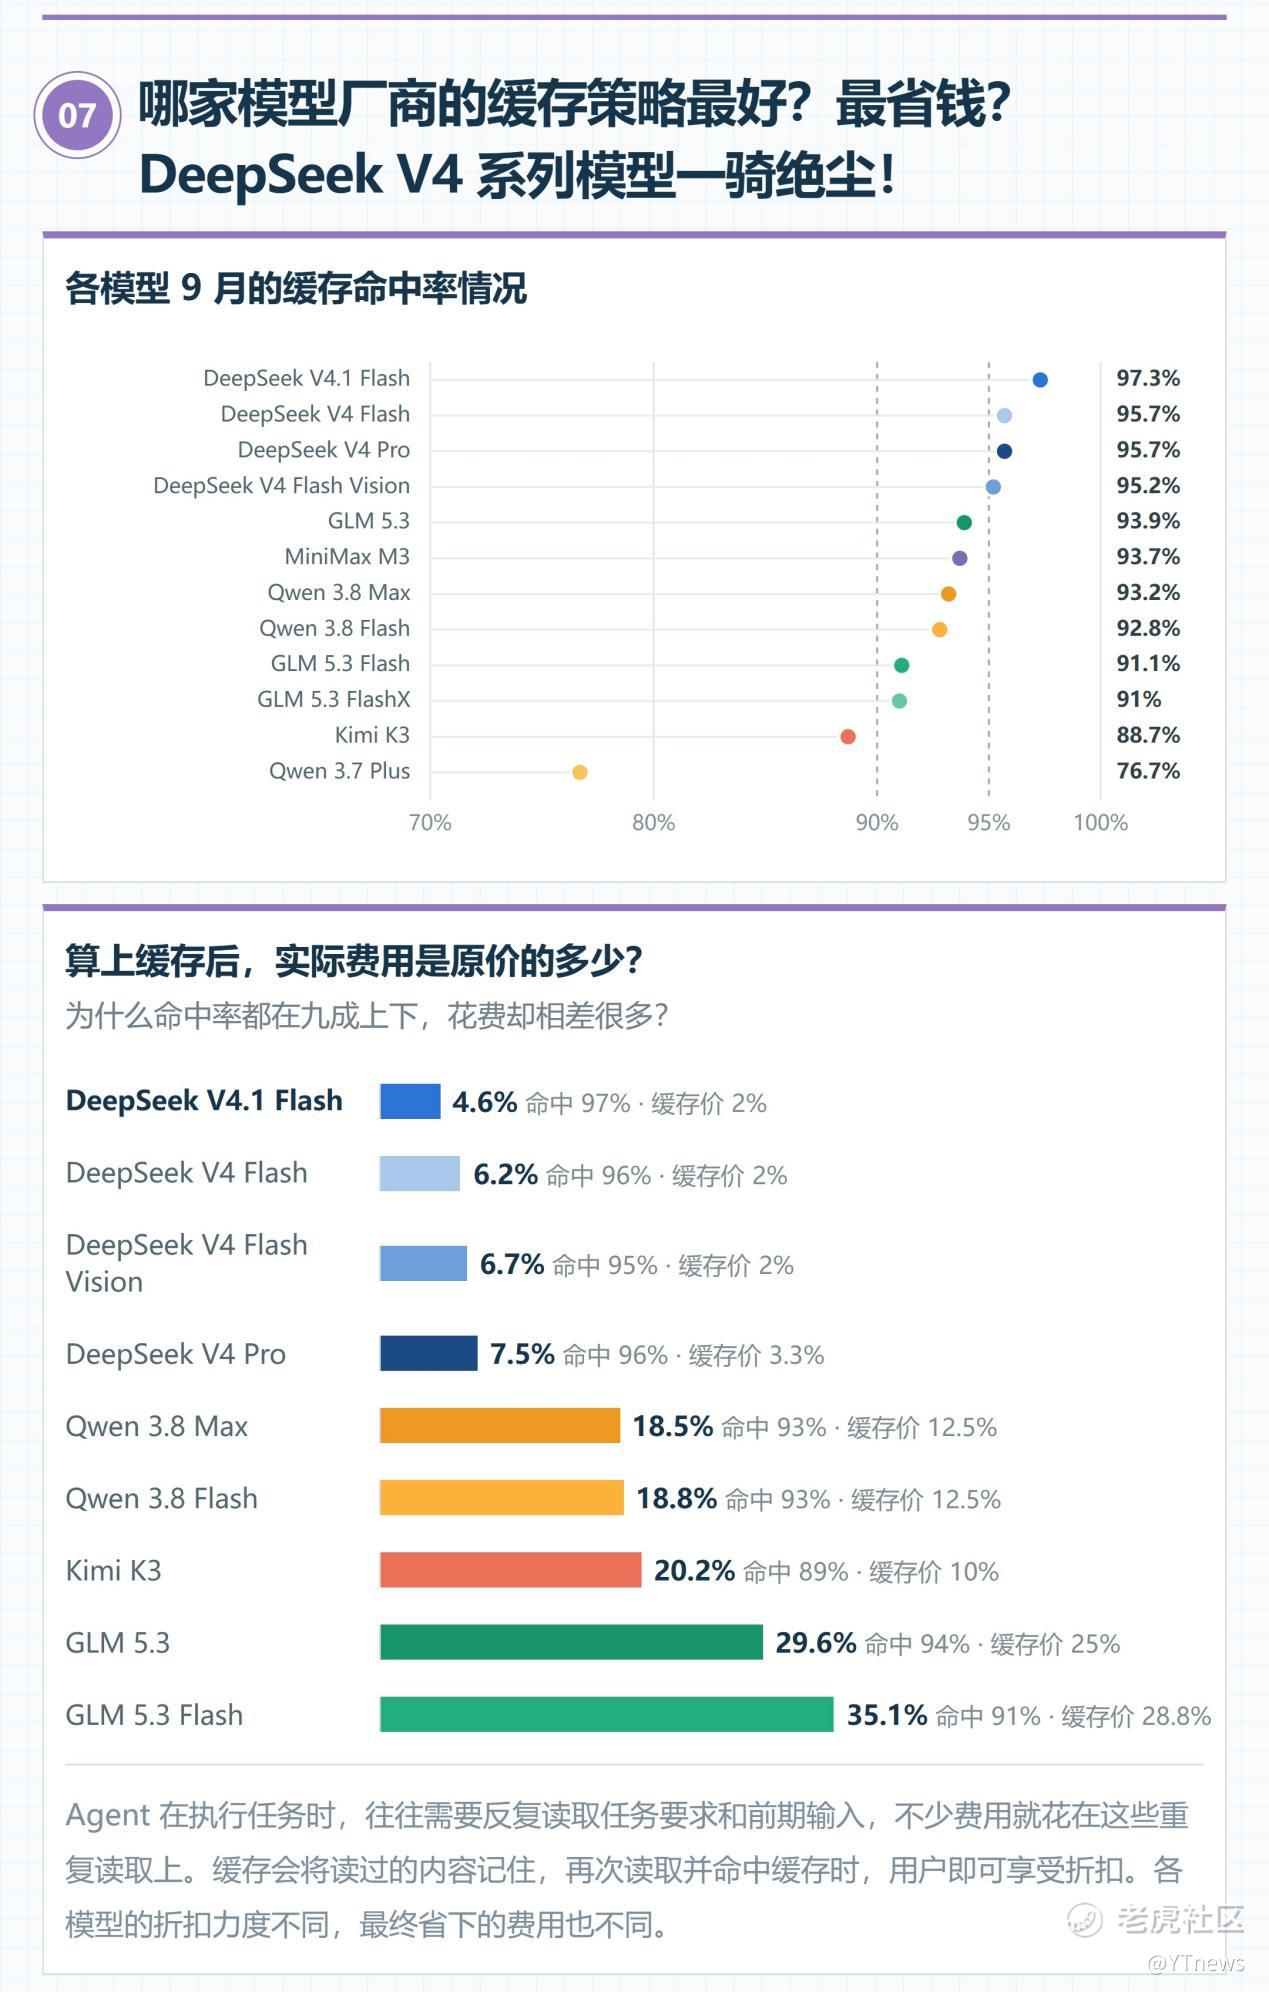
10月19日,“国内办公Agent四强”之一网易LobsterAI发布《中国办公Agent用户行为报告》(9月版),报告指出,作为扎根浙江杭州的本土AI领军企业,DeepSeek在办公Agent生态中展现出强劲的综合实力,不仅以Flash系列为基座的组合包揽了热门模型搭配Top5,更凭借V4系列超95%的超高缓存命中率,将实际调用成本大幅压缩。
值得关注的是,江浙沪地区正是这股AI生产力的活跃区域。报告显示,在活跃用户城市Top10中,上海以4.3%的占比居全国第二,杭州以3.2%的占比居全国第五。江浙沪的两座核心城市在活跃度上位居全国前列,展现出极强的区域AI生态活力,这也为本土领军企业提供了肥沃的落地土壤。
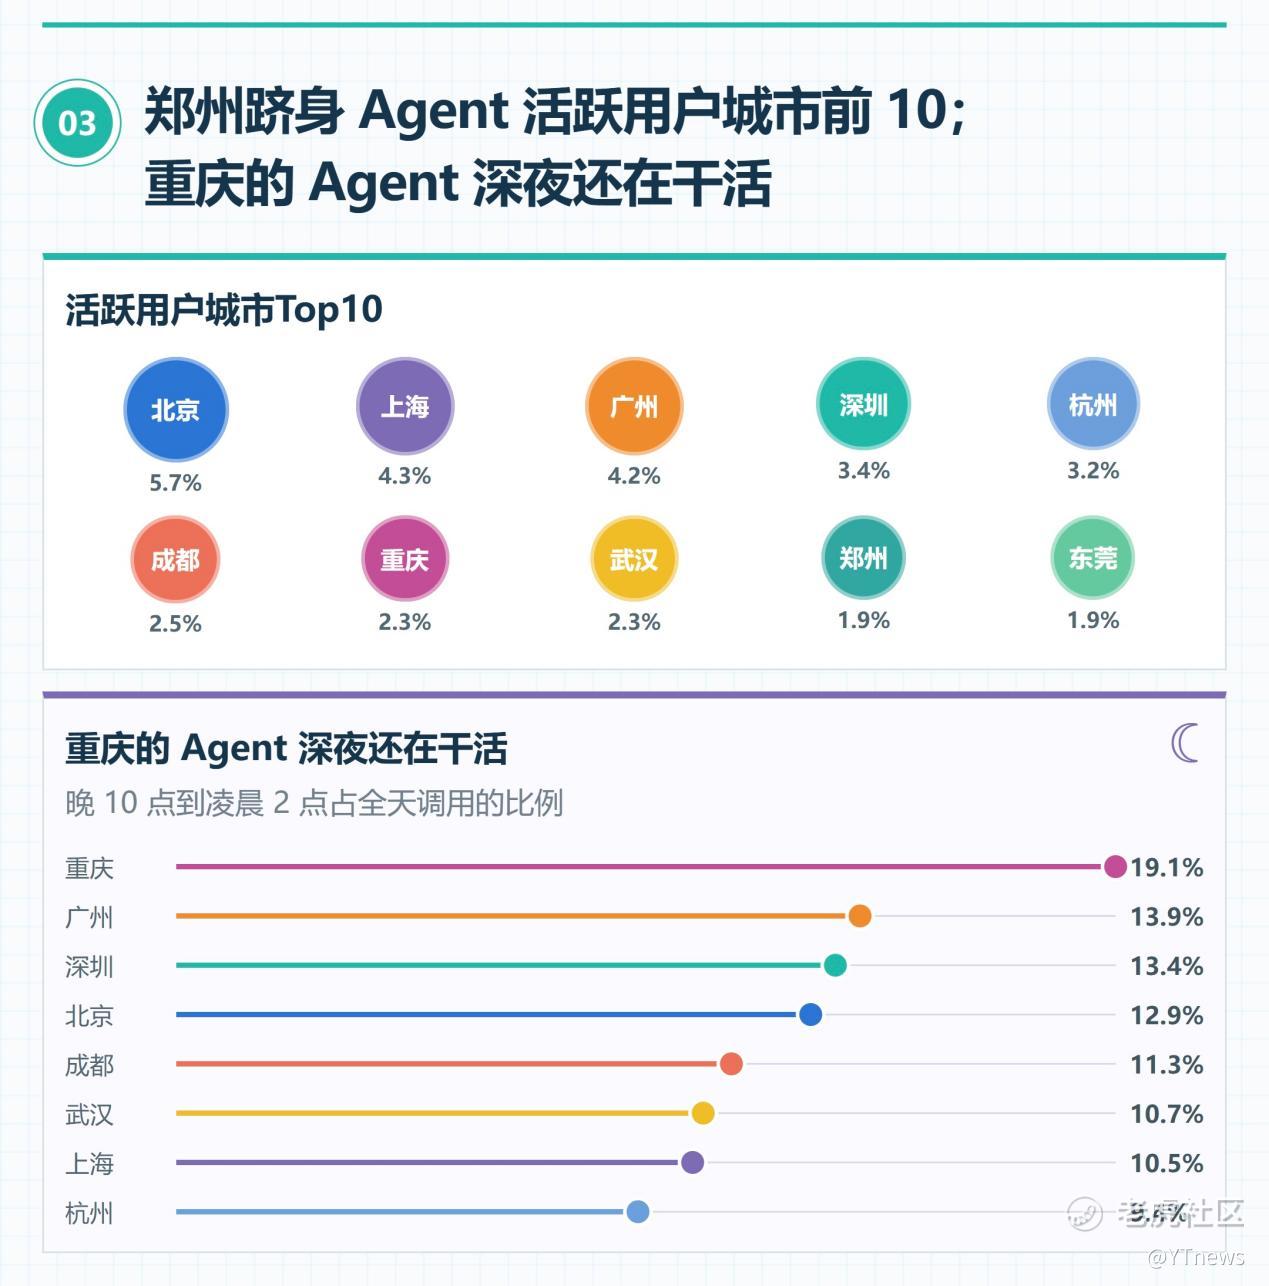
报告揭示了用户在办公Agent使用中的模型搭配偏好。数据显示,近七成用户日常仅使用一个模型,但重度用户更倾向于搭配更多模型使用,人均使用2.4个模型。在最常见的模型搭配Top5榜单中,以“DeepSeek Flash系列”为基座的组合包揽了全部前五名。其中,“DeepSeek Flash系列 + GLM 5.3 Flash”以14.0%的占比成为最受青睐的“黄金搭档”,“DeepSeek Flash系列 + V4 Pro”则以12.4%紧随其后。
这表明,DeepSeek已深度嵌入用户的日常办公流,尤其在上海、杭州等数字化程度极高的一线及新一线城市,已成为用户搭配其他模型应对复杂任务的核心底座。
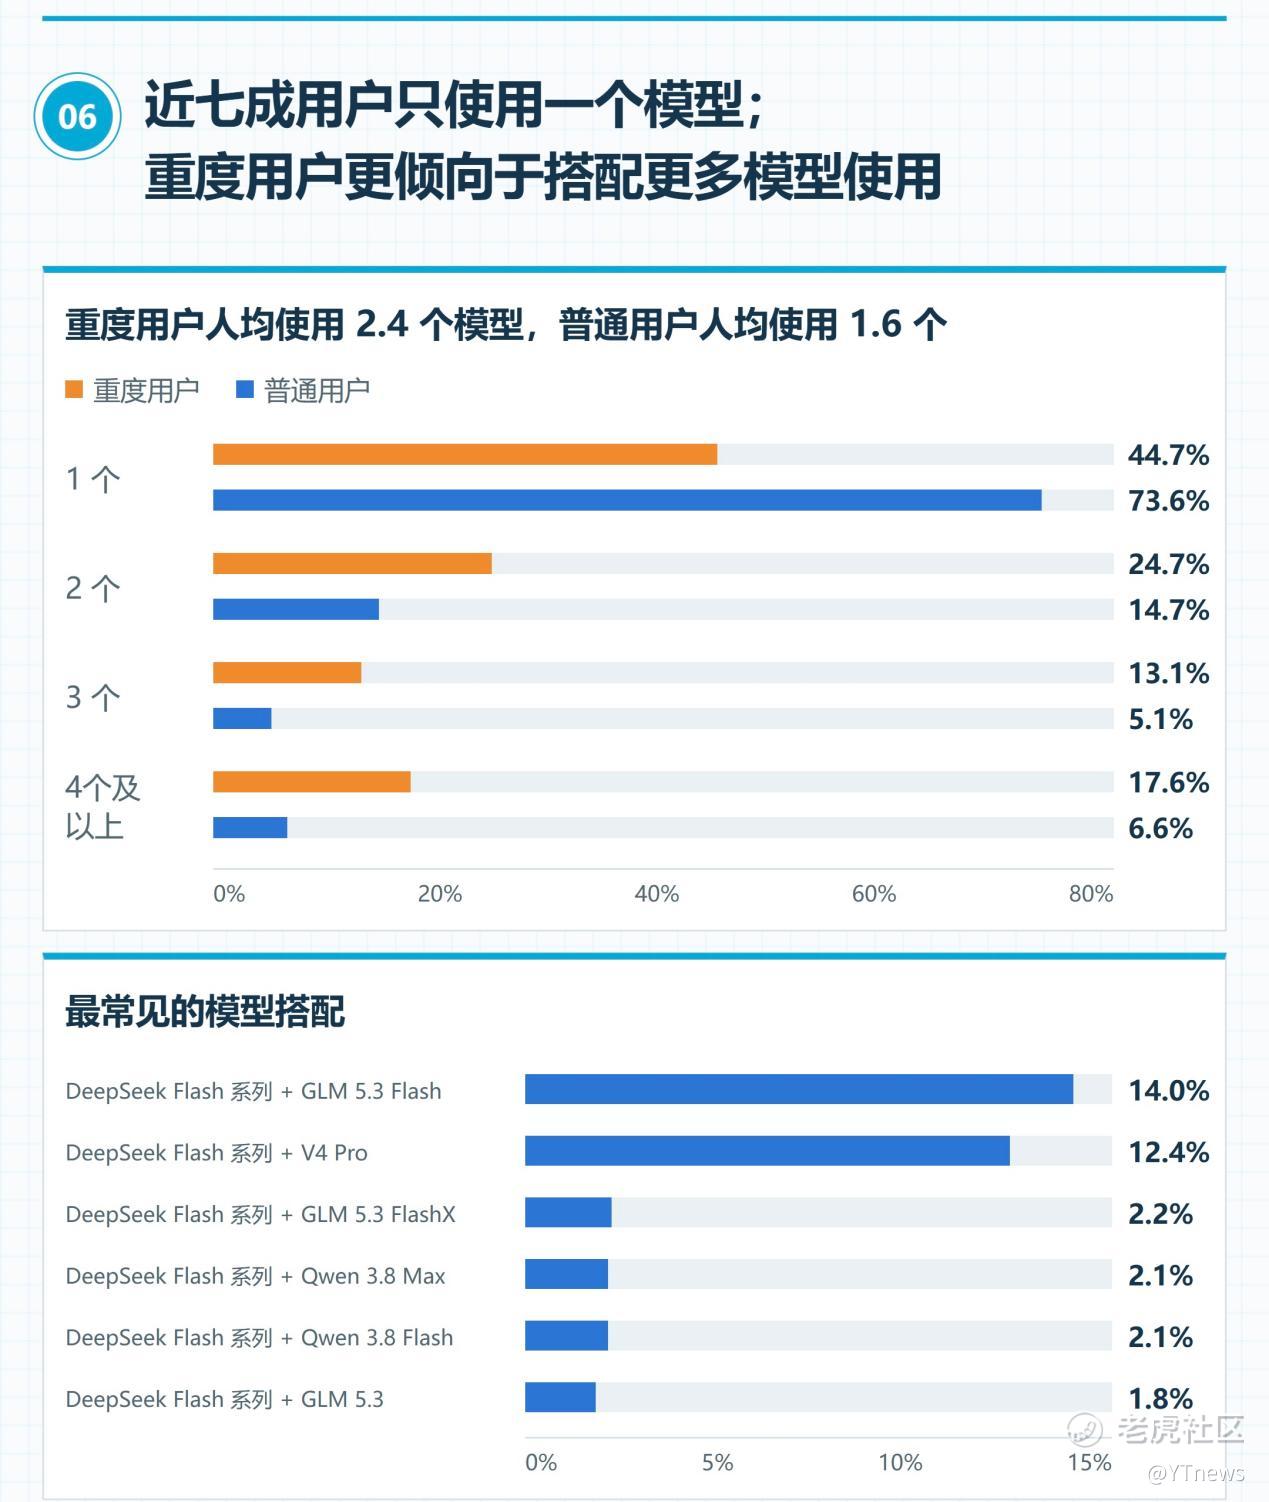
在用户高度关心的成本控制方面,DeepSeek V4系列凭借优越的缓存策略,成为名副其实的“省钱利器”。报告显示,DeepSeek V4系列9月各型号的缓存命中率均在95%以上,其中V4.1 Flash更是高达97.3%。由于Agent运行时常需反复读取长上下文,高缓存命中率意味着用户只需支付极少的增量费用。以DeepSeek V4.1 Flash为例,算上缓存后其实际费用仅为原价的4.6%。
相比之下,部分模型由于缓存命中率低,实际费用节省有限。高缓存命中率极大地降低了用户的日常使用成本,让“每次重跑都在读缓存”成为现实,真正惠及了广大用户。
作为继今年9月全国首份《中国办公Agent用户行为不完全报告》后的又一次系统性复盘,本期报告由国内办公Agent“四强”之一LobsterAI基于平台真实用户行为数据整理发布。
此前,LobsterAI第一时间完成了DeepSeek V4.1 Flash、DeepSeek V4 Pro、DeepSeek V4 Flash以及V4 Vision Flash等V4系列全系模型的API接入与底层优化,确保用户在Agent复杂任务流中能即刻调用前沿模型。
网易LobsterAI相关负责人表示,《中国办公Agent用户行为报告》显示,从早期的“算力向头部集中”到如今“场景全面开花、早晚高频交互”,国内办公Agent市场正稳步迈入成熟期。Agent不再仅仅是极客与开发者的专属工具,而是正在重塑每一个普通职场人的工作方式。
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
