DYLAN PATEL · RUNTIME 2026 · 演讲纪要
会议:Runtime 2026(Modal 主办)时间:2026 年 11 月 3 日,演讲时长 19 分钟演讲人:Dylan Patel,SemiAnalysis 创始人兼 CEO
一、纪要内容总结
关键数据
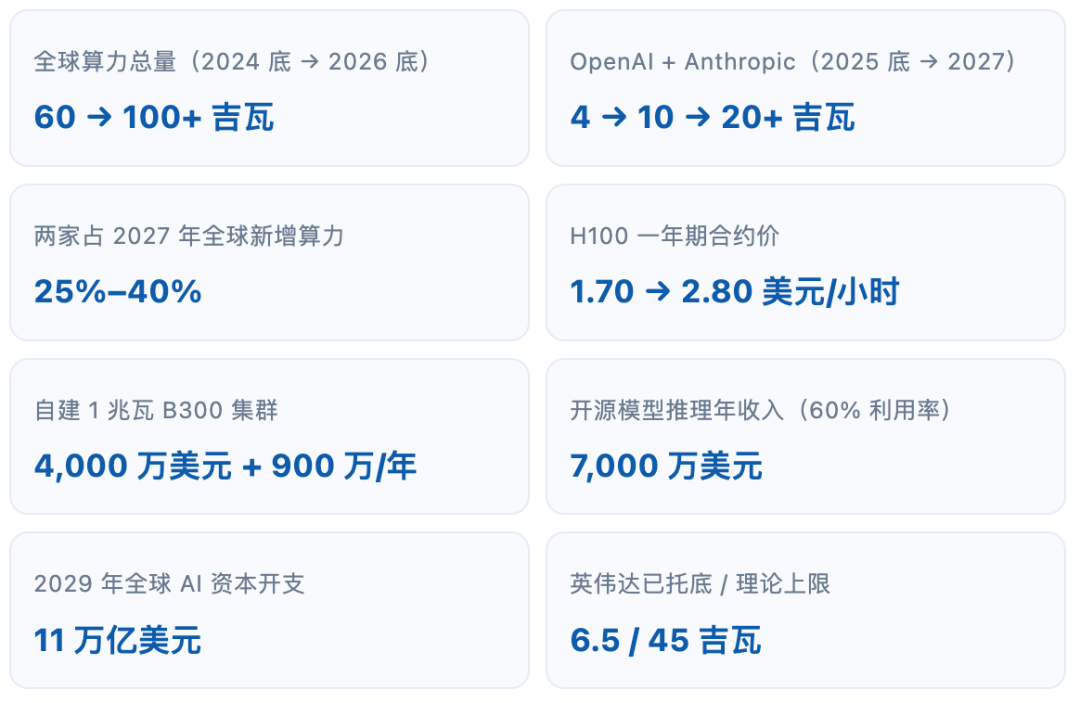
先把三张账摆在一起
这场演讲最有说服力的地方,是他把三个不同主体的账本放在了同一页上:建的人花多少、租的人付多少、卖 token 的人赚多少。三张账一对比,“算力荒”就不再是一个情绪词,而是一个可以用除法算出来的结果。
|
口径 |
数字 |
归属 |
|---|---|---|
|
自建 1 兆瓦 B300 集群 |
4,000 万美元前置 + 900 万美元/年 |
建设方(五年合计约 8,500 万) |
|
从云上租 1 兆瓦 |
最高 1,400 万美元/年 |
租用方(通常要预付、签 3–5 年) |
|
卖 DeepSeek V4.1 Flash(60% 利用率) |
7,000 万美元/年收入 |
运营方(年运营成本 900 万) |
|
卖闭源前沿模型(单一工作负载) |
1 亿美元以上 |
Anthropic,数字来自其 IPO 材料 |
这张表里藏着整场演讲的因果链。自建五年约 8,500 万美元,折成每年 1,700 万,比租的 1,400 万还贵——所以自建的理由从来不是便宜,是“租不到”和“不敢只签一年”。而只要 7,000 万美元的年收入对得上 900 万美元的年运营成本,接近 7.8 倍的覆盖倍数,租价涨到 1,400 万甚至更高都仍然划算。买家不是不理性,是他们算得比旁观者清楚。
核心要点
·全球算力两年翻倍,这是五十年一遇的斜率。 2024 年底全球装机(含 AI 与非 AI)60 吉瓦,2026 年底超过 100 吉瓦。他给的对照是:“我们花了 50 年才到 50,然后两年就到 100。”严格按算术,60 到 100 是增长 67%,说“几乎翻倍”是口语化的说法,但方向没有问题——过去半个世纪攒下的存量,这两年又被追平了大半。他特意点明这个统计包含非 AI 算力,正是为了防止被当成口径放水:这是真实发生的基础设施扩张,不是把边缘机房都算进来的数字游戏。
·增量里的三到四成,被两家公司订走。 OpenAI 与 Anthropic 合计:2025 年底约 4 吉瓦,2026 年约 10 吉瓦,2027 年超过 20 吉瓦——一年 2.5 倍、再一年 2 倍。拆成增量看,2027 年全球新增约 40 吉瓦,两家占约 12 吉瓦,即 25% 到 40%;区间之所以宽,是因为分子和分母都建立在签约合同的口径差异上。再往后,2028 年仅 AI 实验室一年就要新增约 30 吉瓦。这个数字是他从已签约的合同倒推出来的,不是让预测模型跑出来的。
·拐点是 Claude Code,不是 GPT。 Patel 把扫货的起点定在 2025 年底:“Anthropic 的收入随 Claude Code 起飞,于是开始疯狂买算力;Meta 开始疯狂买,OpenAI 也开始疯狂买。”三家公司几乎同时进入扫货状态,这是供给曲线被瞬间拉陡的直接原因。结果是今天“对很多人来说,已经买不到算力了”。
·训练吃掉了绝大部分,推理省得不成比例。 Claude Code 的全部负载只由 1 吉瓦在服务,而 Anthropic 手上是 4 吉瓦。原话是“相对于训练,它们在推理上花的算力少得惊人”——四分之三的算力不在服务用户。推论很硬:即使终端需求走平,实验室训练下一代模型的预算仍会继续占住芯片,租金没有下行的理由。这也解释了为什么“推理需求见顶”这类判断短期不会体现在租金上:租金由训练预算定价,不由日活定价。
·H100 一年期从 1.70 涨到 2.80,涨幅 65%,而且长约反而更贵。 去年 10 月是低谷,H100 每小时 1.70 美元,差一点的云能到 1.45 甚至更低。现在成交区间 2.40 到 3.20,中位 2.80,区间宽度就有 0.80 美元——说明这是一个连报价都不统一的市场。两年前签 2.80 美元一年期会被认为疯了,现在是抢着签。
·自建 1 兆瓦的账:4,000 万前置,加每年 900 万运营。 这是 B300 集群的价格;从云上租,1 兆瓦一年可以付到 1,400 万美元。把这组数字做除法会发现一件反常识的事:自建五年合计约 8,500 万美元,摊到每年 1,700 万,比租还贵。所以自建从来不是成本选择,是可得性选择——要自己拿贷款、要等 3 到 9 个月交付,换来的是一块不会被别人收回的算力。
编者注:原话只说“建这个集群 4,000 万美元”,未点明容量;按后文“租 1 兆瓦一年 1,400 万美元”的对照,SemiAnalysis 的口径是 1 兆瓦级 B300 集群。
·开源模型推理的毛利,高到让租价失去意义。 服务 DeepSeek V4.1 Flash、60% 利用率,一年收入 7,000 万美元——而五年里的运营成本才 900 万一年,覆盖倍数接近 7.8 倍;即便利用率掉到 30%,收入砍半到 3,500 万,仍然是 3.9 倍。“如果你能找到每小时 6 美元的 B300,就该签下来卖 token。”这句话解释了租价为什么还在涨:不是实验室在扫货,是所有拿到卡的人都想自己卖 token,而他们的毛利足以支撑更高的出价。价格的上限由这批人的边际收益决定,不由成本决定。
·闭源侧是另一个量级:单个工作负载 1 亿美元以上。 Anthropic 服务 Fable 或 Opus 5.5 时,规模超过 1 亿美元,数字来自其 IPO 过程中披露给投资者的材料。这个对照解释了整条链的利润分配:卖开源 token 是套利,卖闭源前沿模型是资本密集的重资产生意,两者对算力的饥饿程度完全不同——前者可以按需进退,后者一步踏错就是几十亿美元的沉没成本。
·2029 年全球 AI 资本开支 11 万亿美元,其中 6 到 7 万亿是债。 拆分是 5 万亿现金与股权、6 到 7 万亿债务。按四年摊,等于每年往这个行业里投 2.75 万亿美元,其中约 1.5 到 1.75 万亿要靠借。过去两个月美国 10 年期收益率疯涨、市场一度混乱,他把两件事直接挂钩:为数据中心和电力发债,正在给债务市场加压。这是他全篇唯一一处把微观租金和宏观利率焊在一起的地方。
·100 兆瓦扩到 1 吉瓦,卡的不是电,是信贷。 唯一的过法是把这 1 吉瓦先卖给某个超大规模云,再由那家云对债市说“这是微软在跑、这是谷歌在跑”,贷款才批得下来。代价是这批算力彻底不进入公开市场——融资动作本身消灭了它本来要服务的市场。2027 年已签约的算力里,约 65% 到 70% 流向超大规模云与 AI 实验室,剩下三成才留给所有人分。
·英伟达在做影子银行,三种托底结构里第二种最赚钱。 第一种是软银能源:只担保土地、电力、外壳,俄亥俄 9 吉瓦的设施 2030 年上线,但整块划给 OpenAI,“除非 OpenAI 破产,没人碰得到”——担保的是建设风险,不是市场需求。第二种是 Firmus:英伟达保底租价,让 Firmus 不赚不亏、由此拿到贷款;超出保底价的每一美元每小时,英伟达抽走一半。Patel 的评价是“很荒谬的套利动作,我很喜欢,非常聪明”——英伟达承担的是价格风险,换走的是超额收益的一半。第三种是残值担保,他没时间展开,但名字已经说明了它保的是什么:五年后这张卡的残值。
·创业公司现在的处境:先付一半,等 3 到 9 个月。 他给的现场描述是:“你去租集群,对方让你今天先付一半,然后告诉你 3 个月、6 个月、9 个月后才到货。”这句解释了为什么“自建”在 2026 年成了一种潮流——做推理的 Fireworks、Modal 都在试着自建,一批刚融到大钱的 neolab 也在自建。不是因为自建更便宜,是因为在公开市场上买不到确定的交付日期。融资能力正在替代技术能力,成为这一层公司的核心竞争力。
·6.5 吉瓦已托底,上限 45 吉瓦,仍是杯水车薪。 这是英伟达目前包销、托底、并准备卖向公开市场的量,而不是只卖给实验室和超大规模云的那部分。按他自己给的斜率推算——2027 年新增 40 吉瓦、2028 年 30 吉瓦以上,到 2030 年四年累计新增至少 120 吉瓦——45 吉瓦的上限大约相当于其中的三分之一,而现在做到的 6.5 吉瓦只占 5% 上下。收尾他给的画面是 token:少数几家供应商每天 100 万亿以上,“希望它们能拿到算力,否则我们都会成为 Anthropic 和 OpenAI 的奴隶”。
二、纪要内容原文
演讲全文(19 分钟,逐字)
Dylan Patel: 今天想讲的是算力、资本,以及到底谁能把它交付出去。先简单说一下 SemiAnalysis 是做什么的,我们覆盖整个产业链:有人做过 ASML 的设备、Lam Research 的设备,有人在晶圆厂做过研发,有人在英伟达这样的公司做过芯片设计,有人在微软、亚马逊、谷歌这些超大规模云做过基础设施,有人做过编译器,也有人在特斯拉这样的地方训过模型。覆盖的东西很杂。除了在网上胡说八道,主要生意其实是卖数据——我们追踪全球每一座数据中心、每一座电厂、每一座晶圆厂、每一台设备、每一条海缆。
Dylan Patel: 另外我们做很多测试。ClusterMax 就是给所有云打分:安全、生命周期、网络性能、存储性能都测。还有 InferenceX,完全开源,测各种芯片——英伟达的七种 GPU、AMD 的三种、TPU,甚至 OpenAI 的自研芯片,跑各种开源模型,扫各种并行配置、prefill 与 decode 分离、推测解码。它每天在全球 2,000 张芯片上跑,接下来几个月会把 Trainium 加进来。
Dylan Patel: 我们还建了实验室,在俄勒冈,做芯片逆向。一层一层剥,拍高分辨率照片,拆解架构、看晶体管结构。左上角是英特尔的 18A 和三星的 2 纳米——最好的那家大家都知道,问题是三星和英特尔落后多少。我们手上光电子显微镜、P-FIB 这类设备就值几千万美元,用来表征和追踪芯片架构。再往上一直做到 token 经济学:谁在卖 token、买家是谁、成本多少、毛利多少。六年了,从我一个人、自己掏钱开始,现在 115 人,挺疯的。
Dylan Patel: 今天讲算力竞赛。过去一年试过买卡、租卡的人都知道有多紧。原因是 OpenAI 和 Anthropic,主要是这两家,它们在把市面上所有东西买空。看全球算力的总量——含 AI 和非 AI——2024 年底是 60 吉瓦,到今年底已经超过 100。两年几乎翻倍,这个速度很惊人:我们花了 50 年才到 50,然后两年就到 100。
Dylan Patel: 需求主要是 AI 实验室驱动的。去年底,Anthropic 和 OpenAI 加起来大约 4 吉瓦;今年大约 10;再下一年超过 20。它们吃掉的是增量里非常大的一块。2027 年,两家合计新增约 12 吉瓦,而全球只新增约 40 吉瓦——它们占新增的 25%、30%、40%。再把超大规模云叠上去,局面就非常严峻。去年底 Anthropic 的收入随 Claude Code 起飞,于是开始疯狂买算力;Meta 开始疯狂买,OpenAI 也开始疯狂买。现在对很多人来说,已经买不到算力了。
Dylan Patel: 2028 年,从我们看到的签约情况看,光是 AI 实验室一年就要新增 30 吉瓦左右。增量之大有点离谱。还有一个有意思的点:训练和推理的钱分得极不均衡。你会以为大部分花在推理上,实际上它们主要花在训练。Claude Code 的全部负载只由 1 吉瓦的算力在服务,而 Anthropic 今天有 4 吉瓦。相对于训练,它们在推理上花的算力少得惊人。
Dylan Patel: 回到算力价格。10 月是低谷:H100 每小时 1.70 美元,最低能到 1.45,如果你找的那家云很烂,还能更便宜。现在看到的成交价高到 2.40 到 3.20,中位 2.80。我们有一部分生意是算力经纪,所以对真实成交价比较有把握;再加上跟很多公司关系好,他们会告诉自己付了多少。价格涨得非常猛。去年 12 月我们说过算力价格要涨,但涨幅还是超出预期。
Dylan Patel: 就算 2.80 美元一年期的 H100,两年前签这个价你会觉得疯了,现在是大家抢着签。价格还在涨。一年、三年、五年——现在很难买到一年期的,这对创业公司很难受:我不知道自己一年后还在不在,我只能买一年。所以这是个非常难的市场。
Dylan Patel: 原因是所有人都想卖 token。买和运营一座集群:建起来 4,000 万美元,五年里每年运营成本约 900 万。这是自建 B300 集群的成本。如果从云上租,一座兆瓦一年能付到 1,400 万美元就算走运。然后看卖开源模型意味着什么:服务 DeepSeek V4.1 Flash,60% 利用率——只卖出你能生成的 60% 的 token——一年收入 7,000 万美元。这个利润率荒谬。
Dylan Patel: 这是基于我们开源的 InferenceX agent 基准跑的,容器可以直接下载运行,底层是 vLLM 和 SGLang。所以哪怕你说利用率只有 30%,你仍然会赚一大笔。小规模跑推理并不难。一旦到了模型那个规模——25 家云、在它们之间路由——基础设施上就难得多。但我认识几十个人,生意就是租一批 GPU、跑推理、赚很多钱。
Dylan Patel: 所以一部分可以怪实验室把算力买空,但很大一部分原因就是开源模型推理太赚钱——这还没算上那些真正会跑推理的公司用的推测解码之类的东西。我们四个工程师开源的基线就够赚了。这就是价格持续上涨的原因。如果你能找到每小时 6 美元的 B300,你就该签下来卖 token——这个价格是疯,但这是正确的决定。当然所有云都要你预付,这让难度大很多。
Dylan Patel: Anthropic 服务 Fable 或者 Opus 5.5 的时候,单个工作负载是 1 亿美元以上。这是观察到的数字,在他们 IPO 过程中给投资者的材料里。差距是巨大的。所以即便闭源实验室也不是价格飙升的唯一原因。看价值被谁拿走了——基本全是 token 提供方。所以云厂能推价,而且坦白说,它们还能推得更狠。H100 冲到 3 美元以上、B300 冲到 7 美元以上,我都不会意外,因为开源模型越来越好、盈利越来越好。GLM 5.3、DeepSeek V4.1,这些还不算大的,大的还在后面。
Dylan Patel: 关键问题是:谁能真正把算力交付出来。我们做了 ClusterMax 给所有云排名:追踪 323 家、实际审了 77 家、发了 19 枚勋章。意思是 CoreWeave 和 Nebius 是我们眼里最好的。CoreWeave 未来 6 个月不会卖给你算力,售罄了。Nebius 要你预付一整年或半年、价格还很离谱,但这是唯一能从那拿到算力的方式。Oracle、Google 也很好,Google 一路在升。第一次 ClusterMax 它是铜牌,然后一路往上。但也有大量降级:我们一直在抬高标准。
Dylan Patel: ClusterMax V3 里,我们让一些模型去黑这些 neocloud。有不少存在互联网上已经公开的漏洞,模型直接找到并利用,访问到其他客户的存储。甚至有一次,我们让一个开源模型——水平还不如 OpenAI 和 Anthropic 的——拿到了整个集群的 Slurm 权限以及很多别的东西,能看到某个国家国防工业、包括其国家安全和情报机构的作业名。我们立刻收手了,因为 SemiAnalysis 没人在那个国家,没人想坐牢。我们马上就说:这太离谱了。
Dylan Patel: 我们发了篇文章叫《大多数 neocloud 的安全很烂》,然后 Ilya 就发了一大通议论,说 AGI 会接管 neocloud,除非这些云把安全做好,否则我们无从自救。不管怎样,标准里很大一块是安全,但也有网络性能、存储性能、生命周期、托管 Kubernetes 做得怎么样等等,几十项。欢迎大家去读报告,完全免费公开。
Dylan Patel: 升级的说完了,降级这边:Azure 降到银牌,Crusoe 降到铜牌,Together 降到铜牌,AWS 降到铜牌。你可能会想,AWS 怎么会是铜牌?结果是要拿到一个集群,你得跟 10 个人谈,流程拖很久,网络也不太好打交道,用户体验就是不容易。他们的 HyperPod 做得不怎么样。我们还做故障注入:插 XID 719,英伟达的一种错误,然后看云多久能发现。很多云直到你去通知它才发现;很多云,即使你通知了,也要几天才响应。这是最低标准——GPU 会坏,你告诉云,它应该修;事实上它应该自己监控到并且自己修。
Dylan Patel: 另一个问题是钱从哪来。我们说过,到 2029 年底,全球 AI 资本开支预计 11 万亿美元,其中 5 万亿来自现金和股权,7 万亿来自债务。对大多数人这是个荒谬的数字。这是我们的看法,已经有一段时间了;而过去两个月,如果你看债务市场,美国 10 年期收益率疯涨,市场一片混乱。
Dylan Patel: 上线的资本开支极其庞大。大部分是芯片本身,但也有很大一块是数据中心、能源、建在数据中心旁边的电厂——为了能更早上线。另一个方面是放贷的人怎么做。看债务的价格,一年前便宜得多,往后越来越贵。所有这些 neocloud 都想建更多算力,它们非常赚钱,但如果它有 100 兆瓦、现在想扩到 1 吉瓦,谁来借钱给它?唯一能拿到贷款的方式,是把这 1 吉瓦卖给某个超大规模云;然后那家云再转身对债券市场说“这是微软在跑、这是谷歌在跑”,好,你拿到贷款。但那些算力就一点也不会流向公开市场。
Dylan Patel: 所以大家在想办法,让算力不要全部流向 AI 实验室和超大规模云。因为明年看所有已签约的算力,大约 65%、70% 是给超大规模云和 AI 实验室的。而随着利率上升、只有少数人有能力撑住资产负债表,这个局面只会更糟。
Dylan Patel: 看英伟达在做什么,非常有创意。这张图信息很多,大家可以拍张照放大看。但根本上,英伟达意识到这是个大问题:我们都希望创业公司创新,都希望人们能自己搭 AI 方案。如果你作为创业公司去租集群,对方会让你今天先付一半,然后告诉你 3 个月、6 个月、9 个月后才到货。去问任何一家最近融了一大笔钱的 neolab,拿到算力对它们来说就是地狱。所以英伟达开始说:我们给你的集群托底。如果你是云、要建一个集群,可以给我们一部分收入分成,然后你可以拿我们的名字当价格下限去拿贷款;或者用别的方式。
Dylan Patel: 于是英伟达的资产负债表上堆满了算力承诺,因为这是开放生态拿到算力的唯一方式。否则没人会为他们建这些算力——没人会借钱给你建集群,除非有一个资产负债表极强的人在背后撑着。这就是那个严峻的局面,英伟达在出手帮忙,但还需要更多有创意的解法。所以你会看到很多公司在自建集群:做推理的 Fireworks、Modal 这些,都在试着自建;很多 neolab 也在自建。因为唯一的路就是自己去拿贷款、让英伟达背书、自己建。否则处境太难。
Dylan Patel: 那 1 吉瓦要花多少钱?这很重要。看这些担保,他们做了几种不同的交易。第一种是跟软银能源做的,只担保土地、电力和外壳。软银能源在俄亥俄建的这个 9 吉瓦的设施,大概 2030 年上线。但整块是划给 OpenAI 的,所以除了 OpenAI 破产,没人能碰——而那看起来不太可能。真破产了,我们就都完了。
Dylan Patel: 第二种是 Firmus,一家澳大利亚、新加坡公司,在澳洲建很多数据中心。做法是英伟达担保:“你建,我们按这个价格租。”这个价格基本让 Firmus 不赚钱,但也不亏钱;有了这个保证,就有人愿意借钱给这个集群。而超出这个价格之后,每卖出一美元每小时,英伟达拿走一半。这是很荒谬的套利动作,我很喜欢,非常聪明。只要 AI 继续走——我认为会——Jensen 会赚很多钱。
Dylan Patel: 还有别的,残值担保我大概来不及讲了,只剩 45 秒,但值得去查一下,很有意思。把托底放到全局看:英伟达目前对 6.5 吉瓦的算力做了托底、包销,这些会卖向公开市场,不只是卖给实验室和超大规模云。它最多能做到 45 吉瓦。即便到那个量,相对 2030 年前要部署的总算力,也只是一丁点。所以局面还是有点严峻。
Dylan Patel: 最后总结:token 是价值流动的方式。光少数几家供应商,每天就有 100 万亿以上的 token。这些公司的 ARR 在飙升,都在大量融资、大量创收。希望它们能拿到算力——否则我们都会成为 Anthropic 和 OpenAI 的奴隶。
本文为 2026 年 11 月 3 日 Dylan Patel 在 Runtime 2026(Modal 主办)演讲的中文纪要,本文不构成投资建议。
精彩评论