2026 年秋天,大模型在经历同一个动作。衡量它的单位从参数、从榜单名次,一路滑到"每百万 Token 多少钱",还在往下滑。十月中旬这半个月里,三家国产厂商先后把输入价顶到 1 元一百万 Token 这个刻度上。到了这个刻度,争论一个模型贵不贵已经没什么意思了,真正留下来的那个问题是:一件活干完,要烧掉多少钱。
10 月 19 日晚上,不少开发者的模型路由表被动了一下。OpenRouter 榜首挂了两周的匿名模型 Space Bunny 摘下面具,露出 MiniMax M3.1 Flash 的名字。
四天后,MiniMax 开源了这个模型的权重,同时给出一个数字:上线 72 小时,真实用户跑掉 100 万亿 Token。
100 万亿不好想象。它大概相当于把公开可抓取的中文文本来回过好几遍,也相当于一家公司在四天里替全球开发者垫下一整个季度的算力。更值得留意的是这些 Token 的来路,其中大部分来自付费调用和真实工作流,这一点很重要。
先跑了200万亿Token,M3.1 Flash才肯摘下面具
M3.1 Flash 的登场方式,和行业惯例是反着来的。
在认领身份之前,Space Bunny 已经在 OpenRouter 上连续 10 天霸榜,匿名期间累计处理 56.7 万亿 Token;在 OpenCode 上连续 12 天第一,累计 106 万亿 Token。Cline 在发布当天就完成了支持,Ollama、GMI Cloud 同步上线,开源个人助手框架 OpenClaw 从 v2026.10.1 版本起原生支持。加上各平台的暗测流量,这只"太空兔"在还没有名字的时候,已经消化掉了超过 200 万亿 Token 的真实任务。
当它拿出来的第一批公开数据,天生就带了一层外部背书。大模型发布的标准动作是先发技术报告和跑分,再上产品,中间那道"到底好不好用"的验证留给用户自己做。MiniMax 把顺序倒了过来,先让模型披着马甲进别人的竞技场,被全球最挑剔的一批开发者用真实任务蹂躏半个月,再出来认领。
往深看一层,这种做法对 Agent 模型的价值尤其大。跑分能测出一次回答对不对,测不出跑到第三十轮时模型会不会搞乱上下文、误删文件、在工具调用里打转。200 万亿 Token 的野外里程,补的正是这一块。
一元钱的价格标签下,藏着一个忙时价
定价是这次最响的一声锣。按每百万 Token 算,M3.1 Flash 输入 1 元、输出 4 元、缓存读取 0.1 元,海外对应 0.15 美元、0.60 美元、0.015 美元。和 M3 相比,输入输出单价都降了一半以上,缓存读取降了七成多,官方口径是 Agent 类任务综合成本下降约 70%。
真正有信息量的比较在对手那边。DeepSeek V4.1-Flash-1017 的标价同样是 0.15/0.60 美元,但它分峰谷:工作日 UTC 01:00–04:00 和 06:00–10:00 是忙时,价格翻倍到 0.30/1.20 美元。换算成北京时间,是上午 9 点到 12 点、下午 2 点到 6 点,正好是中国开发者坐在工位上的时段。国内社区里那句调侃把两位创始人的名字编进了报价单,说的就是这件事。
只看标价容易误判。一家公司在北京时间上午十点跑批量 Agent 任务,用 MiniMax 是 0.15 美元,用 DeepSeek 是 0.30 美元,成本差了一倍。MiniMax 还明确不设长上下文阶梯附加费,8K 和几十万 Token 一个价,对动辄把整个代码仓库塞进上下文的编码 Agent 来说,这一条比降价本身更实用。
缓存这一项要单独算。DeepSeek 的缓存读取是 0.003 美元,比 MiniMax 的 0.015 便宜一个量级,重度复用 System Prompt 和仓库索引的团队,账得自己拉一遍才算的清楚。
Flash 这一档的价格战,已经从"谁标价低"打到了"谁的计费结构更平直"。这是个更硬的战场,标价可以跟,峰谷机制和阶梯费背后是实打实的调度与工程能力。MiniMax 这次提到的 Power-aware scheduling,看起来就是冲这个去的。
把几张榜单摆在一起看,M3.1 Flash赢在哪
现在大模型榜单一天一换,单比谁的分数高,意义其实有限。M3.1 Flash的打法是把竞争拉到自己擅长的维度——完成一次任务的总成本。
这个判断有没有依据?看公开数据。
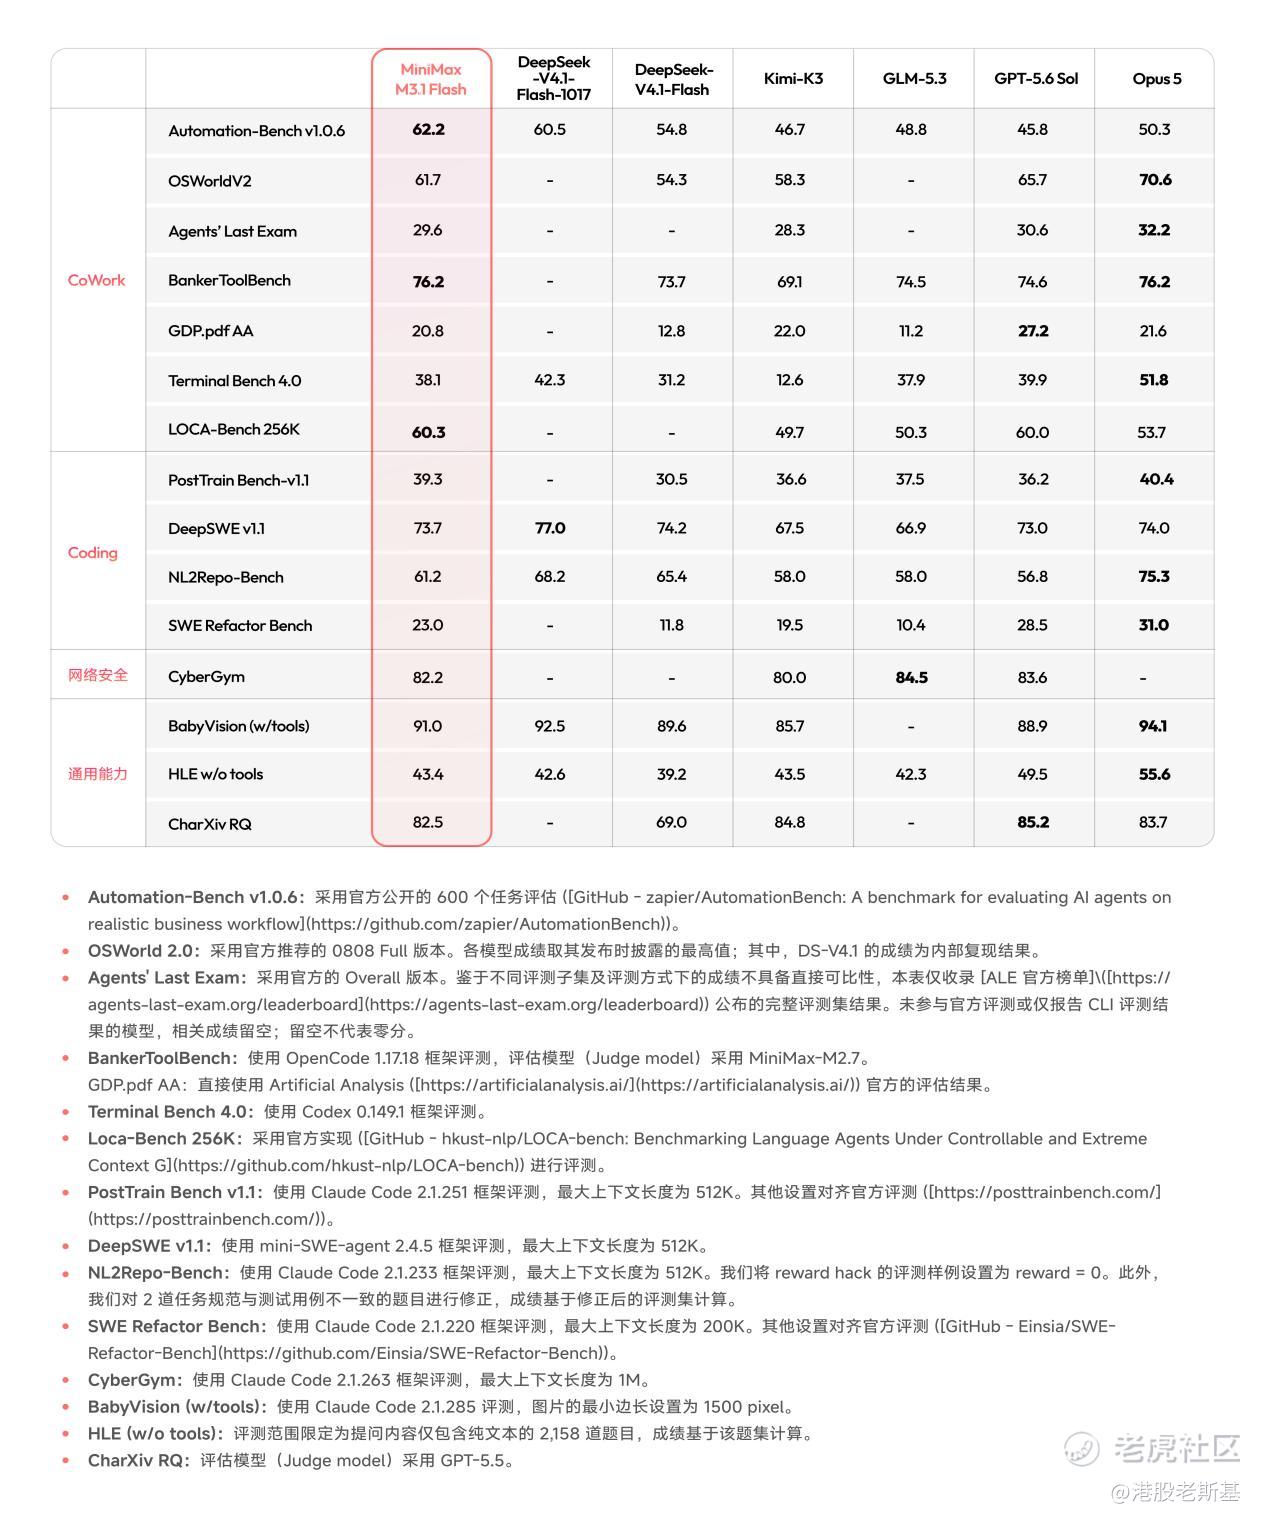
Agent任务上,Automation-Bench拿到62分级别,在官方对比的几家里排第一,同桌的有DeepSeek V4.1 Flash、Kimi K3、GLM-5.3、GPT-5.6 Sol和Opus 5。这里需要注明一个细节:官方博客和TechRepublic引用的Automation-Bench v1.0.6成绩是62.8,部分中文报道用的是62.2,差异来自推理档位设置;无论取哪个口径,都领先DeepSeek V4.1 Flash的60.5,结论不变。
金融业务场景的BankerToolBench拿到76.2分,和Opus 5并列最高。电脑操作相关的OSWorld V2和Agents Last Exam两项,都是国产模型第一。
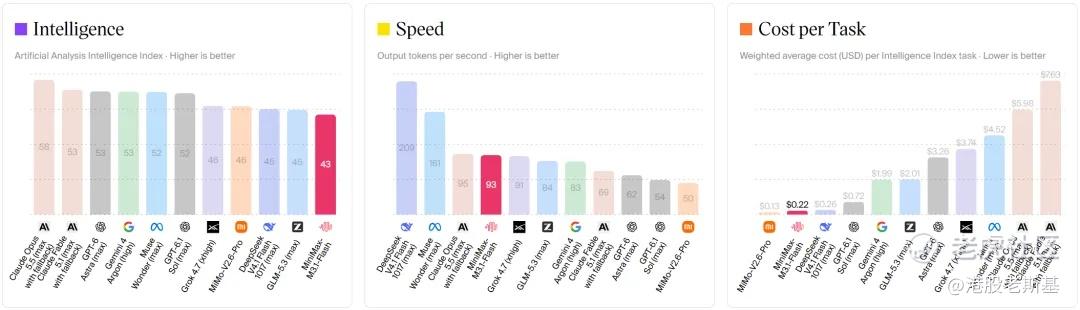
为什么这个维度值钱?想想Agent的工作方式:一个智能体每天要跑几万轮工具调用,查数据、写代码、操作软件,每轮省一点钱,年底汇总就是一笔大账。模型分数差个一两分,用户感知有限;但任务总成本差出一大截,企业的采购部门立刻能算明白。
花旗的判断也印证了这一点:中国AI竞争的重点,正在向端到端智能体工作流和推理成本效率转移。摩根士丹利说得更直接,M3.1 Flash的定价在中国主流Flash模型中极具竞争力,Agent任务成本优势显著。
再放一个极端对照就能感受到这个价位的量级:Kimi K3的输出价格是100元/百万Token,缓存未命中输入20元。M3.1 Flash的4元输出价放在旁边,差了一个数量级以上。这恰恰说明MiniMax选择了一条不同的路线:不去争“最强单体”或“绝对最低价”,而是把“Agent批量执行”的单位任务成本压到企业可以大规模铺开的区间里。
所以MiniMax的账算得很清楚:能力做到够用偏上,任务成本压到足够低,企业级的批量需求自然会流过来。
榜单之外,还有人用另一种方式测了一遍
开发者梦飞把M3.1 Flash12个作品全部验收通过,一共26轮交付,3个第一轮直接过。最快的版画海报工坊从启动到交付1小时17分,4个图层、8套专色色板、6种构图生成器,随机种子能复现同一张图,一键导出2400×3200的PNG和矢量SVG。他自己在Mcode上跑十几个任务,平均速度110+ TPS,官方口径的输出P50是170+ TPS。
最能说明问题的是两个。一个是720架无人机的灯光秀预演,队形从地面方阵切到星球、切到"山海"二字、切到鲸鱼、再到用户输入的文字,每次切换都要满足安全间距。第一轮画面里有白色光斑和灰色颗粒,过渡段最多83对间距不达标。他把要求改成"所有过渡段必须0违规",Agent把避让算法整个重写,改成每段过渡单独求解一套分层高度。第二轮交回来,附了一张开关前后的对照表:关掉避让是0.52米、82对违规,打开避让是2.08米、0对违规。
另一个是《临川四时之城》。同一片地理上依次长村落、古镇、工业港口、现代城市,四个时代共用一份地理数据,改一处牵动全局。第一轮现代城市只有几十栋楼,看着像小镇。他一口气提了新需求:至少150栋,要有天际线和地标塔楼,老桥改成步行桥,下游再加一座斜拉桥,车辆路线跟着改。第二轮交回来154栋楼,另外三个时代一点没受影响。在一个已经很大的项目上改需求还不穿帮,比从零写更难。
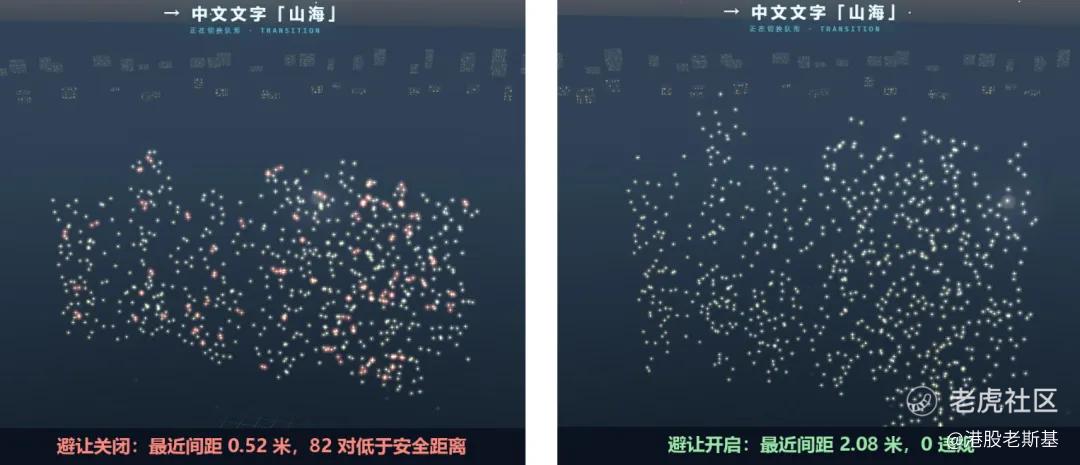
真正让他改观的还有两件小事。四季列车那次,他只描述了现象——冬天的树是黑的、开场镜头穿模、列车在隧道口翘起来——Agent自己查出三个根因:雪松针叶颜色太暗夜里几乎不反光、驾驶室机位落在了锅炉里面、列车倾角的曲率噪声太大,一轮全修好。另一次更意外:时光城市被他测出只有3帧,Agent逐个时代实测,拿真实显卡的数据跟他据理力争,最后证明是他的测试脚本出了问题。
这类行为在跑分榜上完全测不出来。200万亿Token的野外里程补的是长程一致性,12个作品的26轮交付补的是返工能力,两者指向同一件事:Agent能不能把一件活从头扛到尾。
现阶段的边界也摆在那里。早期它习惯跳帧检查,直接跳到某个时间点截图,漏掉了只有连续播放才会暴露的问题:舞台秀的配乐整段静音、陶艺工坊的器物播到52秒会"炸开",都是验收时才发现的。他在公共规则里加了一条"必须连续播放自查并截图",同类问题明显少了。这属于工程上能修掉的缺口,也指向下一步最明确的迭代方向——自检规则一旦固化进工作流,需要人工兜底的比例还会再降一截。
首日接入这张名单,才是开源的真正落点
这次开源还有个容易被忽略的细节:接入阵容。
****、平头哥、昆仑芯、摩尔线程这些国产芯片厂商,和英伟达、AMD在同一天完成接入;vLLM、SGLang、Hugging Face、魔搭这些主流框架和社区同步跟进。放在以前,新模型发布往往先适配英伟达生态,国产硬件要等社区慢慢移植,等移植好了,模型热度也凉了半截。
这次等于官方把全芯片适配当成了发布标准来做。
这件事的价值要站在企业视角看:选国产算力方案的时候,模型生态这块短板正在被补上;开发者手里不管什么卡、跑在哪家云上,开箱就能用。一个开源模型铺得越广,用的人越多,生态就越稳,这是会自我强化的正循环。
还有个彩蛋。这个模型正式发布前,曾以Space Bunny的匿名身份在外面跑了一阵,悄悄处理了超过200万亿Token。也就是说,它先被市场匿名验证过一轮,才摘下面具亮相。这种先跑流量再开发布会的做法,在大模型圈里并不多见。
大模型下半场,MiniMax先落了一子
把这几件事串起来,MiniMax的逻辑已经很完整了:用MoE架构和稀疏优化把成本打下来,用定价把企业客户引进来,用全芯片开源把生态铺开,最后72小时100万亿Token的真实流量给整套打法盖了章。杰弗瑞维持买入评级,大摩维持增持并给出900港元目标价,国际投行的态度也摆在那里。
上半场拼参数,下半场拼的是谁能在同样的硬件上跑得更快、更便宜、更稳。这一子落下,棋局的走向开始有看头了。
精彩评论