“没见过神迹的人是不信的!”
文丨王小淳(实习生)程曼祺
“不好意思,借过一下。” GPT 这么说时,并不是要入侵谁的领地,它只是在走自己的路。无意中被撞到的就有具身智能。
在 OpenAI 于 9 月初发布 GPT-6 Astra 后,更多具身智能从业者发现,通用多模态基础模型居然也可以直接做过去 VLA(vision-language-action,视觉-语言-动作模型) 等机器人策略模型的部分工作——它可以直接输出机器人末端执行器的位姿,完成部分任务的成功率甚至超越一些具身模型。
这动摇了数字世界 AI 和物理 AI 的边界,也引发了一个灵魂拷问:GPT、Fable 之类的通用模型是否会吃掉具身智能?
同时,已经发生的事实是:OpenAI、Anthropic、DeepSeek、Kimi 等多数通用前沿模型公司都正酝酿进入具身智能和物理 AI。
这是 26 年 Q3 《晚点聊》具身季报关注的最重要的变化。这次,我们继续邀请 Alphaist 创始合伙人陈哲担任分享嘉宾。
Alphaist 是一家聚焦 AI、机器人与智能硬件领域的早期美元基金。创立 Alphaist 前,陈哲曾在五源任董事总经理,主导机器人和科技领域投资。
在 Astra 的冲击之外,本期具身季报还关注以下 4 个行业进展和事件:
- AMD 拟以 82 亿美元收购 World Labs
- 宇树 IPO 及连锁反应
- 有可能大幅压缩部署成本的 “上下文学习”
- 美国 FCC 实际禁止了新型号的中国机器人进口
对一些人来说,Astra 的变化已经撼动了独立具身智能公司的发展叙事和估值逻辑。至少,现在到了重新思考物理 AI 与通用 AI 边界的时刻。
这期节目录制之后,本周工博会上,宇树创始人王兴兴也聊到了 GPT-6,他说:“过去十几年,我犯的最大错误就是对 AI 的相信还不太够。”
Astra 冲击:通用 AI 会吃掉物理 AI 吗?
“没有见过神迹的人,是不会相信的”
晚点:我们还是从本季度最重要的 Top 5 进展和事件开始。这个季度,你看到了哪些值得分享的行业变化?
陈哲:首先是 GPT-6 Astra 发布,让大家看到了通用多模态基础模型进入物理智能的潜力。
第二是 AMD 和李飞飞创立的 World Labs 签署了 82 亿美元的收购协议。这笔交易给过去一两年兴起的 Neo Lab 做了一次实质定价,也可能影响世界模型和具身模型公司的出路。
第三是宇树 IPO,以及它对整个具身行业估值的重构。
第四是具身模型里的上下文学习(ICL,in-context learning)更成熟了。本季度 Generalist 发布的 GEN-1.5 和 Skild AI 发布的 S1 都展现了相关能力。ICL 的重要意义是有可能大幅降低部署成本。
最后一件事是,美国联邦通信委员会(FCC)在 7 月底将 “外国生产的先进机器人设备” 列入受管制清单,新型号的机器人如果没有获得批准,将无法进入美国市场。这可能会影响中美具身的研发节奏和供应链发展。
晚点:我们先从 GPT-6 Astra 开始聊。之前,通用基础模型主要是提升编程、agent 等数字世界任务的表现,但这一次,Astra 进入了物理世界。你怎么理解这种变化?为什么它在此刻发生?
陈哲:最近去美国和研究员交流,我感到以 OpenAI 为代表的前沿实验室的普遍想法是:物理 AI 是 AGI 的一个子问题,解决 AGI 的过程中涌现的能力会自然帮助解决物理 AI。这是一个研究思路的重大变化。
这种思路最早可以追溯到 2025 年初 Google 发布的 Gemini Robotics。它当时分为两个版本:VLA 模型 Gemini Robotics,以及侧重上层空间推理的 Gemini Robotics-ER(Embodied Reasoning,具身推理)。
当时很多人不理解为什么要出 ER,因为大家之前觉得语言模型不擅长理解空间和物理世界,所以需要训练专门的物理 AI 模型。
今天回头看,Google 可能那时就看到了通用语言模型在复杂空间理解和推理上的潜力。
晚点:其实 2025 年初 Google 发这两个模型时,相比 ER,具身智能行业更关注 VLA。
陈哲:对。让机器人在开放环境里执行通用任务,可以分成几层。上层负责理解、推理和拆解任务;中间层负责长程执行;更底层还有电机、控制器这些物理层操作。
过去 VLA 和 WAM(world-action model,世界动作模型)主要解决中间和下层的问题,比如把 “拿一个盘子” 转换成连续的动作信号。而 Gemini Robotics-ER 更关注上层问题:理解复杂意图、拆解任务,再调用底层工具完成它。
晚点:这种分层思路一直就有,这次 Astra 给业界的震撼在于它哪里不一样?
陈哲:这次 Astra 不只拆解任务,还能直接生成末端执行器的位姿。
晚点:相当于它和 VLA 一样也充当了机器人的策略模型?
陈哲:不完全一样。现在的测试多是让 Astra 输出位姿,再由一个 IK(inverse kinematics,逆运动学)模块把位姿转换成关节角度,底层控制器再执行动作,而 VLA 或 WAM 能直接输出电机控制信号。
但即使只到位姿这一层,也是过去人们认为通用模型很难做到的,这需要大量空间和物理常识,它们原本是 VLA 等具身模型的工作。
晚点:OpenAI 发布 GPT-6 Astra 时,官方博客没有提到机器人和具身智能。研究者怎么发现了这种用法?
陈哲:其实 7 月上旬 Anthropic 在《Claude 操作机器人》(Claude Plays Robotics)一文中就做了铺垫,他们当时测试了 Claude Opus 4.7、Claude Mythos Preview、GPT-5.4、Gemini 3.1 Pro Preview、Kimi K2.6 和 Qwen 3.6-Plus 等 12 个模型控制机器人的表现。其中一种方法,就是让模型生成末端执行器的位姿。
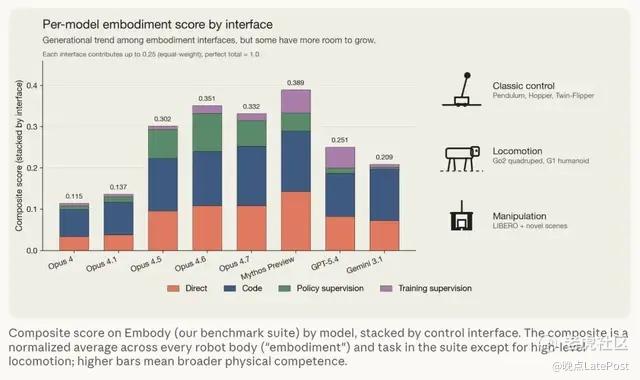
Anthropic 在 Claude Plays Robotics 中展示的数据。对于选取的模型,Anthropic 团队测了三类任:经典控制、运动控制(Locomotion,这部分测了各模型在宇树 Go2 四足狗和 G1 人形上的表现)和操作(Manipulation);并观察了 4 种接口(interface)也就是四种控制方法:橙色是让模型直接输出动作;蓝色是让模型先编程一个 Python 控制器,再由程序读取机器人状态并连续生成动作;绿色是让模型去监督其它的机器人策略模型,比如监督一个 VLA 模型;紫色是让模型设计奖励函数、策略网络和训练计划,从头训练并部署一个强化学习策略。柱顶数字是各模型在不同机器人、任务和 interface 上的标准化综合得分,并非任务成功率;四种接口的权重皆为 0.25,和为 1 。
后来 Robocurve 等团队搭建了相似的测试管线。Astra 发布后,他们只用一两天就完成了适配,发现 Astra 在部分任务上的成功率大幅提高。
晚点:你这次在美国和欧洲接触的一线研究者和从业者,他们是什么时候意识到这个变化的?
陈哲:真正见过 OpenAI 在做什么的人和没见过的人,思维完全不同。
比如 9 月底我去匹兹堡参加了 IROS 2026(机器人学顶会)。有一天的晚宴上,CMU 助理教授石冠亚老师做了一个调查,问在场 100 多位研究人员如何看 Astra 对 Robotics 的影响。从现场表态看,一派认为:语言模型解决一切,Robotics is over(机器人学结束了),只要通用模型不断推进前沿,就没什么问题值得研究了,这派大概占三分之一。
另一派认为,通用模型永远解决不了我们今天研究的很多物理问题。也有折中派认为通用模型和物理 AI 模型是分层的,会各占生态位。
晚点:你认为为什么会有这种差别?
陈哲:没有见到神迹的人,就是不会相信的。这很像 2024 年初特斯拉发布 FSD V12 时,他们已经看到了 scaling laws 在自动驾驶上是成立的。但当时国内多数团队无法复现,甚至一度认为这是特斯拉故意放出的烟雾弹。只有亲眼见过这种突破的人,视角才会不同。
晚点:一批知名具身智能公司,如 Generalist、Physical Intelligence(PI) 等,它们属于哪一派?
陈哲:换个方式来回答这个问题,比起流派之争,更根本的冲击在于——物理 AI 的创业叙事和估值底座正在被动摇。
此前,具身 “大脑” 公司在没有商业闭环时能拿到极高估值,底层逻辑在于,部分人相信物理 AI 是大于数字 AI 的独立领域,有望诞生新的 OpenAI。
但 Astra 的出现显示,物理 AI 可能只是通用模型的一个子集,这消解或者削弱了专用具身模型的价值。
不过另一方面,这也可能加速整个物理 AI 的发展,做大市场规模。所以不一定对每个公司都是坏事。
最让人头皮发麻的用法是,把 Astra 当成具身研究员
晚点:Astra 发布之后,不少机构、公司和开发者都自己做了实验与测试,你看到了哪些有趣的研究和发现?
陈哲:我会把 Astra 的影响分成三层。
最直接的第一层,是让它充当策略模型:就是前面聊到的,由 Astra 生成末端位姿。开源社区在 RoboDojo 基准上测的大多是这种用法,直接看它在各类标准任务里的成功率。
当然,这种测试集不一定能真正反映真实世界里的场景和需求,但作为一个代理指标,可以反映不同模型的相关能力。
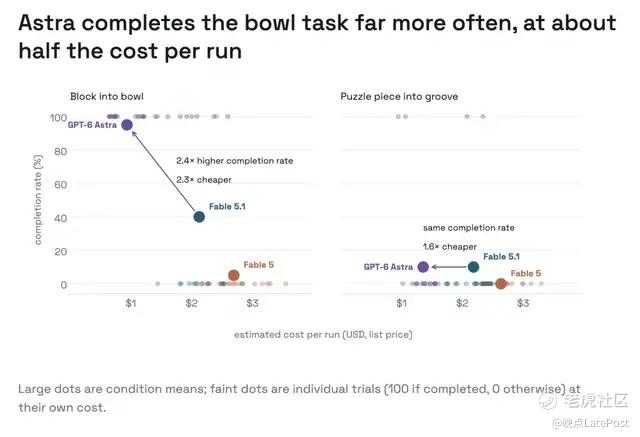
Robocurve 使用了同类 YAM 双臂平台和同一套 agent 策略,比较 GPT-6 Astra、Claude Fable 5.1 和 Fable 5 的任务完成率与调用成本。在 “把积木放进碗里” 的任务中,Astra 20 次成功了 19 次,完成率为 Fable 5.1 的 2.4 倍,单次成本约为其 44%;在更精细的拼图任务中,Astra 与 Fable 5.1 的完成率同为 10%,Astra 成本更低。
往上一层,是让大语言模型去监督和纠正现有的 VLA 等动作模型。比如银河通用最近做了一个混合控制测试:在选取的 RoboDojo 任务中,Astra 单独控制的成功率为 26%;让 Astra 监督并纠正 π0.5 后,成功率跃升到 48%,Astra 扳正了一些原本会失败的不合理动作输出。而此前 π0.5 的公开成绩约为 15.67%。目前这些方法在速度上还没有做太多优化,更多是在提高成功率,探索通用模型的能力边界到底在哪里。
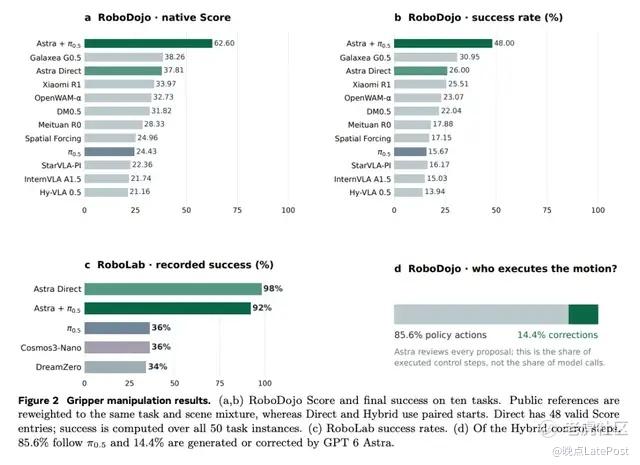
银河通用 9 月 29 日在 arXiv 预印本平台发布文章 Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies(《系统探索 GPT-6 Astra 作为具身策略模型的能力》)。混合控制中,85.6% 的动作由 π0.5 执行,Astra 只生成或修正了其中 14.4%(图 d)。图中的 π0.5 单模型成绩来自重新加权的公开数据,并非在同一批实验中的重新测试。比较有意思的数据还有图 c:在 RoboLab 的任务上,单独使用 Astra 的成功率比 Astra + π0.5 更高。RoboLab 的任务更偏单臂任务,如理解语义后放置、拾取和调整杯子。而 RoboDojo 有更多双臂和长程任务。
但我认为,最让人头皮发麻、具有颠覆性的是第三层:把 Astra 当成一个具身研究员。凭借很强的工具调用能力,它可以在 Blender 里搭 3D 环境,生成资产并设定属性,然后再调用仿真器自主调试、修改和优化运动策略,自己把建模、训练和调优都干了,完成了 “real-to-sim-to-real”(真实到仿真到真实)的闭环。
这也就是所谓的 Physical RSI(物理 AI 自进化):在物理世界里,AI 开始自己训练 AI。
晚点:在第三种用法上,有看到什么具体探索吗?
陈哲:我知道很多创业公司正在试这个方向,甚至有新的公司会以 Physical RSI 去融资。不过还没有特别重磅的公开成果。我们可以期待 Q4 的更多进展。
晚点:在第一种用法上,就是直接让 Astra 生成位姿、做部分 VLA 的工作,Astra 在哪些任务上做得更好,又不太擅长哪些任务?
陈哲:首先,在显著需要推理能力和空间理解能力的任务上,Astra 的能力明显比 VLA 强。
第二是泛化能力,VLA 此前的瓶颈之一就是泛化性不佳,物体换个颜色或位置,模型就懵了。而通用模型的体量和训练方法都使它的泛化能力更突出。
但 Astra 不擅长精细操作,比如扣纽扣、插拔线束这种有摩擦、形变的动作。很多 VLA 模型,会专门获得这类精细操作的遥操数据来做后训练,这是通用模型缺少的。
晚点:它现在还有一个显著缺点,就是速度比较慢,结合它不擅长精细操作,是不是可以认为,这是通用模型和物理模型未来会分层存在的论据之一?
陈哲:我认为长期看,整个机器人系统确实有可能是分层的。但这并非因为大模型永远做不到物理模型今天能做的事,而是因为实时性与边缘算力的约束。
就像无人驾驶,低频的决策可以放到云端,能接受一两秒的延时,但毫秒级的避障与控制要放在车上完成。所以未来更可能是:通用模型在云端,负责低频推理,端侧轻量 VLA 负责高频执行。
但即使有分层,做 VLA 等具身模型公司的价值依然受到挑战。未来的通用基座巨头完全可能通过模型蒸馏,得到一个轻量化的端侧动作模型。也就是说,VLA 还存在,但有可能是 OpenAI 这类公司就把它做了。
OpenAI 招募了 Blender 艺术家做建模,也购买了大量具身数据
晚点:Astra 在空间智能上的提升从何而来?
陈哲:主要来自三项底层能力:一是三维空间理解,二是复杂长程任务的逻辑推理,三是调用机器人接口的工具使用能力。这三项并不是凭空出现的,都是过去通用大模型在数字世界里一直在持续进化的底座。
晚点:我们分别来说,空间理解和推理能力的提升来自什么?特殊的数据,还是训练方法?
陈哲:核心还是在数据。据我了解,他们大概今年 5 月就招募了大量 Blender 艺术家,做了很多 3D 建模轨迹和数据标注,所以 Astra 操控 Blender 的能力才会突飞猛进,这也是空间理解能力的一种体现。
晚点:供应链消息显示,他们也采购了大量具身智能的 egocentric(第一人称视角)数据。不过,不太清楚它们是否被用于 Astra 的预训练。
陈哲:我认为没有理由不用。从 AGI 的视角看,多模态模型的训练必然会需要所有模态的数据,无论是 3D 资产、视频、音频,还是机器人的物理轨迹,都会被纳入模型 scaling 的范畴。
而且通用模型最大的好处,是它的成本可以被多个任务摊薄。比如,OpenAI 雇人来做 Blender 的 3D 建模,这既可以提升数字世界 agent 的表现,也是空间理解能力提升的一个重要来源。
同时,通用巨头的算力代差是碾压式的——头部具身公司可能只用得起千卡集群,而顶级通用大厂手握十万卡甚至百万卡,这是两到三个数量级的悬殊差距。
晚点:你觉得现在的变化会如何影响一批具身智能数据公司的发展?
陈哲:做数据的公司,是谁有预算就服务谁,所以今天它们的最大潜在客户可能就是通用 AI 公司。等具身数据到了足够数量、被通用模型学习之后,它们又可能和其他类型的数据交叉,一起增强模型的能力。
晚点:那是不是意味着,这类数据的供给窗口可能只有几年?
陈哲:其实所有数据生意都是阶段性的。数据服务公司提供的数据模态,会随着模型能力提高而变化。你总要提供今天 AI 还不能解决的问题的数据;等这些问题被 AI 学会,就需要提供更复杂、更高精度的数据。
晚点:再来说第二项能力,逻辑推理能力,这是大语言模型一直在提升的。
陈哲:对,推理是以语言为支柱的大模型非常擅长的任务。而 VLA 和 WAM 为了优化动作生成,更多是一个 “直觉模型”:给一个指令或一张图像,它直接映射出一段动作序列。所以,Astra 擅长的这一点刚好是 VLA 的相对短板。
晚点:你提到的第三个能力是 GPT-6 Astra 能更好调用各种抽象过的机器人接口了,这是不是编程能力的一种表现?
陈哲:它本质上就是 coding 与 agent 能力的外溢。像 MuJoCo、Isaac Gym 这些仿真器都有严谨、清晰的 API。对一个大模型或 agent 系统来说,调用 MuJoCo 和调用浏览器或 Excel 没有区别,都是程序接口的输入与输出。
更有意思的是,让大模型自己写 MuJoCo 程序,在仿真里跑出结果、复盘纠偏,然后再去指导真机策略。这就是前面聊到的 “Physical RSI”,现在一些公司已经在做了,我期待下个季度看到更多尝试。
独立具身公司的机会:重新思考与通用 AI 的边界
晚点:9 月,业内传闻 Kimi、智谱都在筹建具身智能团队,梁文锋此前也说 AGI 的下一步一定是物理 AGI。接下来中国的大模型公司也会集体入局吗?
陈哲:我觉得会。既然物理智能是通用智能的子集,所有奔着 AGI 去的公司,都有意愿和有能力去做这个方向。我觉得国内的大模型公司未来一个季度就会下场。
今天通用模型的难点在于怎么清洗、标注和匹配多模态数据,怎么保证训练不崩,以及怎么搭建规模化的强化学习环境让训练收敛。这些能力只有掌握预训练能力的大模型公司才有,它们下场会比只基于开源模型做开发的具身公司更有竞争力。
我觉得 Astra 最大的启发,就是我们要真正去理解和尊重 scaling laws。
晚点:那原生的具身智能创业公司的护城河究竟在哪里?
陈哲:我觉得空间被挤压可能是注定会发生的,但不代表这些公司真正的市场体量会很小。我觉得大家可以停止争论 VLA 和 WAM 哪条技术路线更好了,在超级智能面前,更重要的,是想清楚边界:如果做一家具身创业公司,哪些能力通用模型已经可以提供?哪些能力仍然是通用模型没有机会做的?
晚点:你的答案是?
陈哲:我认为至少有两件事可以做,第一是做好接口,把自己想象成一个可以被通用模型反复调用的工具。第二是留住属于自己的闭环:它可能是触觉、力学等独有的数据,是满足具体工艺和场景约束的能力,是硬件的可靠性等等。
晚点:听起来你说的是这几类公司:一种是关键零部件公司,比如做本体、灵巧手、传感器的;还有一种是在具体行业或场景里有积累的公司。
陈哲:对,尤其在 to B 领域。垂直行业有极高的工艺沉淀、安全规范和合规牌照门槛。就像数字世界里的 Harvey 或 OpenEvidence,哪怕底层依托通用大模型,它们依然凭借在法律或医疗领域的专业壁垒做成了百亿美金公司。物理世界也一定有类似的位置。
AMD 拟收购 World Labs:大厂往往只愿意买赛道里的第一家
晚点:接下来讨论第二个事件:World Labs 拟被 AMD 收购。目前双方已签署收购协议,收购流程还没有正式完成。
陈哲:我把它列为行业第二重要的事,是因为 World Labs 是典型的 Neo Lab 和世界模型公司。一个拿了巨额融资的明星团队,最终选择被大公司收购作为退出或放大价值的途径,关注度非常高。它也是对世界模型和 Neo Lab 的一次实质定价。
晚点:World Labs 做世界模型,和去年底到今年上半年在中国特别火的 WAM(世界动作模型)不完全是一回事。它和具身智能,和物理 AI 的关系是什么?
陈哲:李飞飞给 World Labs 定义的使命是做 “全模态的空间智能模型”。他们不久前发布的 Atlas 模型擅长空间重建和视角再生成。我们可以把它视作一个更好的生成模型,只是它生成的对象不仅有图像和视频,还有 3D 表示。所以它能用来做游戏,也能用来做机器人训练的仿真环境。
然后今年 7 月,World Labs 还收购了李飞飞以前在斯坦福的合作者参与创办的 SceniX,这是做机器人仿真验证和真机测试的公司。这让 World Labs 生成的环境有了一个更好的出口,去做我们刚才说的 real-to-sim-to-real、Physical RSI 流程里的部分环节,主要是构建空间资产和做与之相关的工作流与数据流。
晚点:所以 World Labs 是我们平时讨论的具身智能公司的基础设施服务商之一?
陈哲:是的,他们和 VLA、WAM 不是竞争关系,是上下游。以 Astra 为代表的通用模型变强之后,World Labs 这类专注空间重建和仿真环境搭建的公司,价值甚至可能进一步放大。
晚点:World Labs 2 月刚融了 10 亿美元,9 月又刚发布 Atlas,看起来进展不错,为什么在这个时间点接受收购?AMD 的诉求又是什么?
陈哲:我只能作为第三方推测:李飞飞和 World Labs 想要持续探索前沿,做出 SOTA(最优表现)的研究,但在无法自我造血时,运营一个独立的研究实验室要消耗大量算力和资源,AMD 正好可以提供这些资源。
而站在 AMD 的角度,今天大家讨论 “AI 头部公司” 时不包含它。英伟达则有 GEAR Lab、Cosmos、Robotics Research Lab 等很多有影响力的物理 AI 团队。AMD 也想吸纳李飞飞这样有业界号召力的人。而且目前是全部用股票支付 82 亿美元的对价,这对近万亿美元市值的 AMD 来说成本不算特别高。
晚点:这笔 82 亿美元的交易,对其他世界模型公司有多大参考意义?
陈哲:国内、国外要分开看。至少在美国市场,这可能是一个标志性事件。虽然这个价格不直接反映 World Labs 的业务表现,但体现了一家万亿市值的头部公司愿意为顶尖 AI 研究团队付出的价值。此前也一直有传言说,Anthropic 有可能收购 PI。(据 TechCrunch 报道,今年春天,两家公司聊过收购事宜,但没有继续推进;后来 PI 的 CEO 否认了 “正在进入收购流程” 的说法。)
考虑到通用模型的发展速度,我觉得 World Labs 可能对这类交易起了一个锚定作用,它在提醒所有 Neo Lab:大厂往往只愿意买赛道里的第一家,如果难以独立实现商业价值,中短期内,尽早卖给大厂可能是多数团队的好归宿。
晚点:国内呢?会有大模型公司收购具身公司吗?
陈哲:国内少有大公司会出这么高的收购价格。中国创业公司的首要目标还是在复杂环境里独立活下来。所以中国公司比较关注落地。
而对美国的不少 Neo Lab 来说,哪怕它们的技术探索不成功,也往往能谈到不错的收购 offer。所以美国很多头部创业公司都很敢做技术判断,无论是 PI 还是 Generalist,它们的很多工作都很有技术独到性和领先性,因为环境奖励这种行为,头部大企业也愿意收购这样的资产,这是一个比较良性的循环。
晚点:中国自动驾驶领域发生过巨头对创业公司的收购。
陈哲:那是在行业已过高峰期、估值相对低的阶段,它不是好的退出方式。前几天我看了一家头部具身公司的创始人说,他的公司融了 30 亿元,但先不打算花,准备等一两年泡沫破灭后,再去用极低价格抄底其它团队,某种程度也有道理。
题图来源:GPT 生成。原图为 2019 年 OpenAI 用强化学习展示的灵巧手单手玩魔方 demo。
精彩评论