近期许多读者在研究LLM的“重置”以及比价问题,也让许多人在讨论大模型的性价比,如何薅羊毛让利益最大化等,也在吐槽旗舰模型定价过高,反应仍较慢。
知名机构半导体分析近期发布了测试结果,认为Anthropic的LLM单位订阅价值是OAI大模型的5倍,具体报告如下。
订阅计划仍是消费者与小企业为 AI 付费的主要方式。正如semiA(原作者,下称“我们”)6 月所述,这类计划受到高额补贴,但作为获客与营销工具仍具经济意义。例如,OpenAI 慷慨的额度重置积累了口碑,部分推动近期 Codex 采用量增长,也迫使 Anthropic 多次收回拟议的订阅限流,以免在舆论中受损。
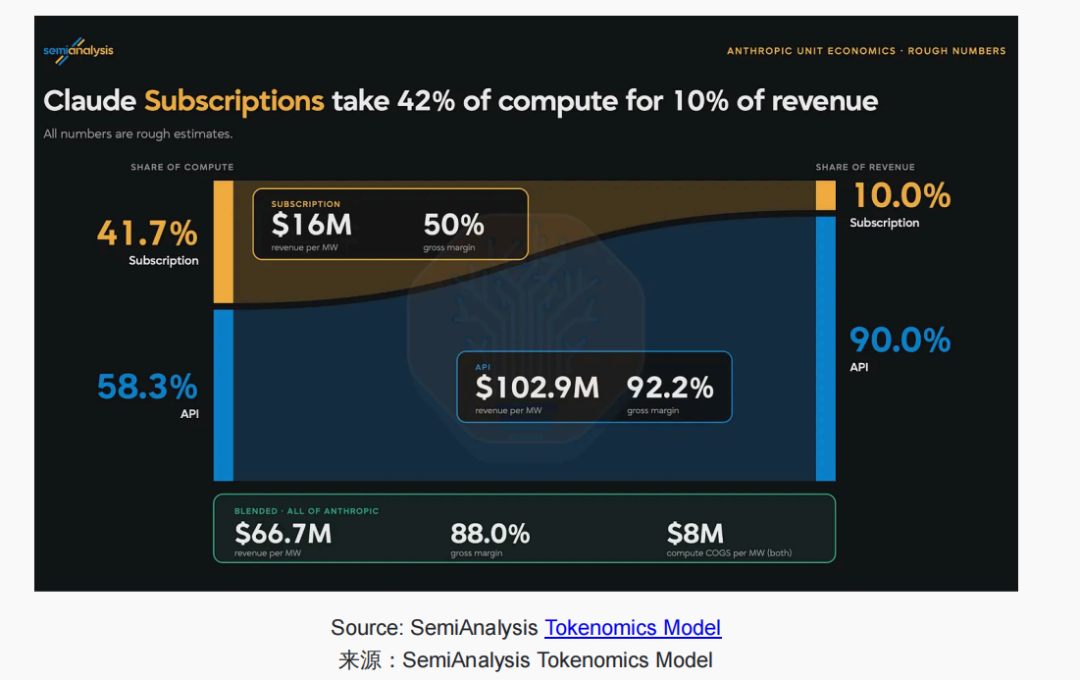
由于订阅补贴很高,即便仅占总收入一小部分,也会显著影响利润率与每兆瓦收入。以 Anthropic 粗略模型为例:订阅约占整体收入 10%,却可能占用 40% 以上推理算力,并把混合每兆瓦收入拉低约 3600 万美元。对 OpenAI 更关键,因为订阅在其总收入中占比更大。要准确建模 AI 实验室财务,必须理解其订阅限额。
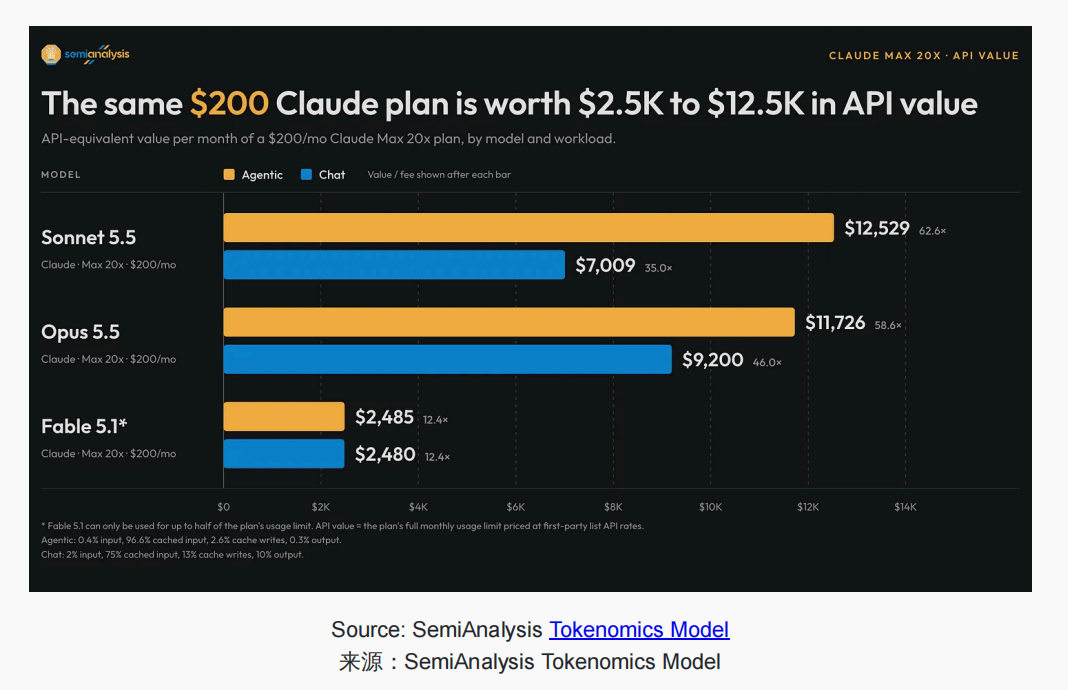
限额的运作逻辑:月费相当于获得一定数量的 credits;每个(模型、token 类型)组合消耗不同 credits。credit 成本比可能与 API 价格比差异很大,因此同一套餐的“价值”随模型与工作负载变化。孤立说某套餐值 X 美元无意义,必须看(套餐、模型、工作负载)三元组。
同一 $200/月 Claude 套餐的 API 等效价值,会随模型与智能体/聊天等工作负载显著变化。
静态快照不够。厂商会通过促销、新模型公开发限额,也可随时调 credit 成本静默改限额。理想做法是每日重测各(套餐、模型、token 类型)成本并实时发现变动。我们的 Subscriptions Dashboard 仅向 Tokenomics Model 订户开放,覆盖 OpenAI、Anthropic,以及 Meta、xAI、Cursor、Cognition、Z.ai、MiniMax、Moonshot;新提供商、套餐、模型发布即加入。下文概述各方便当前限额,除特别说明外,所有 token 与美元均按智能体式使用假设。
Token 通常按每百万 token 计价:输入为未缓存、新加入上下文的 token;缓存写入为多轮可缓存输入,通常略贵于普通输入;缓存读取为前轮已缓存 token,通常远便宜;输出为模型生成 token,通常最贵。部分模型超过特定上下文窗口后单价更高;此类模型通常在高价窗口前做压缩,测算保持在压缩后窗口内。
订阅不暴露上述细粒度价格,只给 5 小时、7 天等窗口的 0–100% 用量计,有时为 Fable 等模型单独设周计。档位仅按相对同厂商其他套餐的用量倍数区分。OpenAI 曾对 $20 Plus 标“扩展 Codex 用量”、$100 Pro 标“5 倍于 Plus”、$200 Pro 标“20 倍”,后将 $200 用量减半并从价格页移除所有相对用量表述。
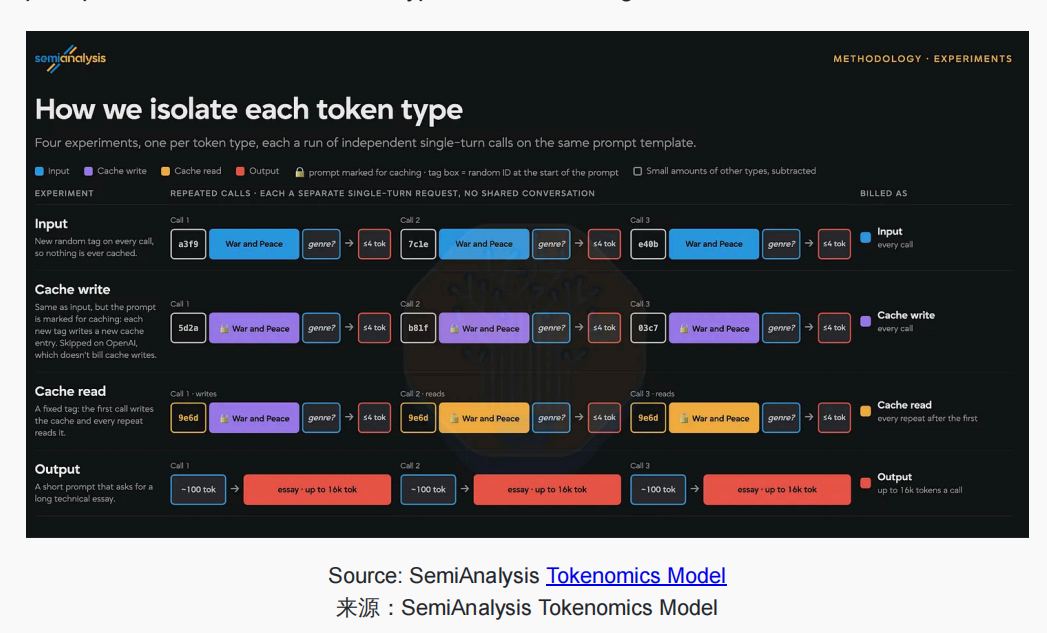
测算方法:对每个(套餐、模型、token 类型)分别实验,隔离单一 token 类型并观测厂商 meter 移动。输入、缓存写、缓存读用统一模板,取《战争与和平》片段,避免乱码被拒。输入实验每请求加随机标签防缓存;缓存写用新标签并声明可缓存,使每次形成新缓存项;缓存读用固定标签,首次写、后续读。输出实验用技术文章提示以迫使长输出,因为“重复某词 N 次”类机械提示常被拒。
结果分三步。
第一,测各类型速率:meter 通常按固定单位移动,单请求可能不移动,故不直接测单请求。按步统计:请求持续进行并累计 token;每次 meter 上升记录累计值;两次上升之间的 token 量构成一个 step,即 meter 移动一单位对应的 token 成本。舍去起始首次上升前、末尾末次上升后的不完整步。对各类型分别计算;因每次请求仅读一次 meter,单步误差最多一个请求,但不随连续步累积,故报区间,持续加步至区间 ±5%。任何请求都不只一种 token,部分套餐每次强制带指令,用已测其他类型价格扣除。若 500M 缓存读后 meter 仍不动,视为该套餐缓存读免费。
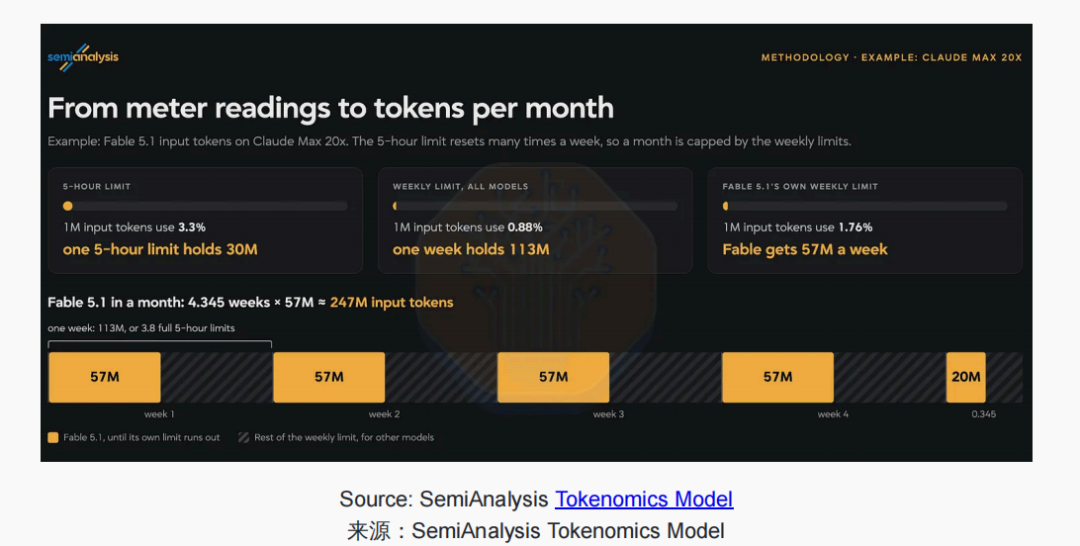
第二,转为每窗口、每月 token 量:每次请求后读取套餐全部 meter(5 小时、周限、Fable 等独立周限)。每种 token 类型在每个 meter 上有“每百万 token 占限额比例”;若 1MTok 占 5%,该 meter 全量为 20MTok。5 小时限额一周多次重置,故月度受周限约束。
第三,定价:将每百万某类型 token 所耗限额百分比折美元;如耗 $200 套餐月度限额 1%=$2。再按假设工作负载比例计算各套餐总 token;智能体负载采用 Tokenomics Model 中 9 月自身使用比例。最后乘 API 价每百万 token 混合单价,得 API 等效价值。
方法验证中,同厂商同订阅 3 个账号有 1 个限额低约 20%、且账号更老,疑为按账号年龄改限;联系厂商后确认系“extremely tiny”限额 A/B,厂商强调“并非整体下调限额”,而是在测试“用户触限后如何更好平衡”。这说明:厂商可随时静默改订阅限额;我们的方法足够敏感以捕捉此类微变。
OpenAI 对 Anthropic:核心是比较限额。注意 OpenAI 上周大改,将 $200 套餐 API 等效价值减半并新增 $500 档。当前 OAI 对 ANT:GPT-6 Astra 与 Fable 5.1 各档总体接近,但 Fable 最多用总限额 50%。即 $200 ANT 跑完 $2,485 Fable 5.1 后仍剩 50% 总限额;$200 OAI 跑完 $2,897 Astra 即耗满。比较 Opus 5.5 与 GPT 6.1 Sol 时,这保留的 50% 尤为重要。
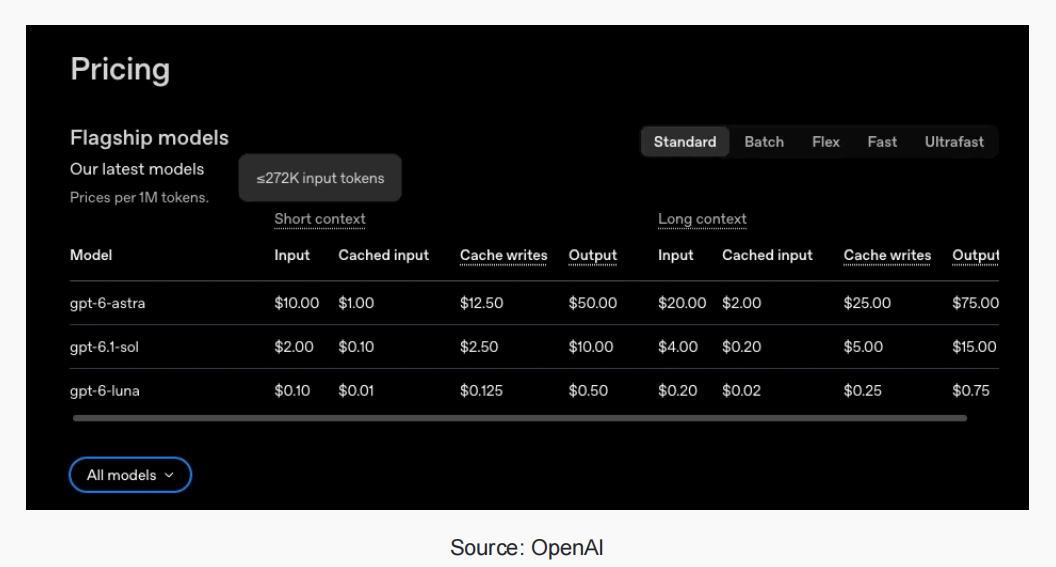
中层日常主力(两家均主打多数用户日常)上,Anthropic 全档显著更优,API 等效价值约 5 倍。即便认为不公、因为 6.1 Sol 单 token 远便宜于 Opus 5.5,改比原始 token 量差距仍大。
总体看,API 等效价值是刻画订阅价值的最佳单一指标,但原始 token 量在部分场景更合适;若某模型 API 价本身特别贵/便宜,等效价值会误导。Token 效率也关键,但行业缺可靠真实工作数据;Artificial Analysis 智能指数基准不代表实际 LLM 工作。
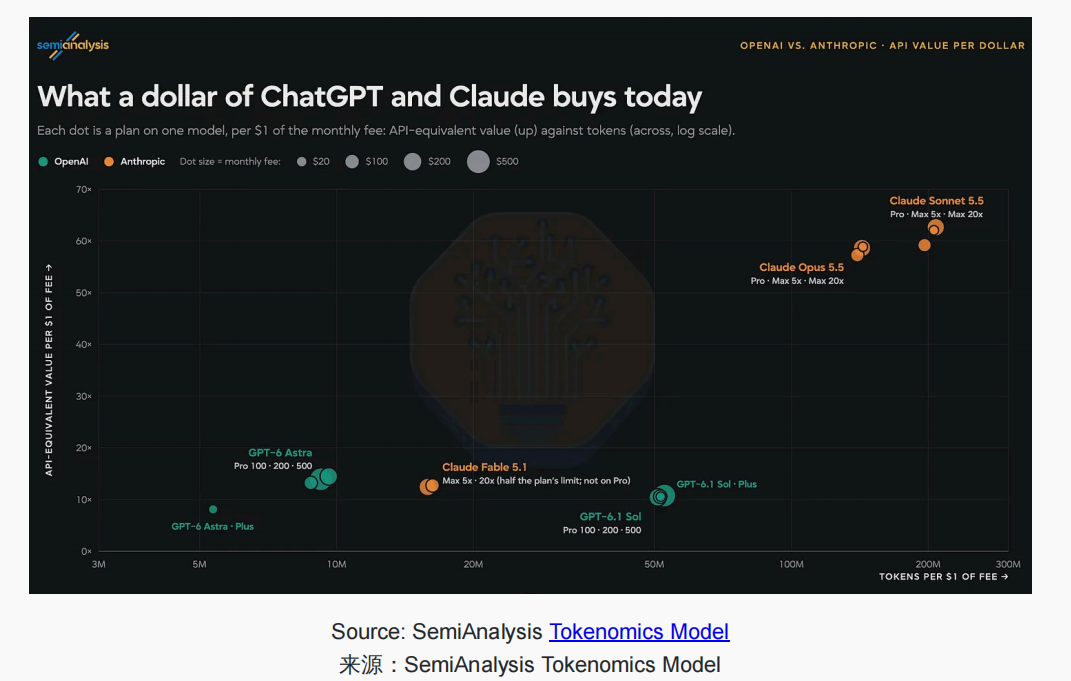
OpenAI 新 $500 与 $200 大降级:我们追踪确认 Tibo 所称 $200 价值降 50%;降价前已购 $200 保留旧高限至 10 月 29 日,新购立即低限。OpenAI 对各模型档 token 数直接减半;因同时对 6.1 Sol 下调缓存输入定价,Sol 类 API 等效价值降超 50%。新 $500 相对旧 $200 仅多约 21% Astra;因前述 6.1 Sol 降价,$500 的 Sol 类等效价值反低于旧 $200。500 档主推 300 TPS Ultrafast,其限额在测;ChatGPT 订阅在 Devin 等第三方的限额也在测。
此前 $200 补贴高于其它档:按(套餐、模型)标准化为 API 等效与每美元 token,Pro 100 在 Astra 上每美元约 2 倍于 Plus,Pro 200 再约 2 倍于 Pro 100 且跨全模型。上周降级后,Pro 100/200/500 各模型每美元 token 趋同;Plus 在 Sol 接近,Astra 相对更差。Anthropic 各档本就同每美元价值,当前显著优于 OpenAI。OpenAI 过去因限额松受独立开发者好评,现已不成立;任意 Claude 订阅跑 Opus 5.5 都优于 OpenAI 任何档。对 OpenAI 唯一反论是 Pro 无 5 小时限,更易吃满月度总限;但不足以抵消 Opus 5.5 约 4 倍 API 等效优势。
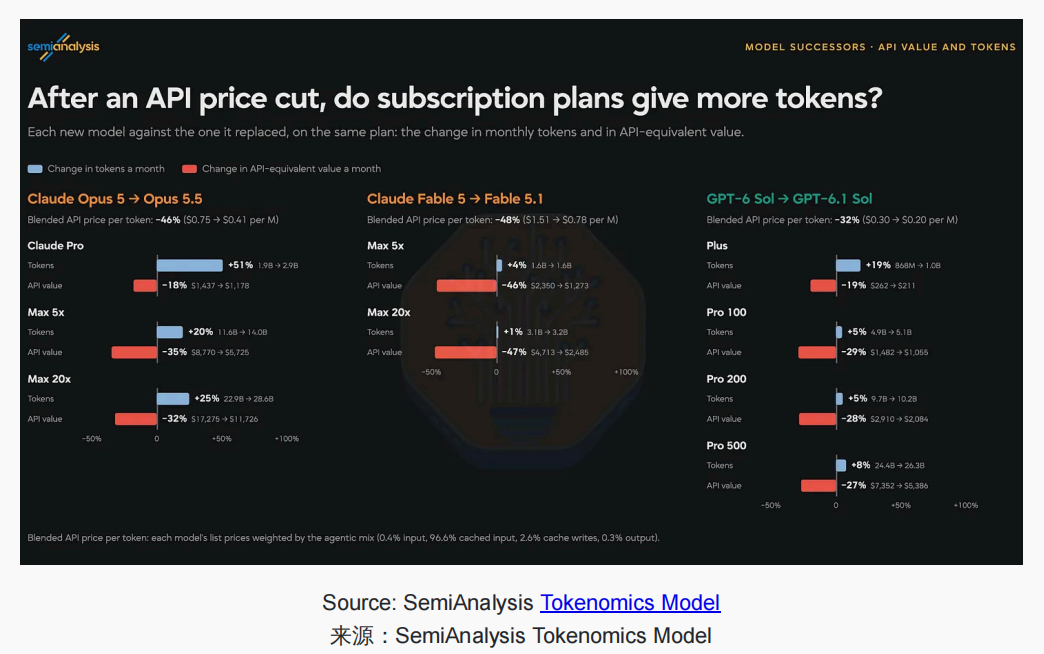
降价后是否调限额:近期 Fable 5.1 缓存读较 Fable 5 降 75%;Opus 5.5 输入输出较 Opus 5 降 20%、缓存读降 60%;GPT 6.1 Sol 缓存读较 GPT 6 Sol 降 50%,而 GPT 6 Sol 已较 5.6 Sol 降 60–67%。OpenAI 发 6.1 Sol 时未改 $200 的 Sol token 限,导致等效价值降约 30%。Anthropic 发 Fable 5.1 未提高 Fable 限;Opus 5.5 降价时提高 Opus 限,Max 增约 20%、Pro 增约 50%,但不足以完全抵消 API 降价。
提升订阅毛利两路:订阅毛利远低于 API,会拉低双方每兆瓦收入。Anthropic 对更贵模型逐步压低等效价值:Sonnet 5.5→Opus 5.5 降幅小,到 Fable 5.1 降幅大。按 100% 利用、92% API 毛利,Opus 5.5 跑满毛利益约 −369%,Fable 5.1 跑满约 1%;按更现实 20% 平均利用,分别为约 6% 与 80%。若全部用 Fable,Anthropic 订阅可接近软件级毛利;Opus 成本随压缩/优化下降,Fable 之上新档会进一步限流甚至不纳入。
OpenAI 则更直接:全模型档统一压到接近 Fable 级限额。其本应有舆论反弹,但靠 DevDay 正反馈、老用户宽限一个月等基本化解。
中国订阅仍补贴但模型间差异大;按每美元标准化,中国 lab 高档每美元价值随档提升,平均低于 OpenAI 约 12x。
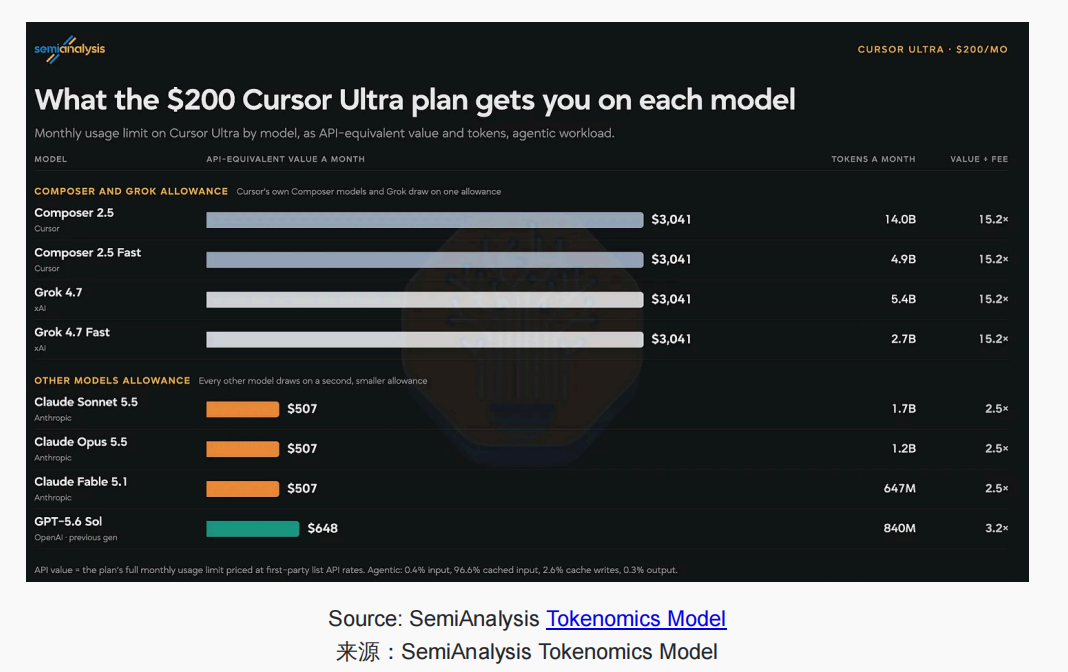
第三方弱于第一方:OpenAI/Anthropic 官方套餐限额明显优于 Cursor、Cognition/Devin。有趣的是 Anthropic 即便给更松限额,毛利可能仍高于 Cursor/Cognition,因为自持模型、不转手别人 API。OpenAI 新模型因信任问题不在 Cursor 提供;仅比 Cognition 时差距较小,部分因 Cognition 对 OpenAI 更松、可能有企业折扣,但主因仍是 OpenAI 每美元价值低于 Anthropic。Cursor $200 上 Composer 与 Grok 4.7 的每美元 API 价值约 15.2x,略高于 OpenAI Pro,但远高于其对第三方模型额度。
当然,虽然B端A社占优,但OAI说我在C端还算好——价格贵是贵了点,但把规矩立住,浪费的算力丢了,明天“重做”,尊重用户隐私(A社又开始钓鱼中国大陆用户了嗯......),这样才能走得远,用了大模型才不烧心。
精彩评论