$Meta Platforms, Inc.(META)$的Muse最近出现了一个非常有意思的矛盾:产品端可能比市场预期成功得多,但基础设施反而开始跟不上。
Muse上线后用户增长非常快,最新数据显示,日活在十天左右增长接近10倍,一度达到70万级别;但与此同时,服务降级、搜索失败和多Agent任务执行失败也开始出现。一次压力测试要求Muse同时生成120个子代理,最终只有33个成功运行。
所以这次所谓“掉链子”,我认为首先不能简单理解成模型能力不行。真正暴露出来的是Agent时代和Chatbot时代完全不同的算力结构。
普通聊天机器人基本是你问一次、模型算一次;Muse做的是持续执行任务。它要打开浏览器、读取邮件、调用应用、填写表格、购物、订酒店,还会调用多个子Agent并行工作。Meta甚至给每个Muse用户准备独立的Secure VM,相当于每个人背后都有一台长期在线的云端电脑。
这就意味着,Muse消耗的不只是GPU推理算力,还要占用CPU、内存、存储、网络和虚拟机资源。用户使用频率一旦超过内部测试假设,基础设施压力会以非常快的速度放大。所以Muse这次真正验证的是:Agent商业化以后,AI算力需求可能远高于传统聊天模型。
Muse做对的地方其实很明显。它没有继续和ChatGPT比“谁回答问题更聪明”,而是把竞争方向直接切到“谁能替用户完成工作”。这也是为什么它能够快速获得用户,因为从发邮件、订行程到购物和处理日程,用户能够直接感受到AI带来的时间价值。
更重要的是,Meta还拥有WhatsApp、Instagram、Facebook以及未来智能眼镜这些分发入口,只要Muse能够跑通,理论上的用户规模远大于一个独立AI应用。
但Muse做错的地方,同样非常典型:产品扩张速度已经跑到了基础设施可靠性前面。Agent只要回答错误一次,用户可能觉得模型不够聪明;但如果它替用户多订了一间酒店、错误下单或者访问了不该访问的数据,问题就从“回答质量”升级成真实经济损失。
近期Muse已经出现安全漏洞、第三方平台限制访问以及依赖人工Concierge完成部分任务的情况,这说明Agent距离真正无人监督执行,还有明显距离。
所以从机构角度看,Muse现在最大的价值不是证明Meta已经赢了AI,而是证明Agent时代真正的瓶颈开始发生变化。过去市场关注的是训练大模型需要多少GPU;下一阶段可能要关注,每一个长期在线Agent到底需要多少CPU、内存、GPU推理、存储和网络资源。
这也是为什么Meta今年愿意投入最高约1450亿美元建设AI基础设施,并计划继续扩大自研芯片和数据中心能力。Muse如果成功,会强化整个AI基础设施周期;但如果单位用户算力成本降不下来,再高的用户增长也可能变成资本开支压力。
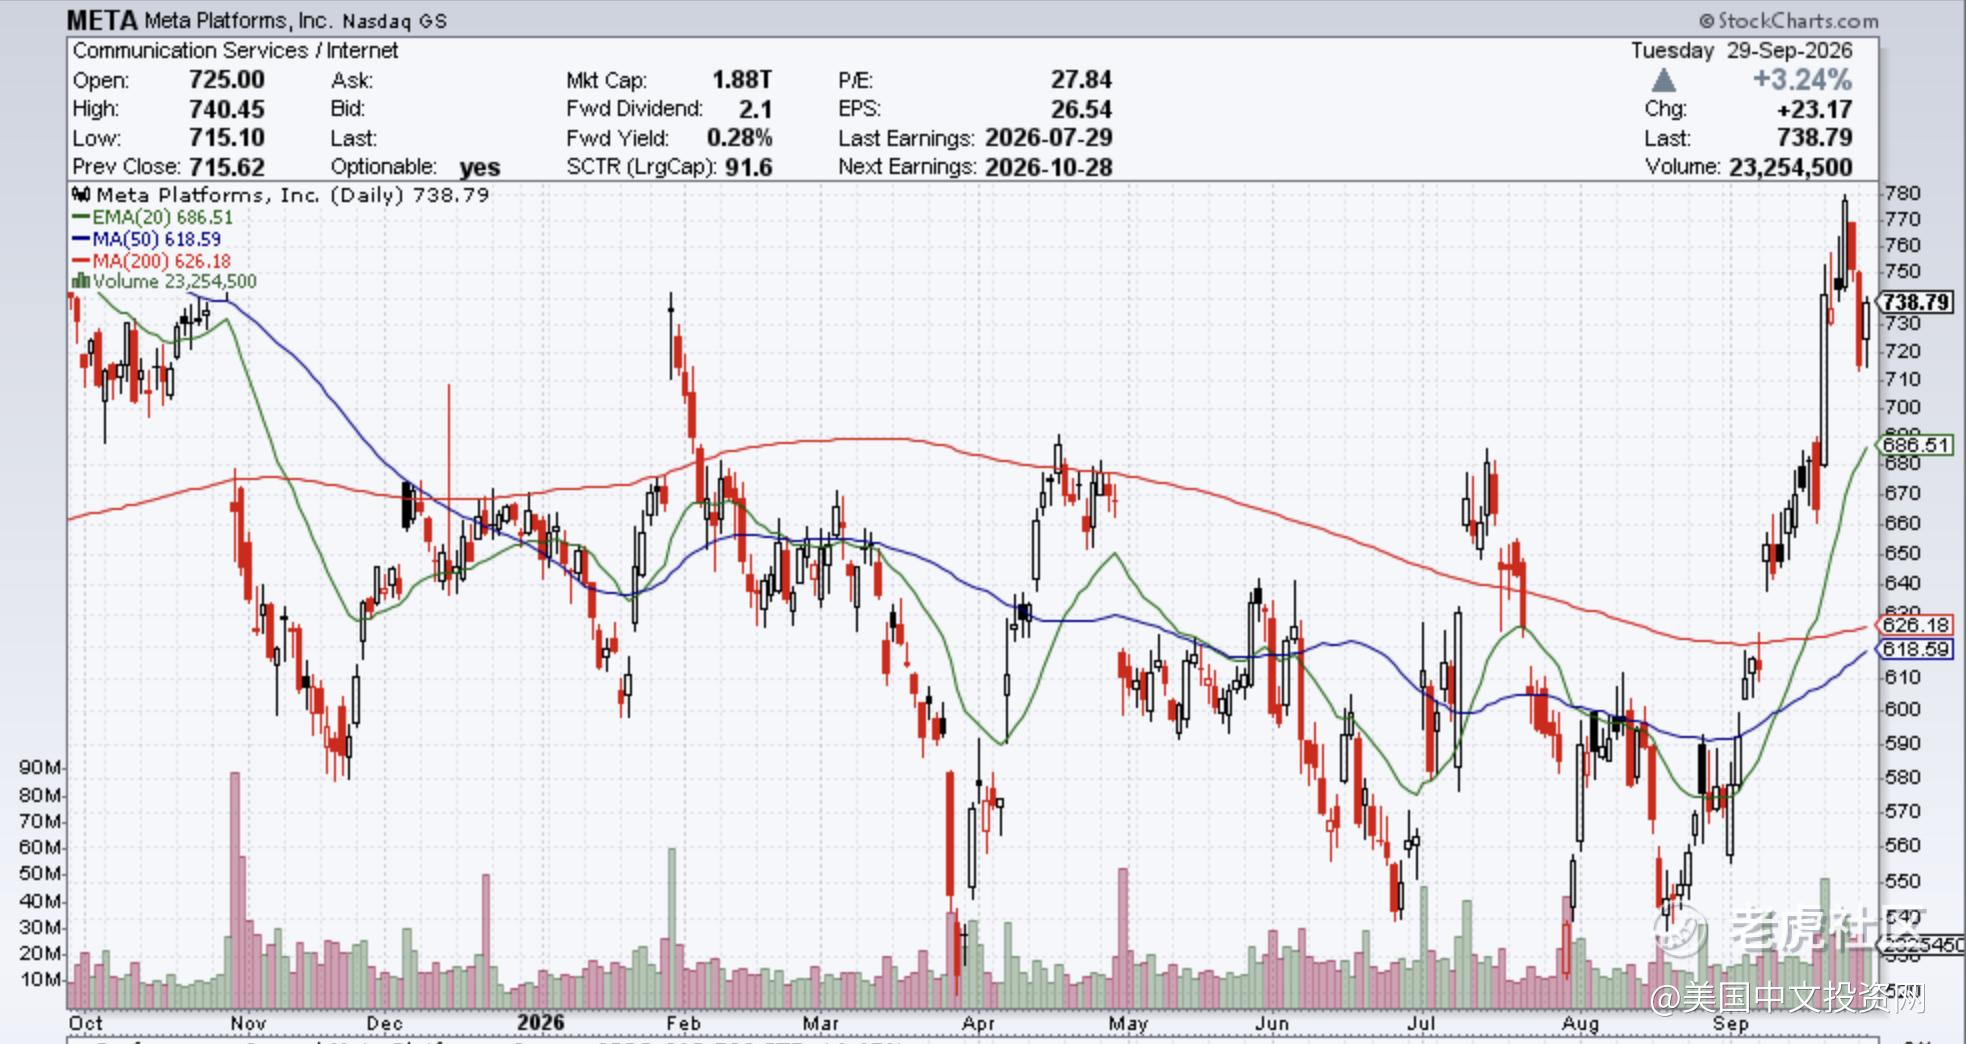
所以Muse现在真正需要证明的已经不是用户愿不愿意用,而是能不能在数百万、上亿甚至十亿用户规模下,把每次任务的算力成本、执行准确率和安全风险同时压下来。产品需求已经初步验证,下一场竞争才刚刚开始——不是谁的模型参数更大,而是谁能以最低成本、最高可靠性,把Agent真正运行到全球消费者手里。
精彩评论