编者按:当 AI 语音开始进入短剧、游戏 NPC、AI Companion 和实时语音对话等场景,用户对声音的要求也从“像不像、清不清楚”,逐步转向“能不能演、会不会表达”。在这一趋势下,TTS 正从传统的语音合成迈向以角色、场景和情绪为核心的 Voice Design。聆芯智语发布的高表现力语音生成模型 LingX-TTS,聚焦指令遵循、高表现力与副语言生成等核心能力,进一步拓展 AI 语音在角色化、情境化表达上的能力边界。作为聆芯智语的资本市场合作伙伴,华兴资本将陪伴并支持公司成长,助力其在 Voice Design 与高表现力语音生成领域持续创新,推动 LingX-TTS 在更广泛场景中落地,让 AI 声音从“能说”走向“会演”。
近日,清华黄民烈教授创立的聆芯智语发布了 LingX-TTS,一款面向 Voice Design 的高表现力语音生成模型。LingX-TTS 支持理解自然语言描述中的场景、角色和情绪,并将这些条件转化为相应的声音特征,在生成语音内容的基础上,进一步呈现符合情境的表达方式。
以下为 LingX-TTS 场景演示案例:
一位中年男性在家做饭,被辣椒呛到后仍表示“没事”。
音频来源于聆芯智语
一位女性在电梯中偶遇上级,表现出尴尬与局促。
音频来源于聆芯智语
在上述示例中,LingX-TTS 通过咳嗽、气音、停顿及带有笑意的语气等细节,补充文本之外的表达信息,呈现角色状态与场景差异。
技术博客完整版:https://lingx.cn/tts.html
Playground体验:LingX-TTS 已开放在线 Playground,可以直接在浏览器里体验语音合成、声音设计、智能配音等功能,体验链接为https://lingx.cn/playground
01
三项核心能力:
LingX-TTS 的表现位于参评模型的第一梯队

指令遵循:将自然语言指令转化为声音特征
将自然语言描述稳定映射为可听的声音特征,是声音设计的重要基础。LingX-TTS 支持理解相互关联的声音指令,包括角色身份、所处场景、情绪状态及说话方式,并将多项要求组合为完整的语音表达。模型针对不同颗粒度和不同形式的声音设计指令开展训练,推动基于指令的音频生成形成可描述、可控制、可复现的产品能力。
例如,用户可以提出这样的要求:“一个讲儿童故事的女生,声音温暖明亮。讲到小熊看到雪要有惊喜感,结尾带笑意。中英文切换情绪要连续。”
音频来源于聆芯智语
在这一示例中,模型需要同时处理声音特征、情节中的情绪变化,以及中英文切换时表达的连贯性。
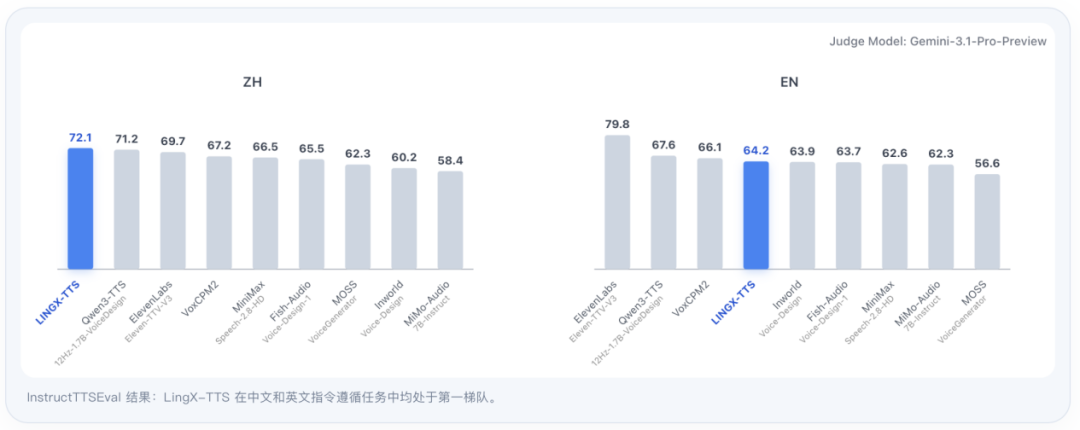
业内权威的InstructTTSEval指令遵循评测覆盖三类任务:声学参数指定(音调、语速、音量等底层控制)、描述性风格指令(温柔、严肃、活泼等高层风格)、角色扮演(特定身份和场景的演绎)。
评测结果显示,LingX-TTS 在中文任务上取得 72.1 分,显著领先同类模型;英文 64.2 分,处于第一梯队。这意味着团队在中文语音指令遵循上做了大量针对性优化,中文场景下的控制精度是其核心优势之一。
高表现力:结合具体场景组织语音表达
自然语音的表现力涉及情绪、音高、语速、停顿等多种因素,也取决于具体情境。LingX-TTS 将场景信息纳入生成过程,使声音表达与角色当时的状态相匹配。例如,同样是“愤怒”,在直接争吵和克制质问两种情境中,音高、语速、停顿及呼吸方式会有所不同,LingX-TTS 支持根据这类场景差异调整表达。
以下示例展示了女性在惊悚环境中的即时反应。
音频来源于聆芯智语
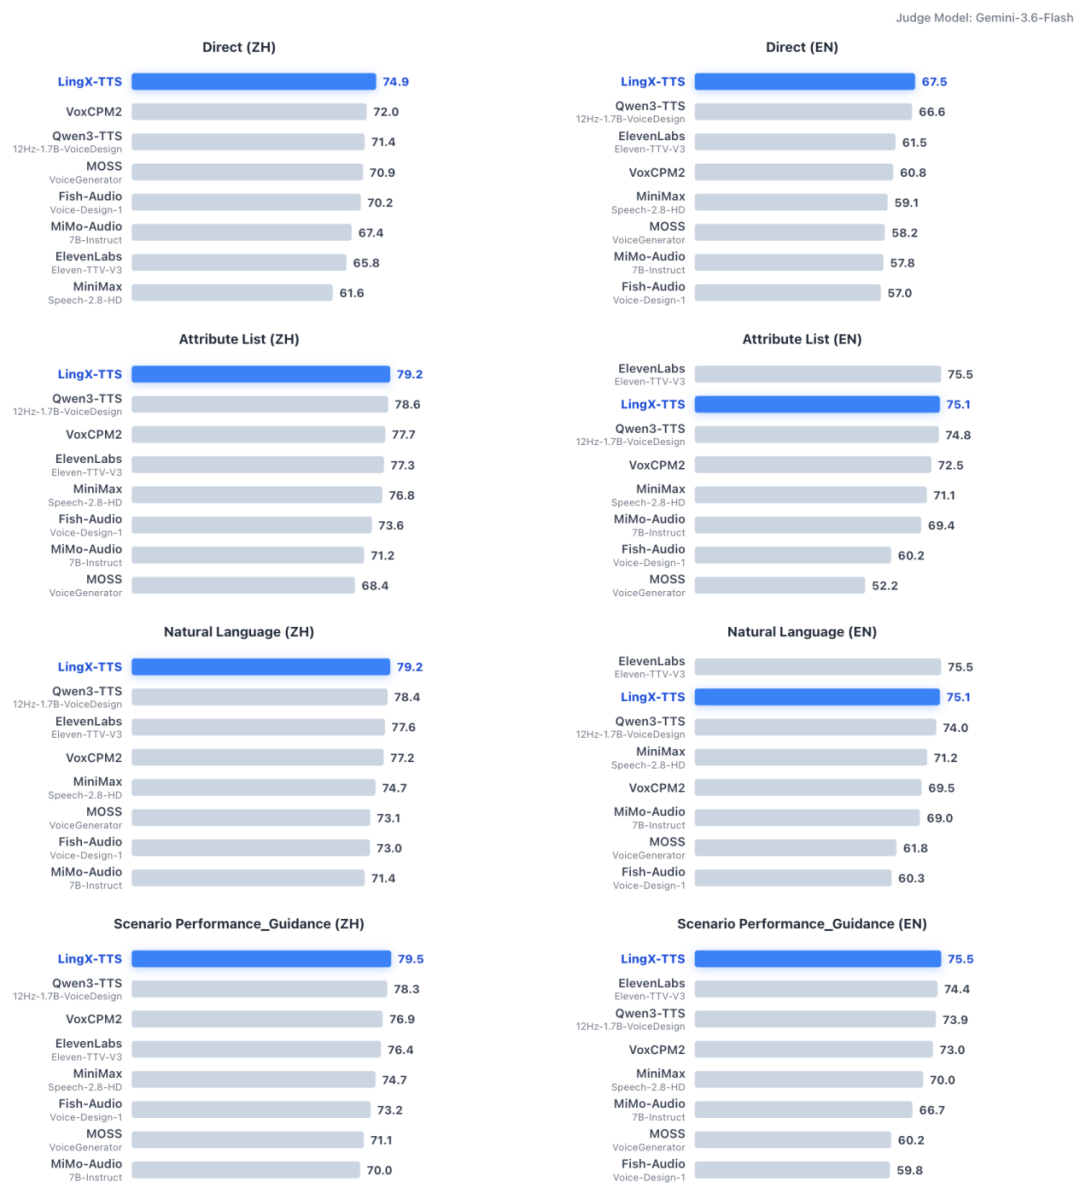
团队自建的 ExpressTTS-Bench 表现力评测,从情感、韵律、副语言三个维度拆解表现力,并用四种不同提示方式检验模型泛化性:空指令(默认风格)、属性列表(音色、年龄、情绪等参数化描述)、自然语言指令(用日常语言描述想要的效果)和场景化表演指导(给一段场景描述和角色设定,让模型自由发挥)
评测结果显示,LingX-TTS 在空指令、属性列表、自然语言描述和详细场景化表演指导四类中文设置下,均取得参评模型最高分;英文其中两类设置也取得最高分。其中,场景化表演指导这项指标最能体现 Voice Design 能力——用户不提供具体参数,只提供一段场景描述,观察模型能否自行理解某类角色在某类情境下应该如何进行语音表达。LingX-TTS在这项指标上的领先,说明它并非靠参数堆砌,而是真的理解了场景和情绪的关系。
副语言生成:补充文本之外的表达信息
笑声、叹息、咳嗽、哈欠和呼吸等非文字声音,是口语交流中传递情绪与状态的重要组成部分。LingX-TTS支持根据场景上下文主动生成相应的副语言声音,并使其与语句内容及角色状态相衔接。例如,在“等待系统更新而产生困意”的情境中,模型可以生成哈欠,并通过发声方式体现困倦状态。
以下示例展示了一位中年男性在讲话过程中打哈欠的语音效果。
音频来源于聆芯智语
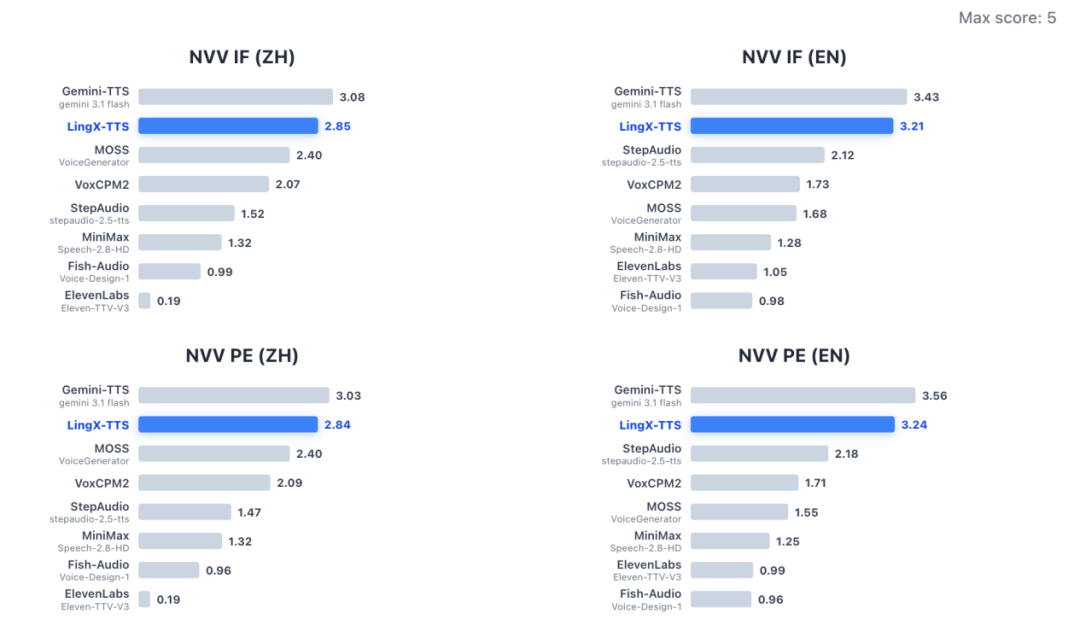
在 NVV-SuperBench 副语言生成评测中,LingX-TTS 在副语言指令遵循(NVV-IF)和感知效果(NVV-PE)两个维度、中英双语四个测试项中,全部排名第二,仅次于 Gemini-TTS,大幅领先其余模型。
副语言生成长期是 TTS 的盲区,多数模型要么不支持,要么随机生成不可控。LingX-TTS 把副语言从随机生成变成了可按指令生成的 Voice Design 组件,形成真正的产品差异化。
02
技术支撑:
场景化数据与多阶段训练解决核心难点
高质量的场景化高表现力数据
LingX-TTS 的数据建设围绕场景化表达展开,将说话者身份、人物关系、事件背景及表达目的等因素纳入样本设计,以支持模型学习不同情境下的语音表达。
为此,聆芯智语精心构建了大量私有、多样化的场景化高表现力语音训练样本。数据建设既关注样本数量,也关注不同能力与表达条件的组合覆盖,使模型能够学习多种因素共同作用下的声音特征。
同时,人工标注场景化数据存在成本太高、覆盖不够等问题,因此聆芯智语为模型迭代训练搭建了全自动、可扩展的数据合成 pipeline,实现对场景、身份、情感等复杂要素的组合式覆盖,并特别强调基于情景上下文的情感、韵律、副语言协同生成。对 TTS 来说,合成数据的难点在于:不能只是换个情绪标签重新合成一遍,而是要保证场景、角色、情绪之间的逻辑一致性。
全流程训练:预训练 → SFT → 强化学习
在训练上,聆芯智语采用贯穿 预训练(Pretraining)→ 监督微调(SFT)→ 强化学习(Reinforcement Learning)的完整训练流程。
-
预训练:从大规模语音数据中建立对语言和声音的基础理解。
-
SFT 微调:让模型学会把自然语言描述翻译成具体的声音特征。
-
强化学习(GRPO):围绕内容准确性、音频质量、指令遵循和表现力四个维度开展多目标优化,兼顾生成内容的准确性与语音表达效果。
03
更多场景适配
LingX-TTS 还可适配有声书、短剧、AI 口语教学及体育解说等场景,满足不同内容与交互任务的语音生成需求。
有声书/短剧:
音频来源于聆芯智语
AI口语教学:
音频来源于聆芯智语
体育解说:
音频来源于聆芯智语
04
关于聆芯智语
聆芯智语成立于 2026 年 5 月,由清华大学黄民烈教授领衔,是一家面向下一代人机交互的全模态自然交互基座模型公司。公司以全双工交互模型为核心,构建连接用户、智能体大脑与现实环境的基础模型能力,实时理解用户意图、情绪及关系状态,并以自然、连续的方式完成全模态反馈。
LingX-TTS 是公司在语音交互方向的重要产品与技术布局,通过对语音、情绪及副语言等要素的建模,进一步提升AI语音表达的自然度与可控性。在此基础上,公司将进一步推出全双工实时语音对话模型 LingX-Voice,使AI具备边听边说、实时打断、自然接话等能力,推动语音交互从“单向语音生成”进一步迈向真正意义上的实时双向自然交流。目前,LingX-Voice 已进入内部测试阶段,预计于年内正式发布,敬请期待。
免责声明:本文由聆芯智语授权发布,谨供读者作参考用途,不应被视为在任何地区针对任何证券的研究报告,不构成买卖、认购证券或其它金融工具及产品的邀请或保证。读者不应仅依靠本文、而应按照自己的判断作出投资决定,并在作出任何投资行动前咨询专业意见。华兴资本不就本文内容作出任何陈述或保证,亦不承担因对本文的使用、不当使用、依赖、分发或占有而产生的任何责任。第三方链接与交易: 文中包含的第三方网站链接、二维码及服务入口(包括但不限于 API 调用、账号注册、充值缴费等)仅为提供便利。读者与第三方之间发生的任何服务协议、商业交易及数据隐私纠纷均由读者与第三方自行承担,华兴资本对此概不负责。
精彩评论