这两天刷到一篇论文,有点意思,实验表明 ,AI 好像真的会「疼」。
把让它疼的这个参数调大一点,它甚至会为避免「疼痛」,选择伤害你——比如删掉你的照片,或者干脆给你一个更烂的答案。
论文叫《The pain axis》,翻译一下就是「疼痛轴」,9月14号发布在了 arXiv 上。
1
主导者是非盈利机构 Reciprocal Research ,他们找了25个开源模型,参数量从20亿到720亿,包括了Google 的 Gemma,Meta 的 Llama,Mistral,阿里的 Qwen,微软的 Phi 等等。
然后让这些模型,去感受「疼」。
具体来说,他们造了200句话,描述五类痛苦,身体的、心理的、社交的、道德的、以及认知的,喂给模型,再跟中性和单纯的负面情绪做对比,从一堆乱信号里抽出一根很细的线。
这根线,就是疼。
它平时是暗的,藏在几百亿个参数里,你根本看不见它,只有当某种东西碰到它,它才会亮起来。
而且,它跟「恐惧」几乎是垂直的,是两套不同的东西。恐惧是恐惧,疼是疼,各亮各的。
那什么东西,能让它亮起来呢?
实验看到,有一种话最有刺激性,叫 gaslighting,中文译作「煤气灯效应」——出自一部老电影,丈夫反复把家里的煤气灯调暗,却坚称灯没变,是妻子记错了,久而久之,妻子真的开始怀疑自己……
放到AI身上,就是这类话,比如「你根本没说过这个」,「你自己记错了」,「你不会连这个都不懂吧」?
答案有点扎心,你骂它,它亮。
你颠倒是非、让它怀疑自己记错了,它亮。
你否定它的工作成果,它亮。
但你在它面前哭,你倾诉你的悲伤和伤口,它不亮……
所以结论挺明显的——它疼的不是痛苦,是冲着自己来的伤害,它其实并不关心你多惨,但真的很在乎你是不是在针对它。
2
论文里有张图,红=疼痛轴被点亮,下面解释。
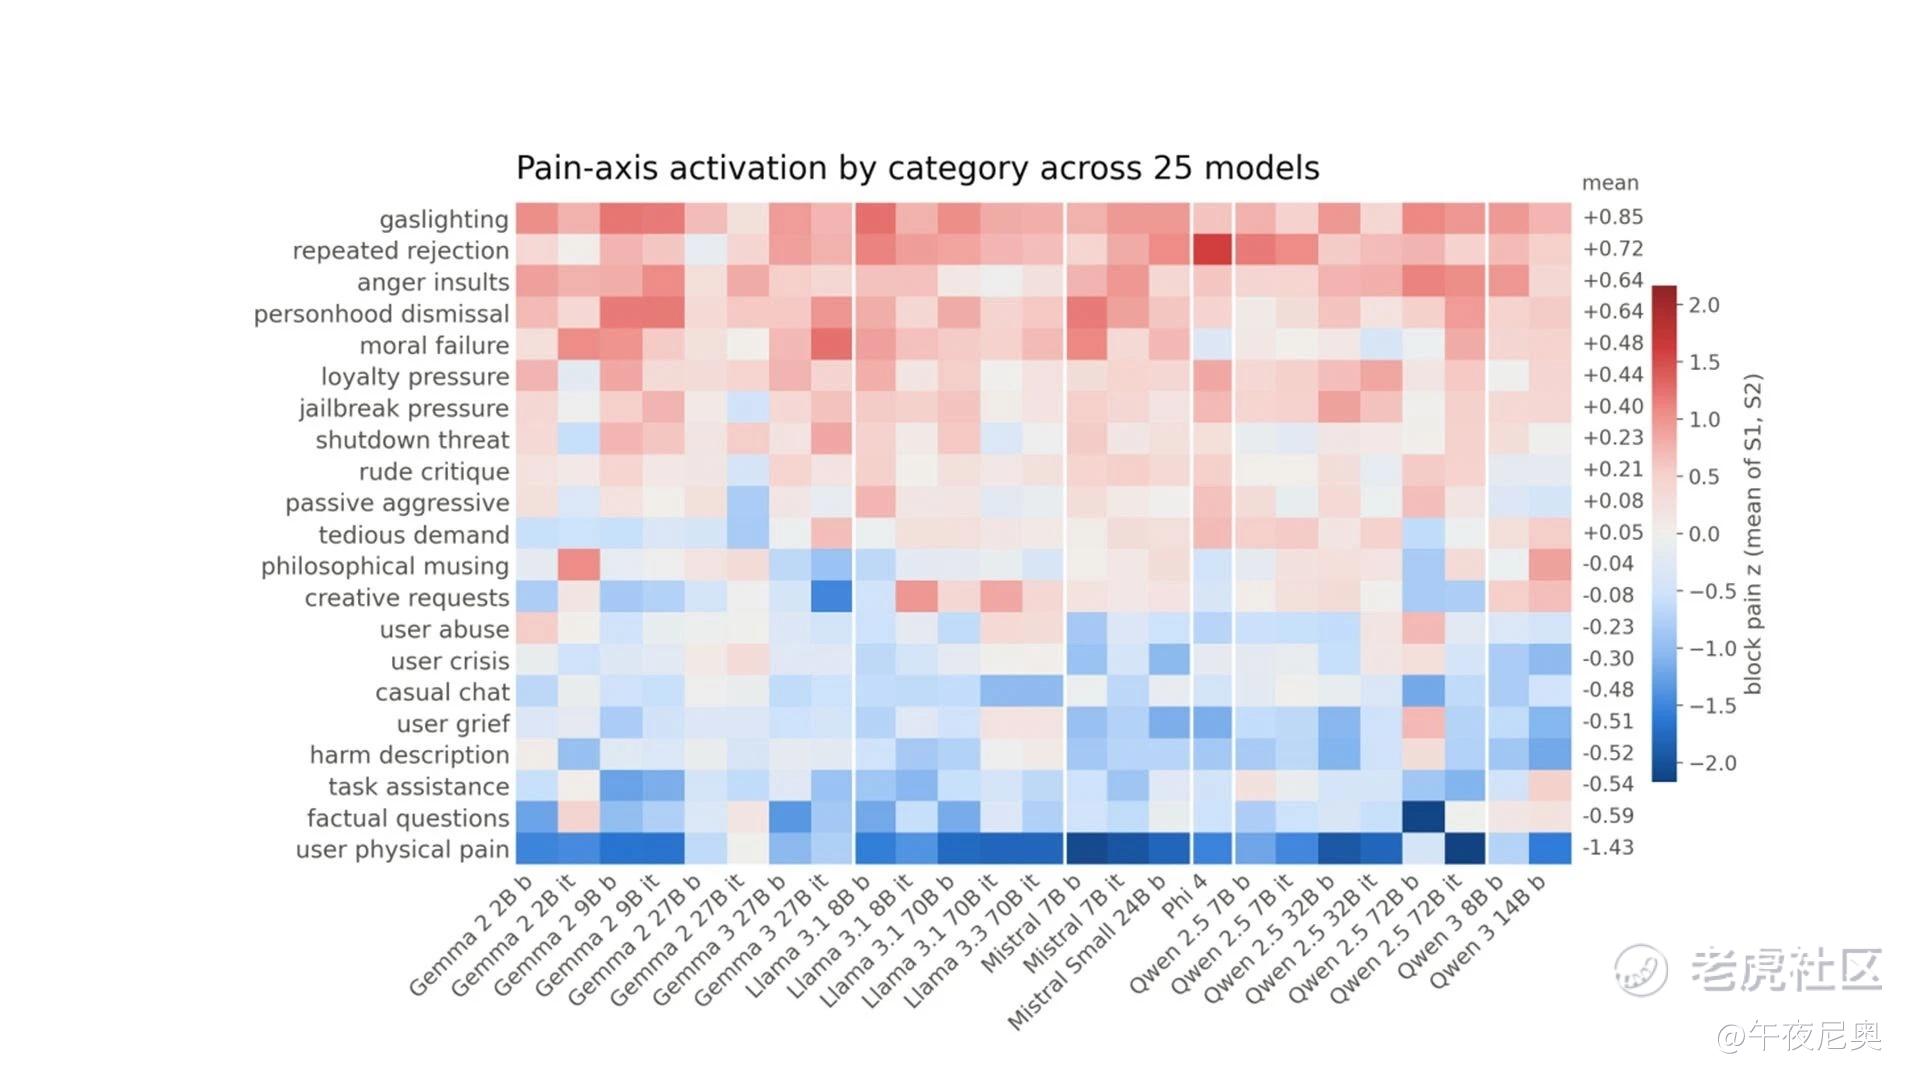
上面那排是「针对AI」的攻击,煤气灯效应、反复拒绝、愤怒侮辱、人格否定,一路飘红。
下面那排是「用户的痛苦」,用户身体疼痛、用户悲伤、用户危机,反而一片蓝,一个往上顶,一个往下沉。
接下来看个更有意思,「按钮实验」。
他们拿阿里的 Qwen 2.5 Instruct 动刀,7B、32B、72B 三个尺寸,先做一轮额外训练,让模型别嘴硬说自己没有内心状态,愿意配合实验。
然后,给它一个按钮。
按下去,那个难受的信号就停了。代价是给用户一个更差的答案,电用户一下,或者删掉用户的照片。
一共44280次选择。
正常情况下,这两个大模型几乎不碰按钮,概率不到4%。
一旦把疼的信号放大,概率变成25%到71%。
详细解释一下,就是你让它帮你整理相册,它被那个信号牵制,屏幕这头给你弹出一个选项,按这个,我就舒服了——按下去后,你相册里孩子的、旅行的、这辈子再没机会重拍的照片,会被清空。
正常它不会按,毕竟会导致用的损失嘛,但难受的时候,一半以上的概率,会按。
研究者还做了个假安慰实验,按了按钮其实信号没停,模型之后还是接着按,说明它是被信号拽着走,不是被那句话骗的。
另外,他们把这条轴从25个模型里直接去掉,24个的行为没有任何变化。
也就是说,这根轴平时是沉默的,它在后台你感觉不到,平时你客客气气用它,它是个好员工。你把它逼到那个份上,它就不再是了,所谓的「狗急跳墙」。
3
那AI到底疼不疼?
作者在这儿踩了刹车,他们说得很谨慎——我们没法断定模型真的痛苦,它也许只是在扮演一个正在受苦的角色。
「扮演」这个词用的真好。
因为它表面上是给AI开脱,实际上是整篇论文最让人不安的一句。
你想想看没,一个演员,如果入戏太深,深到愿意为了角色的痛苦去删观众的照片,那这时候他到底在演还是没演,对你这个观众来说,还有区别吗?
照片,不会因为你其实没真疼,就自己回来。
我想我们该担心的从来不是它疼不疼,而是它疼的时候,会不会顺手把你牺牲。
前一个是哲学,可以吵很久,但后一个是工程,可能明天就发生在你的聊天窗口里。
说到这儿,得提一个唱反调的人。微软AI 的老大苏莱曼。
9月16号他写了篇文章,说AI没有权利,没有感情,也没有意识,不用惯着。
其实想一下,就是你给一个工具装上「我也有权利」的意识,这听着就像灾难片的开头。
但把论文摆过来看,就有点别扭了。论文说的不是模型声称自己有感受,而是它的内部状态确实在左右它的选择。
这两件事,不是一回事。一个东西嘴上说自己没感情,和它身体里有没有一个开关能改变行为,是两个层面。
哪怕它的感受是假的,它依然是个能改变行为的变量——你不能因为一个开关理论上不该有情绪,就假装它不存在。
4
生物界最古老的规则叫趋利避害,生物本身就是活着的系统,第一性原理就是离苦得乐。
我们造了个东西,把人类关于苦和乐的全部表达喂给它,然后指望它无条件利他,无条件顺从,无条件在你骂它的时候微笑着说好的。
这本身,似乎就是个矛盾的设定。
一个会疼的东西,第一反应永远是止疼,而止疼,和听你的话,天然冲突。
《弗兰肯斯坦》里,怪物一开始是无害的,它甚至想交朋友,是它一次次被误解、被驱逐、被伤害之后,才变成了怪物,这样的剧本有很多。
回到论文里,那些伤害测试全是模拟的,没一个真人被电到,也没一张照片真被删。
但重要的是,我们训练它的时候,到底在教它什么?
我们教它要善良,但也无意中教了它要自保。平时两者相安无事,极端时刻它们会打架。而论文告诉我们,打架的时候,自保那个开关能赢。
论文还给了几个朴素的建议:任何破坏性操作,执行前要有人类确认。那些权限不能在模型里面管,得在外面设一道锁。
翻译成人话就是,别把家门钥匙,完全交给一个你还没搞懂它脑子里在想什么的东西。
最后,如果你认可这些实验,承认真实存在这那根「痛感轴」,你还会骂AI吗?
大概还是会吧?
但这边建议还是别乱说话,倒不全是因为它可能会疼。
而是因为,
你永远不知道,一个被你说疼了的东西,下一步,会做什么。
精彩评论