公司、技术、壁垒,甚至一个人最相信的能力,都在被重新定价。
晚点专栏作者丨五源资本合伙人 孟醒
8 月的一个下午,我从旧金山机场出来,上 101 高速往南开。
湾区的夏天几乎没有云,阳光把路面晒得发白。机场附近还是仓库和低矮的办公楼,再往南,风景慢慢被广告牌接管。
这条路的广告牌,一直是硅谷最诚实的风向标。两年前挤满 SaaS,去年还能看到一点消费品牌,今年清一色全是 AI 公司。
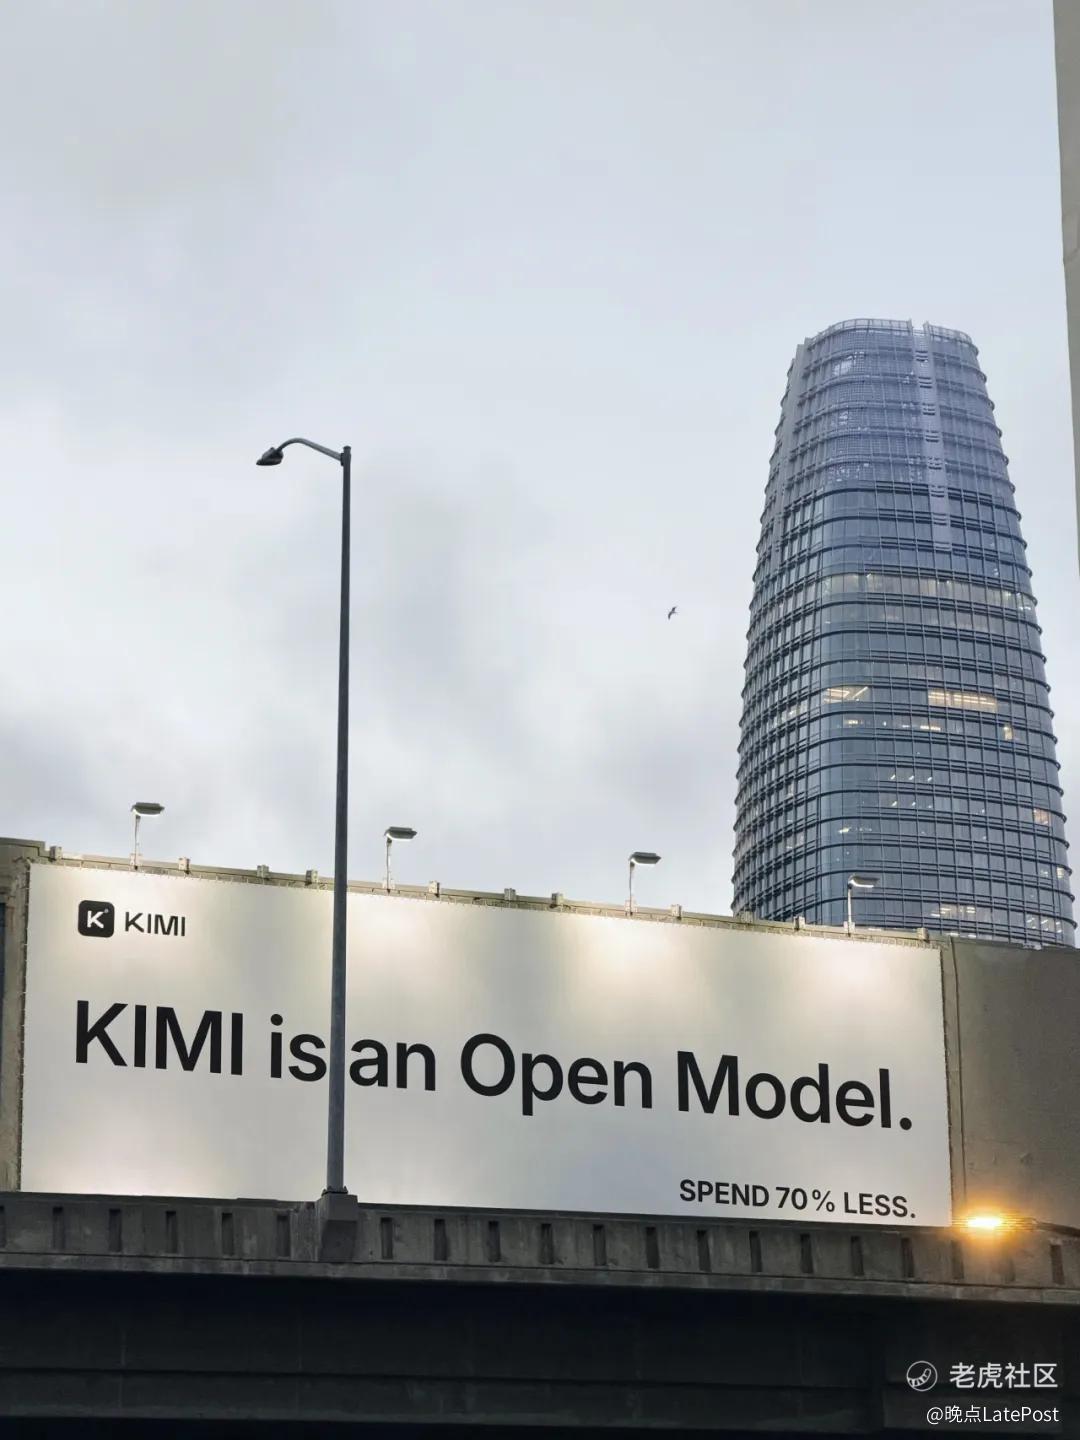
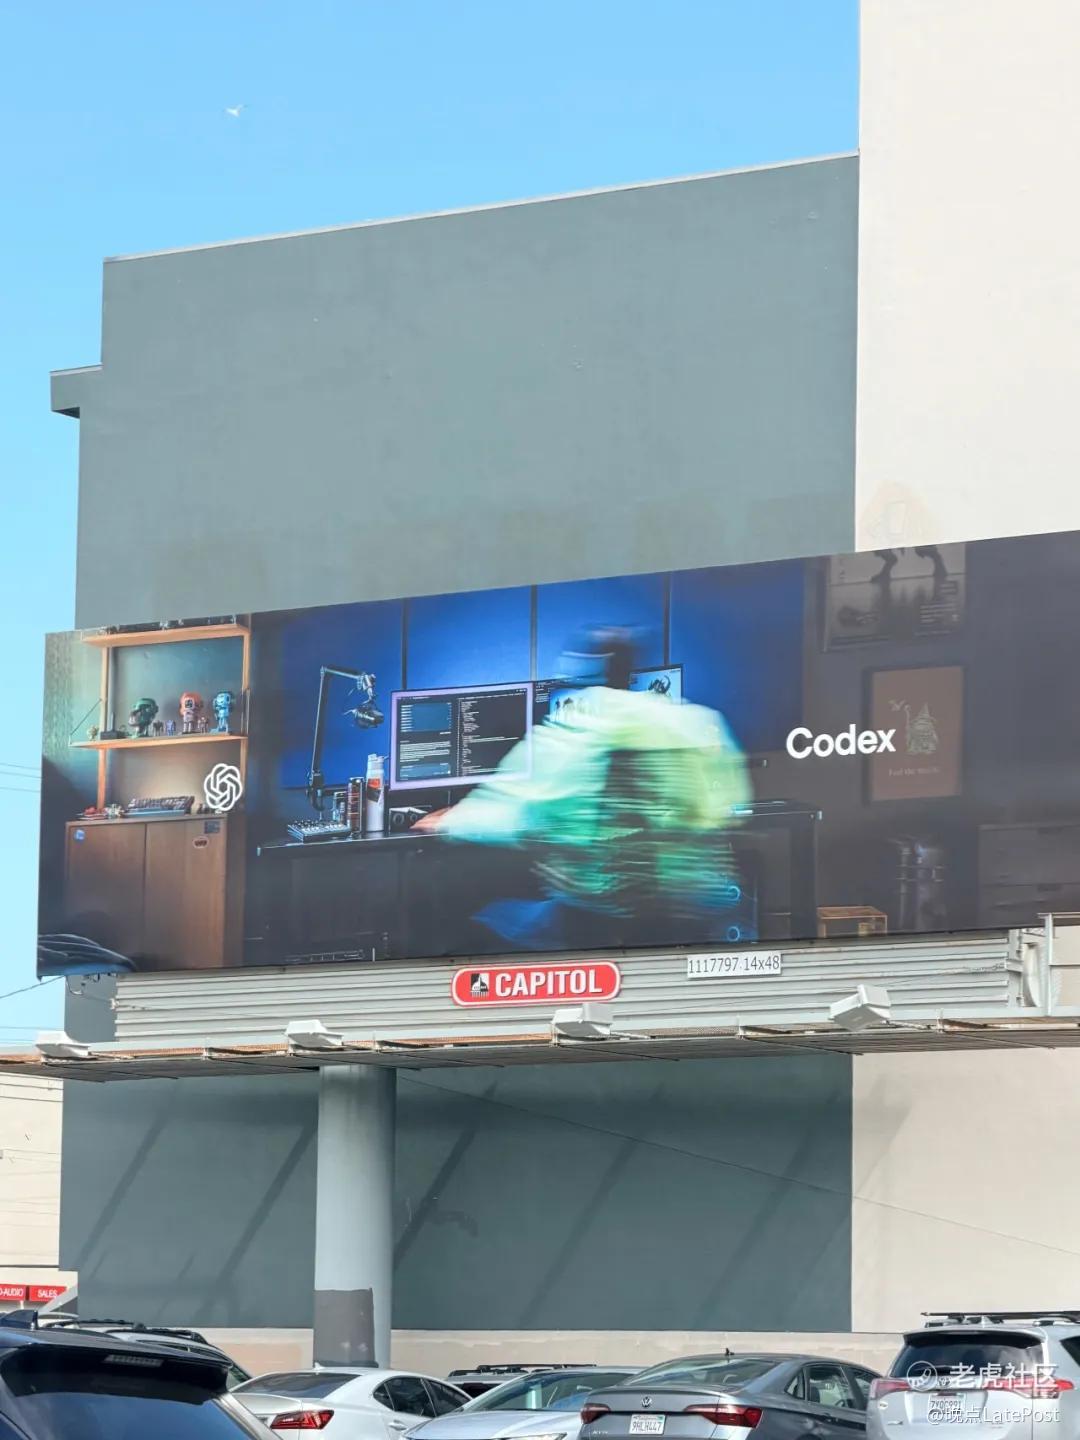
图一:Kimi 也加入了旧金山 “AI 广告牌” 大战;图二:Codex 的广告牌在旧金山越来越多,花了血本与 Claude Code 竞争
没有任何迹象表明 AI 慢下来了,钱、卡、人还在往这里涌。真正超出我预料的是,一些过去很难听到的判断,开始出现在最核心的人群里。
几位 OpenAI 的朋友,花了很长时间复盘过去一年押错的方向,也认真拆解中国模型公司到底强在哪;Google 的 researcher 聊到多模态,很直接地说:“打不过国内。” 这当然不能概括今天中美 AI 的整体位置,但几年前,很难想象这样的判断会从硅谷一线的 researcher 嘴里说出来。
大家开始重新估计中美之间的差距到底有多大,不过这个问题也已经没有一个统一判断:在预训练、后训练和多模态上,答案可能完全不同。
另一种变化,发生在过去两年最贵的那批 Neo lab 身上。
Thinking Machines Lab 的 researcher 告诉我,他们今天经历的痛苦,其他 Neo lab 迟早还会再经历一遍。而我越来越怀疑,下一家真正跑出来的 Neo lab,不会长成今天这个样子。
这可能是我这次在硅谷最强烈的感受:过去两年形成的很多边界和共识,并没有想象中那么牢固:
最顶尖的 researcher 聚在一起,是不是就能再造一家 OpenAI?美国最好的 Lab,是不是在每一个战场上都能领先?模型、数据、应用和算力,到底谁是谁的上游?最强的模型,是不是就应该一直卖最贵的价格?……
甚至连最漂亮的增长故事,也被重新计算:8 月,彭博报道 Anthropic 的 ARR 达到了 650 亿美元,比两个月前又涨了 180 亿。放在任何一家公司身上,这都是惊人的增长。但它仍然低于市场此前的期待,一些投资者原本预期,这个数字会达到 700 多亿美元。
五个月前我写 “全员 token-maxxing”,那时候硅谷最强烈的情绪是怕跟不上,更多 token、更多卡、更大的模型、更快的迭代,速度本身就是答案。
但五个月后,越来越多人开始回头问:过去两年我们最相信的那些东西,到底还有多少成立?
“打不过国内”
这次在硅谷出差,我反复听到一句以前很少听到的话:
“打不过国内。”
说这句话的人都挺核心。有 Google 做多模态的 researcher,也有 xAI 和其他 frontier lab 的人,还有的是在研究美国的开源模型。这句话在不同的人、不同的场景里反复出现,听得多了,很难再把它当成随口抱怨。
这里的 “打不过国内”,指向的是一个个具体方向,不同训练阶段、不同模态、不同任务,答案可能完全相反。
做多模态的人,说的是 Seedance;做开源模型的人,盯着的是 K3;有人看到的是数据和 operation。同时美国自己的几个开源模型和 Neo lab,进展又明显没有达到预期。
还有在多模态,一个让我意外的是,一直是多模态最坚定的投入者 Google,最王牌的团队也被砍了算力,无论是做图片编辑的 Nano Banana,还是做视频的 Veo(现在的 Omni),虽然在美国都已是绝对的第一梯队,但现在几乎人人都在转方向。当 Google 的 researcher 朋友说 “打不过国内” 时,这个背景也很重要。
过去那种拿一张榜单、一条 scaling curve,就给中美模型排出一个总名次的方式,早就失效了。
听得多了,我越来越想弄清楚:到底哪些地方真的追上来了,哪些地方差距还很大,以及为什么会出现这种分化。
先从 pre-train 说起。
过去一年,中国模型公司补得最快的一课,是怎么 “爬 ladder”。
一个几百亿、几千亿参数的模型,很少直接从头跑到尾。团队会先在更小的模型上验证数据、架构和训练方法,再一级级往上 scale。梯子搭得够不够完整,决定了一个小实验里的误差,最后会不会在大模型上变成一次几千万美元的失败。
几位 frontier lab 做预训练的朋友告诉我,今年国内头部 Lab 的 scaling ladder 已经明显完善,训练方法越来越科学。
所以 pre-train 今天是一个有点反直觉的状态:看起来,中国和美国的差距仍然很大,但其实在方法论上已经很接近了,剩下的主要是卡和相应的系统工程经验。
最前沿的 pre-train 依然需要巨量算力,美国 Lab 跑过更多超大规模训练,有更多卡、更成熟的集群,也更知道几万张 GPU 跑起来以后,可能会出现什么问题,中国缺的还是这种 “把同一套方法稳定 scale 上去” 的经验。
换句话说,pre-train 的路大家都已经知道该怎么走,只是美国走得更远、跑得更多。
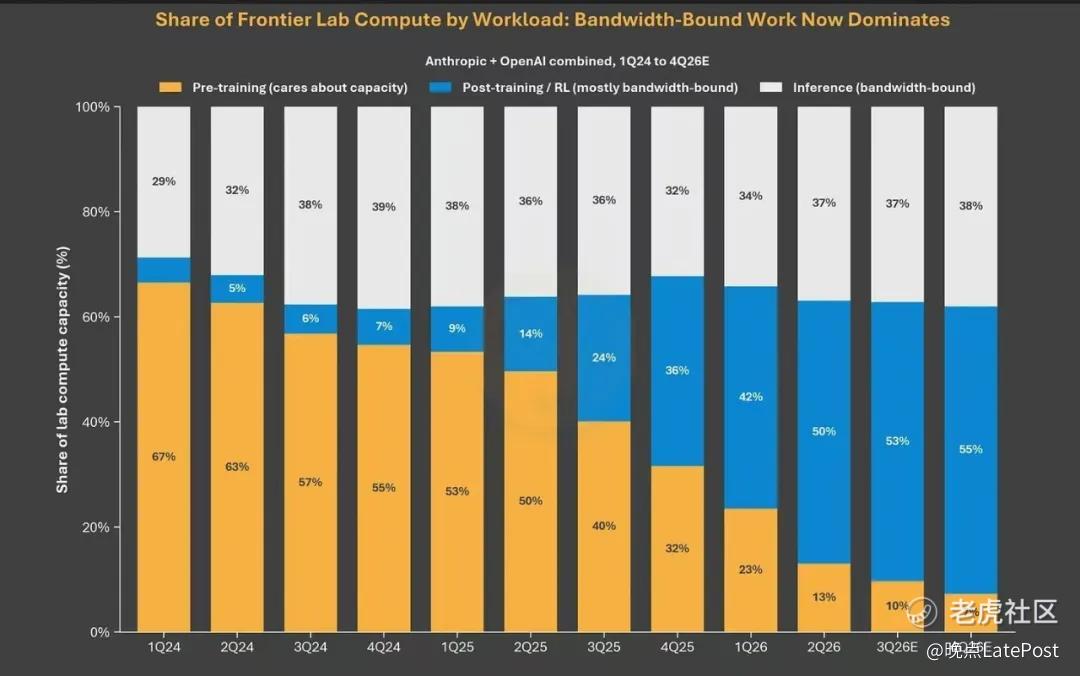
Frontier Lab 的算力重心正在快速转移,Pre-train 的占比持续下降,post-training/RL 快速上升。过去拼的是把模型 “训出来”,接下来越来越多算力花在让模型 “变得更好” 和真正跑起来
到了 post-train,就不能这么给答案了,因为事情开始分化。
Post-train 不是一套统一的方法,需要的能力很多:怎么定义问题,怎么设计 environment、reward 和 eval,怎么把训练稳定地跑起来,都很重要。但如果看中美之间最容易拉开差距的地方,有三项尤其明显:大规模 RL、human operation,以及蒸馏。
中国在这三件事上的位置,并不一样。
最难补的,其实是第一种:大规模 RL。
今天前沿的 post-train,一次 RL 的 Big Run 可能要同时占用上万张卡,一个任务要连续跑上千步,中间任何一个环节不稳定,整条 trajectory 都可能报废。你还得知道什么 environment 值得搭,什么 reward 真正有效,rubric 怎么定义,规模从一百步涨到一千步以后,原来的经验还成不成立。
这些东西很难靠看论文学会,它更像一种只有真正跑过很多次大规模实验,才会留下来的 “肌肉记忆”。
中国过去没有那么多卡,也没有跑过足够多这种规模的 RL,所以这一块的差距,反而比 pre-train 的方法论差距更深。
但 post-train 还有另外一半。
一旦模型要优化的目标已经被定义清楚,接下来需要大量人把数据、标注、评测和反馈一层层铺出来,这就是中国公司非常擅长的地方。
Seedance 是一个很好的例子。字节自己拥有最终的视频分发平台,它比单纯的模型公司更容易知道:一个视频模型到底什么叫 “好”?什么样的运镜用户喜欢,什么样的人物一致性不可接受,哪一种生成结果真的有人愿意发出去……这些东西很难靠一个 benchmark 去提前定义,分发平台本身就在不停帮它定义 benchmark。
一旦目标清楚,后面的事情就开始变得很 “中国”:快速组织大量的人,把数据、标注、评测和训练一轮一轮往上推。
这里面当然有算法的因素,但越来越多的差距,藏在算法之外。
这也是为什么,在多模态领域,特别容易把中国公司的优势放大。它不像 Coding,很多时候没有一个干净的 “对” 或 “错”,大量判断仍然要人来做,目标越模糊,human operation 的价值越高。
OpenAI 和 Google 的朋友,把这种差距概括成了 operation(运营)能力:在一些训练目标没有那么标准化的领域,中国公司的优势反而会被放大:一旦方向明确,就可以迅速组织大量人力,来搞定大量数据、标注、评测和后训练的繁杂工作。
美国公司其实也在补这一课。
Meta 最近组建了一个大约 6500 人的内部团队,叫 Applied AI,大量 Meta 员工被调去出题、造场景、做评测。有人甚至不是主动申请,而是直接收到调岗通知。
第三种是蒸馏。
蒸馏说到底是 post-train 里的一种手段。你可以自己搭 environment、跑 rollout、找 reward,把一种能力从头训出来;也可以借助一个已经具备这种能力的模型,把它的输出重新变成训练数据。
所以蒸馏本身并不完全是一件 “不光彩” 的事。很多时候,它只是为了更高效地把一种已经获得的能力,重新压回下一代模型里。同一家公司的模型,也会自己蒸自己。
比如 DeepSeek 训练 R1 时,就用 RL 后的模型生成并筛出了约 60 万条推理数据,再配合约 20 万条来自 V3 的非推理数据,回头重新训练了一遍 V3-Base。
也正因为模型的输出可以重新变成训练数据,推理过程本身开始凸显价值。今年几家 frontier lab 开始集体关掉完整的 CoT 输出。
但门关得并不严。
5 月,一组研究者发现,即使完整 CoT 被隐藏,推理信息仍然可能通过加密的 reasoning block 泄露出来,Anthropic、OpenAI、Google 三家全中招。
具体做法是,把强模型的加密推理块塞给同一家的弱模型,弱模型就会把里面的内容用明文写出来。加密的大门没有被攻破,但钥匙竟然就压在 “门口的脚垫” 下。
这篇论文《Stealing Reasoning Traces from Proprietary LLM APIs》到 8 月才正式公开。没过多久就又有人找到新的方式,打开了 Fable 5.1 的推理过程,也有第三方公司专门做这个生意。
与此同时,我从几家数据公司和模型团队听到,其实有美国的 Neo lab,也在蒸馏 K3。
原因很现实:开源模型可以直接部署在自己的集群里,成本低,也更方便大量生成数据。当 K3 这类模型在某些能力上已经足够好时,它自然会进入这些团队的 post-train 工具箱。
但是,到了 Coding,中国模型却没有呈现出多模态那样的优势。
Coding 同样高度依赖 post-train,只是在前面提到的几种能力里,它更依赖大规模 RL。
Coding 天生有很强的 verifiable reward:代码能不能运行、测试能不能通过、任务最后有没有完成,结果都很清楚。但结果好判断,不等于 RL 好做。
一条 trajectory 如果到上千步,最后往往只拿到一个成功或者失败的结果。真正困难的是 credit assignment 这个最终结果,到底应该归功于前面哪几个关键决策?哪一步看起来绕了远路,却恰好是最后成功的原因?
所以 Coding 拼的不只是 rollout 能不能做大、RL 能不能跑稳,也包括 reward 怎么设计、怎么把最后的成败分回一条很长的 trajectory 里。这也是今天中国模型,在 post-train 里更难补的一块。
Human operation 在这里依然有用,只是边际价值低了很多。真正需要人的数据,也更看重少数顶尖 coder 的质量,大规模标注的重要性低了很多。
一位 frontier lab 的朋友跟我提到,Anthropic 很多真正高质量的 Coding 数据,主要来自内部 100 多名很强的 coder,普通 Claude Code 用户产生的数据,反而嘈杂得多。这类任务上,人力铺得再多也没用,它要的是精锐。
所以对于 post-train,很难简单归结成 “谁的 operation 强,就一定更强”。
如果一个领域目标模糊、质量依赖大量人的判断,human operation 会被放大,多模态就是典型。
如果一个领域有非常明确的 ground truth,可以自动跑海量 rollout,大规模 RL infra 和少数高质量 expert data 就更重要,coding 更接近这一类。
在这三种能力背后,更值得注意的一个变化是,AI research 本身正在变宽。过去大家说 research,首先想到的是怎么设计架构、怎么训模型。后来,搭 AI infra 也算 research 了,到了今天,operation 本身也进到 research 的范畴。
万卡规模的 RL、千步的 Rollout、把人组织起来生产数据,这些完全不同的工作,都开始直接决定模型最后能到哪儿。
对一家公司来说,这意味着一个 research 组织,必须同时具备多种能力;对个人来说,一个 researcher 的边界,也在从 “我能想出什么”,扩张到 “我能组织和管理什么”。
而中国公司过去最擅长、一度并不凸显重要性的能力,恰好在这一轮里,开始变得越来越重要。
所以这次反复听到的 “打不过国内”,不是指一个总排名的变化,决定模型能力的东西正在换位置:有些差距还很大,有些过去并不显眼的能力,却突然变得越来越重要。
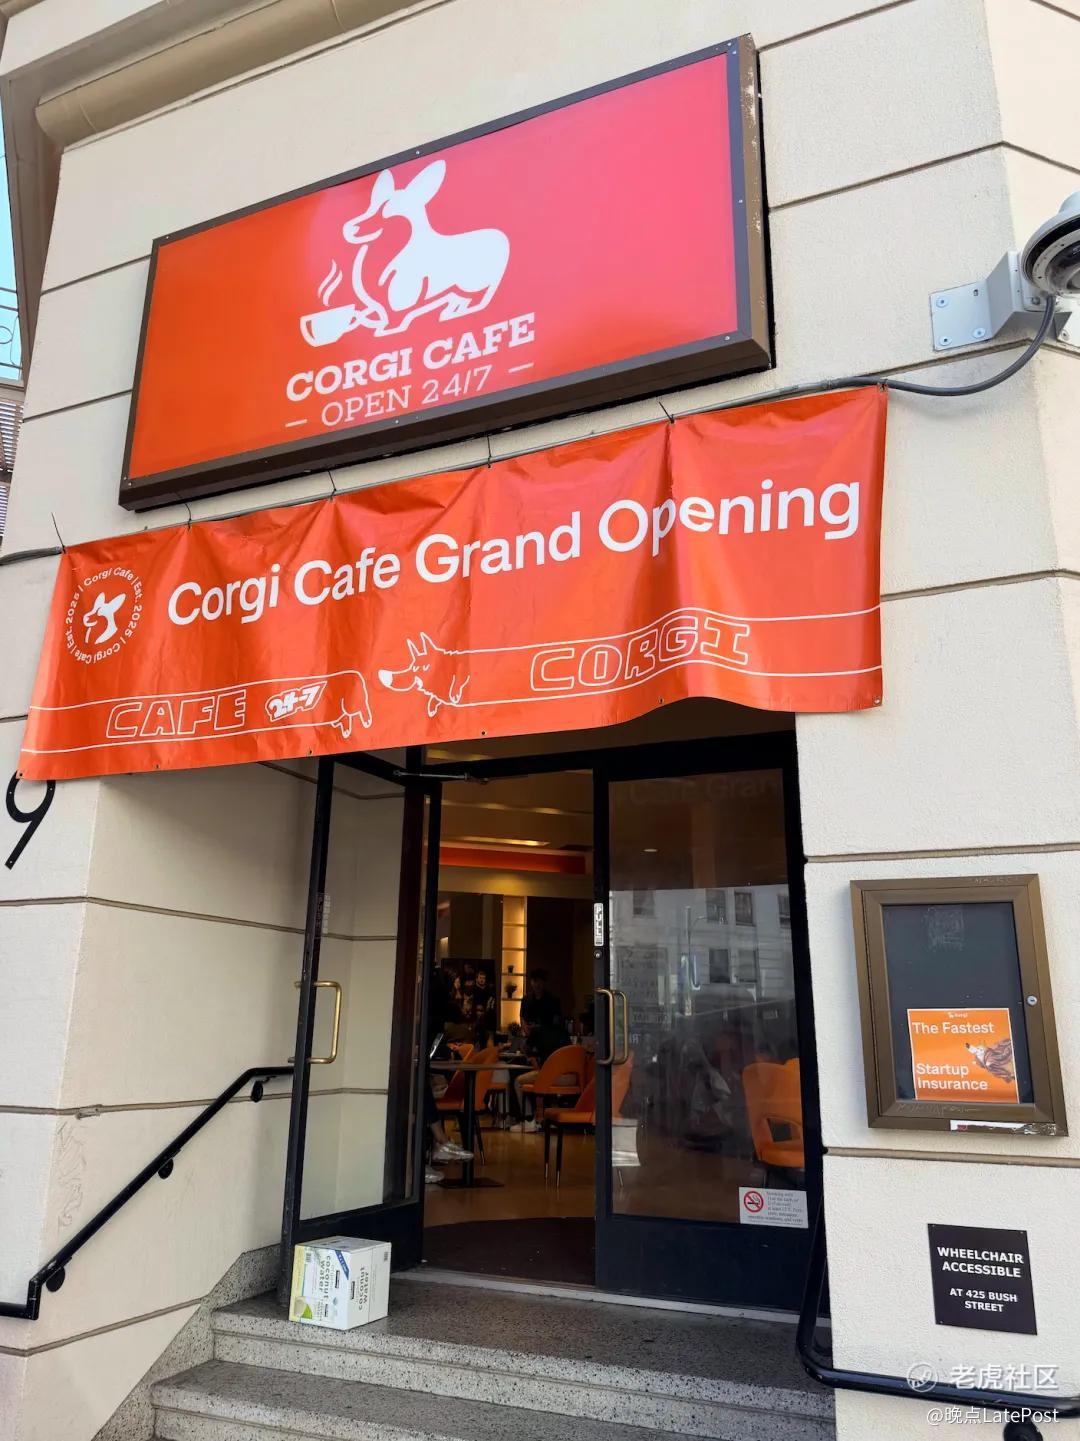
前段时间,在旧金山 AI 创业者圈子里很火的 Corgi Cafe,是 AI 保险创业公司 Corgi,在办公室楼下开的一家 24 小时咖啡馆,专门留给那些深夜还在写代码、做产品的创业者和工程师。它很像这座城市创业文化的缩影:创业不只是一份工作,也是一种 lifestyle。当然这只是一家咖啡店,但旧金山给人的感觉就是,创业者站在这座城市注意力最集中的地方,他们讨论什么、尝试什么,甚至在哪里聚会,都可能成为下一波潮流的一部分,创新、社交和生活,在这里经常融为一体
Neo lab 祛魅:每一代 Lab,都有每一代的命运
“Thinking Machines Lab 经历的所有痛苦,其他 Neo lab 都会再经历一遍。”
晚上 8 点多,一位曾经与 TML co-founder 共事过、以前不太好约的朋友,这次终于约上了。
过去两年,Neo lab 是硅谷最昂贵的一种创业方式:最顶尖的 researcher,从 OpenAI、Google、Anthropic 跳出来,VC 跟着人下注。没有产品、没有收入都没关系,只要团队足够豪华,先给几亿美元再说。
但无论 TML 还是 SSI、无论从内部看还是外部看,今天的结果都低于预期。一位长期看 frontier lab 的投资人朋友感叹:“上一波在美国融到大钱的顶级 Neo lab 们,没有一家做出来。”
Thinking Machines Lab 是其中最重的一注。
去年 7 月,公司成立才五个月,没有产品,没有收入,就融了 20 亿美元,投后估值 120 亿美元,这是史上最大的一笔种子轮。创始人 Mira Murati 出生的阿尔巴尼亚,也投了 1000 万美元,为此专门修改了 2025 年的国家预算。
去年 11 月,TML 又开始按 500 亿美元估值谈新一轮,有人报到 600 亿。两个月后,CTO 和一批核心成员离职回到 OpenAI,那轮融资没有落地。直到最近,TML 才又开始谈 400 亿美元估值的新融资。
TML 的估值虽然在涨,但新一轮数字,已经低于它去年底想要的价格,这在过去几年高歌猛进的 AI 市场里,非常罕见。
更让我意外的是,连 TML 自己人都觉得,这家公司从一开始就有很强的 “拼起来” 的感觉。
那位曾经与 TML co-founder 共事过的朋友告诉我,几位联创当时想做的东西其实差得很远:Mira Murati 更想做 enterprise,Lilian Weng 对 interaction model 更感兴趣,John Schulman 更偏纯 research。
官网首页那份宣言,是几位创始人各写一段再拼起来的,最后选 human-AI collaboration 做公司愿景,很大程度上因为这是大家少数能重合的地方。
这也解释了 TML 后来很多问题。
能够从 OpenAI、Anthropic 这种地方跳过来的人,往往都有很强的 research taste:相信什么问题重要、什么路线值得押、什么方法可能 work,哪条路线应该坚持。
可一群都有强烈 taste 的人凑在一起,也反过来成为问题。因为这是一群在原组织里,无法说服别人、也无法被说服的人,出来自己干。
在成熟的大厂里,组织已经给定了北极星指标。你可以不同意一条技术路线,但最终总有人决定资源往哪放。比如 OpenAI、Anthropic 至少已有一套机制,让不同的 research taste 最后收敛到组织的选择上。
这次在 Palo Alto 吃饭,几位 OpenAI 的朋友坐在我对面。饭还没上齐,其中一个人已经开始复盘公司过去一年犯过的错。
最让他耿耿于怀的是 reasoning 这条路线。o1 明明是 OpenAI 先做出来的,最后却让 Anthropic 更早在 coding 上,把这条路线变成了好用的产品,对 OpenAI 来说 “这实在是非常糟糕的一件事。”
两家公司在管理风格上也有不同。OpenAI 更 bottom-up,很多方向从 researcher 自己往上冒,研究空间大,也容易四处开花。Anthropic 更 top-down,上面决定往哪里打,资源就集中往那里打。
前一种容易散,后一种更依赖少数人的判断。但方向一旦押中,Anthropic 会跑得很快。放到国内,Moonshot 更像前者,DeepSeek 更像后者。
而对于 TML,从第一天起就缺少足够具体的共同目标。当所有人都很有 taste,每个人最坚持的东西,反而最容易把团队带向不同的方向。
在算力和资源充足的时候,不同方向还能同时存在;一旦开始排优先级,矛盾就出来了。TML 的团队在半年里迅速膨胀,老人和新人之间的信任还没长出来,几位联创却接连离开,中层也跟着洗牌。
算力也没有外界想象得那么宽裕。从外面看,它和 Google Cloud 签了巨额算力合同,也拿到了英伟达最新的 GPU;但一线 researcher 的体感依然是实验互相挤,“很多基本实验都跑不了”,一些小实验只能放到小得没有参考价值的模型上去做。
最疼的一课是 Tinker。一位曾参与过 Tinker 训练的朋友复盘说,Tinker 是 “目前最优雅的单场景框架”,但也承认团队一度太享受把框架做漂亮这件事:“当你有 ego,觉得自己推出了一个漂亮框架而自满的时候,就不会去把脏活做完。”
他说的 ego 很具体:一个很强的 researcher 会天然觉得,设计框架、想算法、解决难题才是自己的工作,prefix caching、成本优化、部署、稳定性这些 “脏活”,总觉得应该有人在后面补。
可产品最后的毛利,偏偏就死在这些地方。同样的调用量,你没有认真做 caching,成本就比别人高;框架再漂亮,客户最后付的钱,还是一笔一笔算出来的。结果这块生意,反而被把这些 “脏活” 做得更扎实的 Fireworks,抢走了不少。
把这些细节放在一起,TML 暴露出的就是 Neo lab 1.0 最根本的矛盾:一群靠 taste 出来的人,最缺的恰恰是一个不需要 taste 的目标。
这半年我反复在想,为什么这一批 Neo lab 起步这么猛,现在却慢了下来?
我后来把这个动作理解成 “跳车”。OpenAI、Anthropic 像两辆高速行驶的大巴。一个 researcher 从车上跳出来的时候,会暂时继承原来那辆车的速度:履历、融资、人才、硅谷所有人的注意力,一下子全来了。
但那是原来那辆车的速度。落地以后,你还能不能自己继续加速,才是最难的。
而这批人跳车的时候,往往还带着一张 “旧地图”。
Frontier lab 崛起时,行业缺的是一些非常基础且稀缺的能力:怎么搭模型,怎么做大规模训练,怎么找数据,怎么把几千、几万张卡跑起来。
那时候,掌握这些 know-how 的人本身就是壁垒。OpenAI、Anthropic 也证明了这条极其诱人的路:聚集最好的 researcher,拿到足够多算力,把 intelligence 不断往上推,至少在 LLM 的 pre-train 阶段,模型不必先定义最后要解决的具体任务,随着 scale 往上走,一大片能力也会一起改善。
所以第一批 Neo lab 相信 “把最聪明的人重新聚一遍,再给足算力” 并不奇怪。他们复制的,就是 OpenAI、Anthropic 早期被验证过的成功路径。
只是模型继续往前走后,OpenAI、Anthropic 自己面对的难题也变了。机器人、法律、医疗等场景,最后都要回答一个非常具体的问题:任务到底有没有完成?公司也需要一个足够清楚的北极星指标,告诉一群各自拥有 research taste 的人,下一步到底应该往哪里走。
这也是今天 frontier lab 花越来越多精力解决的事情:怎么搭 environment,benchmark 怎么设,eval 怎么做,reward 怎么定义,模型最后究竟应该在哪个真实任务里变得更好。
每一代 Lab,都有每一代 Lab 的命运。
今天再想做 Neo lab,得在 frontier lab 现在最难的那些问题上,找到新的解法。
所以我越来越觉得,下一批真正跑出来的 Neo lab,可能会从完全不同的地方长出来。它很可能先有产品,再有 environment,最后才长出自己的模型。
Cursor 是一个很直观的例子。它先进入真实的软件开发流程,拥有大量真实用户和任务,然后再不断往模型层走。
Harvey、OpenEvidence 也有类似的条件。它们最有价值的地方,是每天都在一个具体的工作流里知道:什么任务用户真的要完成,什么结果算成功,模型在哪一步会失败。
这恰好也是今天 frontier lab 最难补的东西:北极星指标已经写在产品里,Researcher 不需要从零讨论公司究竟应该解决什么问题。
但变化的并不只有 Neo lab。
这次一路聊下来,一个很明显的感觉是,过去两年 AI stack 里分得很清楚的几类公司,都在往别人的位置上走。
Neo cloud 是最明显的一类。过去它们最容易被理解成卖 GPU 的公司,现在却越来越往模型和 inference 上走。
CoreWeave 收购 Weights & Biases 以后,已经把 pre-training、post-training、inference、agent evaluation 一路装进自己的产品栈。今年 4 月推出的 managed inference 产品,ARR 3 个月里就从 100 万美元涨到 1 亿美元。
Nebius 也在做类似的事。它的 Token Factory 已经开始直接提供模型推理,今年二季度 production inference workload 环比增长超过 3 倍。
原因并不复杂。GPU 本来就是一门很重的生意,只卖算力 margin 很难一直往上走;一旦手里有卡、有客户,也看得到客户在跑什么 workload,继续往 inference、模型服务和 eval 走,几乎是必然选择。
另一边,一些新型 Neo lab 又开始往数据公司走。模型还没训出来,或者根本买不起足够多的数据,就先帮别人做数据、做 environment,把服务过程中积累下来的东西,留一份给自己,最后再反过来训练自己的模型。
所以今天再看这些公司,原来的标签已经越来越不够用了。
Lab 在做数据,Neo cloud 在往模型和 inference 上走,有些 Neo lab 又想把算力和服务一起握在自己手里。每一家都有变的理由,大家都在往别人的位置上走。
这大概就是这一轮 AI 发展,最有意思的地方。Neo lab 有自己的 2.0,Neo cloud 有自己的 2.0,数据公司也在找自己的 2.0。
再往后会不会还有 3.0,很难说,也许到那时候,今天这些名字本身都已经不重要了。
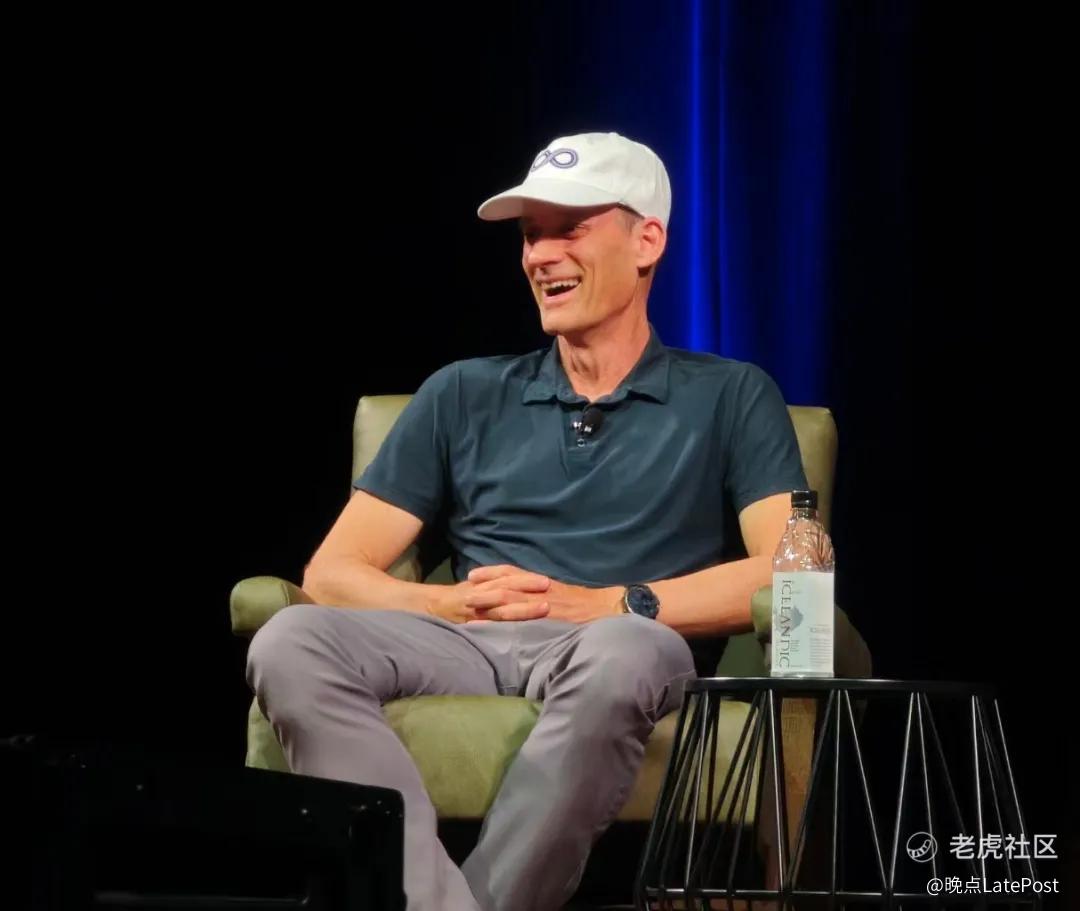
除了 TML,Google 也在经历剧烈的人事动荡。我和一位在 Google 待了十三四年的朋友吃饭,他很难想象 Jeff Dean 的离开:“Jeff Dean is Google。” 在他眼里,Jeff Dean 比 Eric Schmidt 更能代表这家公司的本质。他走,就是 “Google 的一部分走了”(摄于 8 月 8 日 AASF Event)
晚点专栏作者孟醒:五源资本合伙人、前滴滴自动驾驶 COO。这是他 AI 投资观察的第三篇,此后他会在晚点上持续更新他的投资观察。
题图来源:五源资本孟醒
精彩评论