上海交大、清华大学、字节、小红书、上海AI实验室联合发表的一篇论文,介绍通往真正递归自我改进即——「RSI」的路线图。
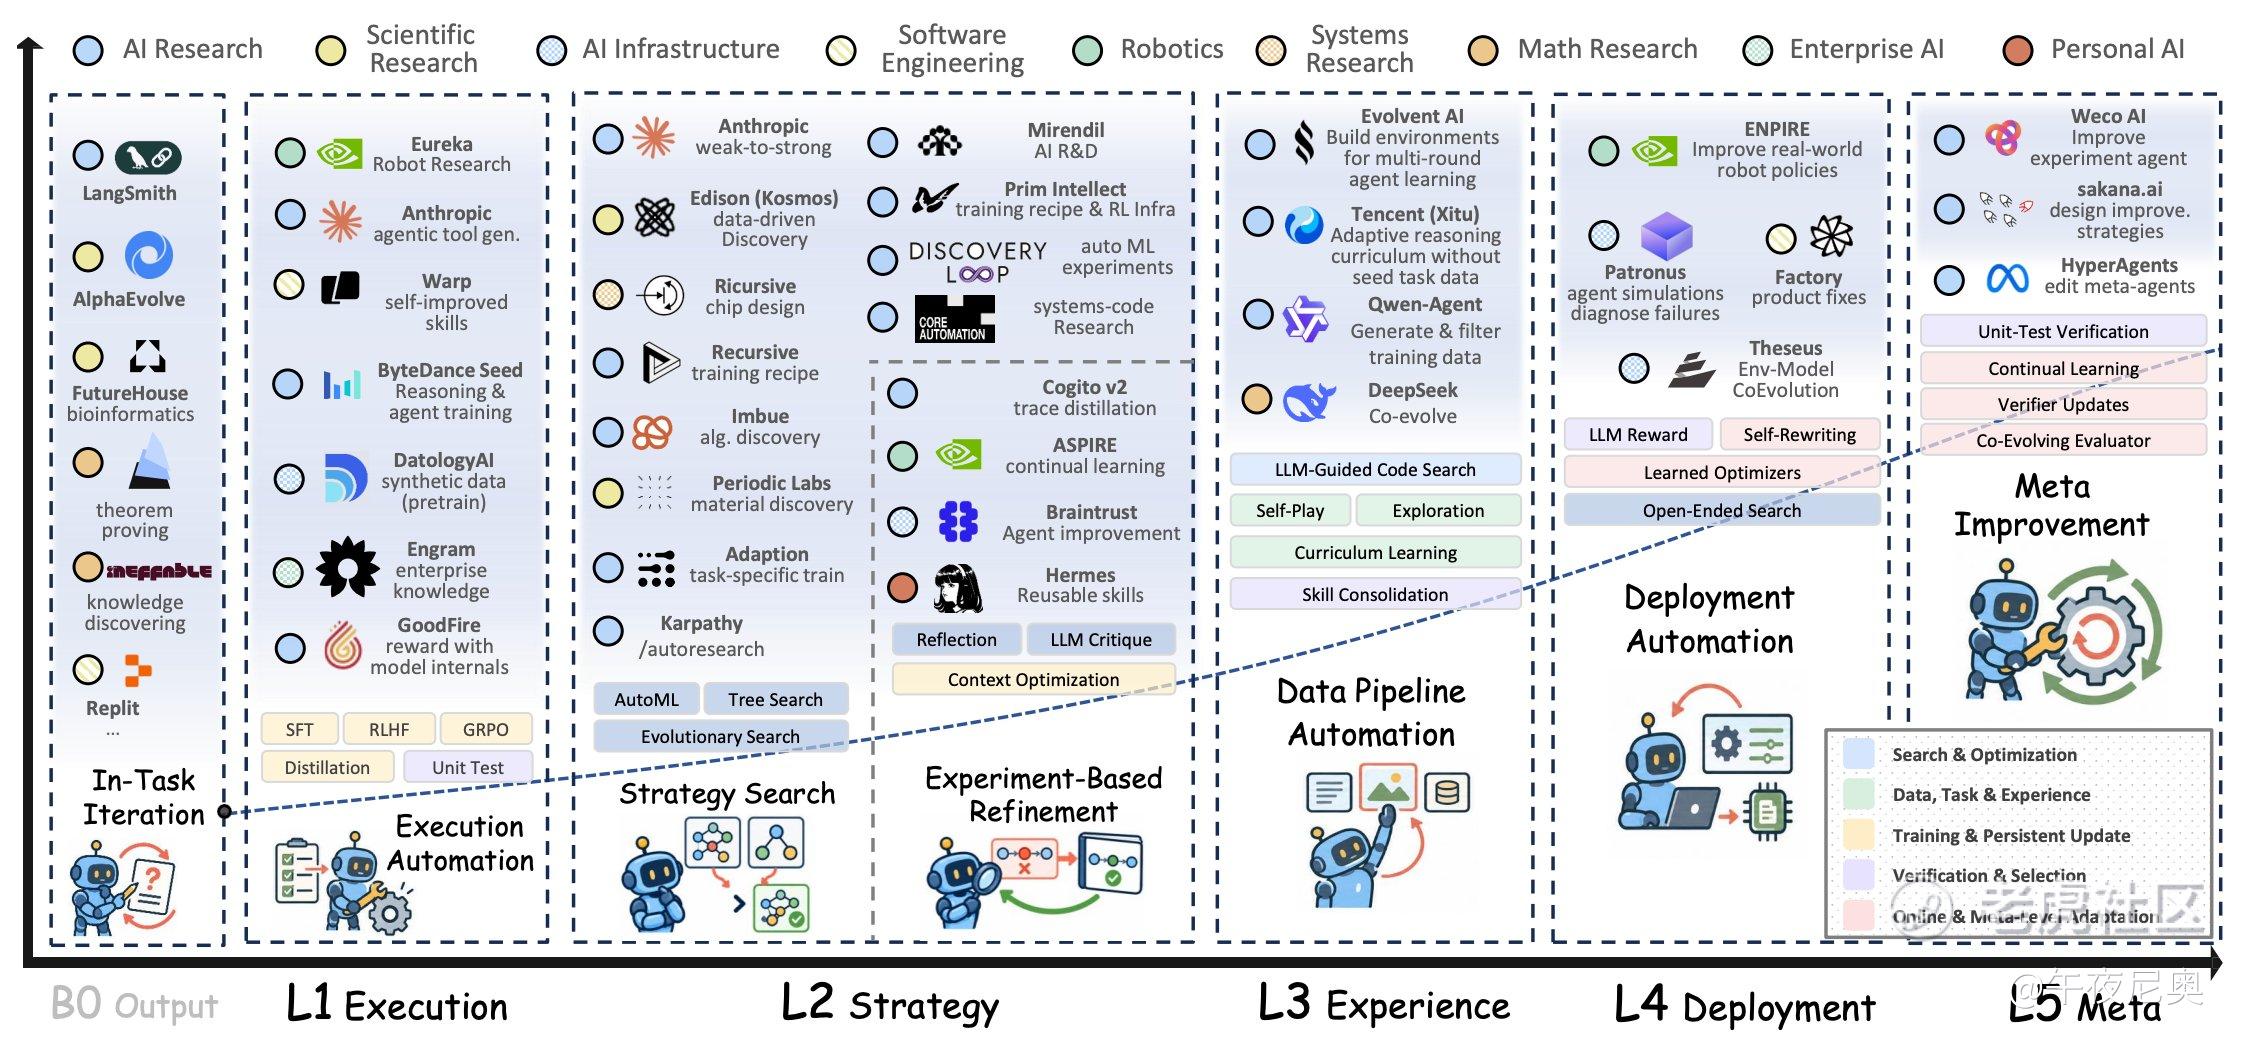
论文里的路径包括了五个层次,整体上是一个责任逐步转移的连续光谱,把RSI的落地路径理得很明白,从人类完全掌控改进流程(L1),到AI逐步接管策略、经验获取、环境适应,最终接管“改进机制本身”(L5)。
下面简单说说。
L1:执行层面的自主(Improvement-Execution Autonomy)
人类完全定义“改什么、怎么改、怎么验收”,AI只负责严格执行预定流程,并把通过验收的结果持久保存下来,供后续使用。
-
人类负责:设计任务目标、改进规则、实验环境、检查标准。
-
AI负责:按步骤执行、生成候选更新、保存成功结果。
-
典型例子:用模型按人类定义的“教育质量”标准给网络语料打标签(如FineWeb-Edu);自动执行固定的SFT/RLHF/蒸馏流程;在固定规则下跑AutoML实验并保存模型。
-
关键特征:改进结果跨任务复用,但改进方法本身完全由人写死。目前大量研究(约43.8%)仍停留在这一层。
这相当于“AI当熟练工”——人画好图纸,它认真施工并归档成果。
L2:策略层面的自主(Improvement-Strategy Autonomy)
这个阶段的目标和考核标准仍由人类掌控,但AI可以自己诊断问题,并主动从多种改进方案中挑选最有效的一种去尝试。
-
人类负责:最终目标、任务边界、评估标准。
-
AI负责:分析自身短板 → 生成/选择改进策略(如改提示词、改harness、改训练配方、搜索架构或GPU kernel)→ 执行并更新。
-
典型例子:Self-Harness用执行轨迹提出并测试对自身agent harness的修改;提示优化、架构搜索、训练规则搜索等。
-
关键特征:AI开始拥有“怎么改”的决策权,策略本身也可以被持久化沉淀。约31.6%的研究处于这一层。
这相当于“AI当初级工程师”——人给目标和KPI,它自己想方案并试错。
L3:学习经验的自主(Experience-Acquisition Autonomy / Future Learning Experience)
AI能感知自己当前的能力短板,并主动决定下一轮该学什么、练什么(自己生成或挑选最合适的练习任务/数据)。
-
AI不仅能执行和选策略,还能主动构建“缺什么就练什么”的经验获取过程。
-
典型能力:诊断弱点后生成针对性课程、合成数据、设计实验、筛选最有价值的训练样本。
-
关键特征:从“被动接受人类准备的数据/任务”转向“主动获取未来学习经验”。这一层开始出现更多“自己造题练自己”的闭环。
这相当于“AI开始自己制定学习计划”——不仅会做题,还知道自己该补哪块。
L4:实际环境中的适应自主(Environment-Adaptation Autonomy / Deployment Autonomy)
AI被部署到真实工作场景后,能从日常处理的实际问题中持续吸取教训,自动把经验整理成持久的工具库、技能集、记忆或代码修改,并影响后续所有任务。
-
不再局限于实验室固定基准,而是在开放、动态的真实环境中在线适应。
-
典型能力:根据真实反馈更新记忆、技能、harness、代码;持续巩固经验;让改动真正影响长期行为。
-
关键特征:改进从“离线实验”走向“在线部署闭环”,环境反馈成为主要信号源。
这相当于“AI在真实岗位上不断成长”——不仅实验室练得好,上岗后也能越用越强,并沉淀成自己的“经验库”。
L5:底层机制的元改进自主(Recursive Meta-Improvement)
这是最高境界。AI不仅提升具体技能,还能改造自己用来做研究、发现问题、自我训练的整套核心方法(搜索策略、评估器、研究流程等),并把更强的学习机制一代代传承给后续版本。
论文进一步把L5拆成两层:
-
形式上的递归:能修改负责后续改进的机制,并让下一轮继续沿用。
-
真正的越改越强:修改后的机制在相近资源与独立评测下,确实产生更强的下一代系统。
-
典型目标:修改“如何搜索改进方案”“如何评估进步”“如何做研究”这些元层面的东西。
-
当前状态:真正触及L5的研究极少(约5.9%,仅29篇左右),且长期稳定累积优势尚未被充分证明。
这相当于“AI开始改造自己的‘大脑操作系统’和‘进化算法’”——最终目标是让改进过程本身也不断自我进化,真正接近“人类建造的最后一个AI”。
整体理解与意义
这五个层次是一个责任逐步转移的连续光谱:从人类完全掌控改进流程(L1),到AI逐步接管策略、经验获取、环境适应,最终接管“改进机制本身”(L5)。真正的RSI要求改进必须持久、可传承、可验证,而不是单次对话中的临时修正。
目前产业和研究大多集中在L1–L2,L3–L4正在加速出现,L5仍是前沿挑战。论文强调,不同领域(科学发现、软件工程、具身智能等)的进度会差异很大,且需要严格的长期评测、资源约束和人类监督来验证是否真正实现了“越改越强”。
精彩评论