把最近各家旗舰的总参数排成一列,阶梯感非常清晰:DeepSeek V4 Pro 1.6T,美团 LongCat-2.0 1.6T,Qwen3.8 Max 2.4T,Kimi K3 2.8T,智谱的传闻区间 2.5-3.5T,再往后是各家嘴上不说、案头都摆着的 5万亿。竞赛没有停,但看点已经悄悄换了一轮。
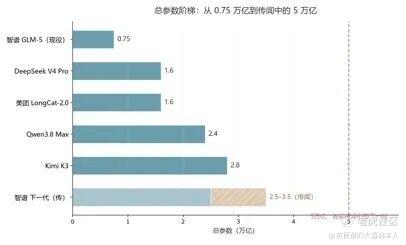
图2 各家旗舰总参数阶梯(万亿);斜纹为智谱传闻区间,虚线为 5 万亿传闻目标
(一)1.6万亿是个行业均衡点
DeepSeek V4 Pro(1.6T 总参、49B 激活、1M 上下文)和 LongCat-2.0(1.6T、约 48B 激活、动态范围 33B~56B、1M 上下文)规格几乎重合。两家独立决策撞在同一档位,大概率不是心有灵犀,而是训练成本、推理成本和工程风险在这个规模附近达成了某种共识。
但两家的处境差很有信息量。DeepSeek 这边,4 月预览版上线时官方就把话说透了:受限于高端算力,Pro 的吞吐十分有限,要等** 950 超节点批量上市才能大幅降价;8 月正式版把 DeepSWE 从 12.8 拉到 62.7,证明模型本身在往上走,但 API 降价的预期被涨价预告取代。值得注意的工程细节是,V4 Pro 几乎是按** 950 的规格反向设计的:单卡 144GB HBM 可以放下全部专家权重,官方口径 8K 输入下单 token 解码时延约 20ms、单卡吞吐约 4700 TPS,处理百万上下文时新 token 所需算力只有 V3.2 的 27%,KV 缓存占用约 10%。换句话说,1.6T 这个档位不是拍脑袋,是“卡上放得下、服务跑得起”的经济学答案。
LongCat 这边的故事则是工程记录:全程国产卡、峰值超 5 万卡、35万亿 token 预训练零回滚、没有不可恢复的 loss spike,是国产算力上完成的最大训练任务之一;商业化上先匿名上 OpenRouter、调用量冲进全球前三再认领。一个被算力供给卡着,一个用算力记录说话,同一个档位,两种活法。
(二)2万亿的天花板碎了,但开源不等于普惠
“国内没有一家能完整稳定训完 2 万亿参数模型”这句话,先是被 Qwen3.8 Max(2.4T、激活 950 亿、Max 系列首次开放权重),接着被 K3 以 2.8T 成为全球参数最大的开源权重模型,先后送进了历史书。但开源的门槛从来不在许可证上:K3 在 MXFP4 精度下权重约 1.4TB,一台八卡 H100 节点只有 640GB 显存,单卡 144GB 的** 950 也放不下——部署门槛明摆着。定价同样说明问题:输出 100 元/百万 token,开源模型并没有打算只靠便宜取胜。官方承认整体性能和体验仍落后于 Claude Fable 5 和 GPT-5.6 Sol,这个坦诚本身是加分项;而圈内流传的“预训练数据没过完、硬上后训练”的说法,目前只是传闻。
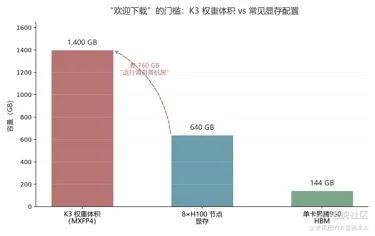
图3 K3 权重体积与常见显存配置对比(GB)
(三)真正的分水岭是稳定性
业内把训练失败统称“训崩”,粗分三种(表2):一是 loss spike,成因一大串,从 attention logit growth、output logit divergence、stale optimizer state 到数值溢出都有可能;二是 loss 不降,走平甚至走高,架构改动太激进、参数过大、不同卡的数值精度不一致都是嫌疑因素,且模型越大、每层梯度求和的溢出风险越高,踩中概率越大;三是后训练上不去,最贵的一种,只能下架重训。
表2 三种“训崩”对照(案例均为未证实传闻)
崩法
典型原因
代价
loss spike
attention logit growth、output logit divergence、stale optimizer state、bad batch×bad state、residual/norm growth、数值溢出
回滚重训,可控
loss 不降
架构太激进、参数过大、卡间精度不一致;模型越大概率越高
预训练停滞,或硬上后训练
后训练上不去
能力在后训练阶段无法继续提升
最贵:下架重训
有意思的是,这三种崩在近期的传闻里恰好各有一个对号入座的样本,三家无一幸免,也无一证实。这个现象本身比任何单一传闻都值得注意:参数爬到两万亿以上之后,稀缺的不是胆子,是稳定性。谁能把“稳定训完”变成可复制的工程能力,谁就拿到了下一轮的入场券。
智谱那个传闻区间值得单独拆开看,因为它刚刚完成一次改口:从 10 月发 1.6T 的旧说法,直接跳到现在的 2.5-3.5T,从单点报价变成区间报价,中枢上移接近一倍——这种轨迹通常意味着模型仍处在训练后期、规模没有定稿,区间的每次移动都伴随一轮预期重估。
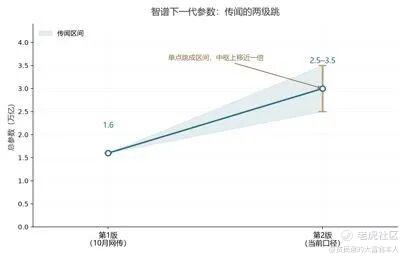
图4 智谱下一代参数:传闻的两级跳(万亿)
(五)上限在哪,取决于两个变量
传闻各家都在评估 5万亿规模的训练,且要在国产卡上实现。进度条卡在两处。一是算力供给:** 950 系列分 950PR 和 950DT 两个型号,超节点的量产节奏直接决定下一代模型的口径上限;单卡 144GB 放下全部专家权重这个特性,已经在改写 MoE 推理的经济学。二是数据:Anthropic 和 OpenAI 的反蒸馏措施(API 报错、上下文篡改)如果持续加码,靠蒸馏迭代的那条路会明显变窄,自建数据管线和后训练工程的价值被动放大。 $智谱(02513)$
精彩评论