如果把过去两年的AI新闻放在一起看,会发现一个明显变化:以前大家经常讨论“大模型训练用了多少GPU”,现在“推理成本”“Token价格”“推理算力”出现得越来越频繁。背后的原因很简单,AI产业正在从“把模型训练出来”,逐渐进入“让模型真正大规模工作”的阶段。理解这个变化,首先要搞清楚两个概念:训练(Training)和推理(Inference)。
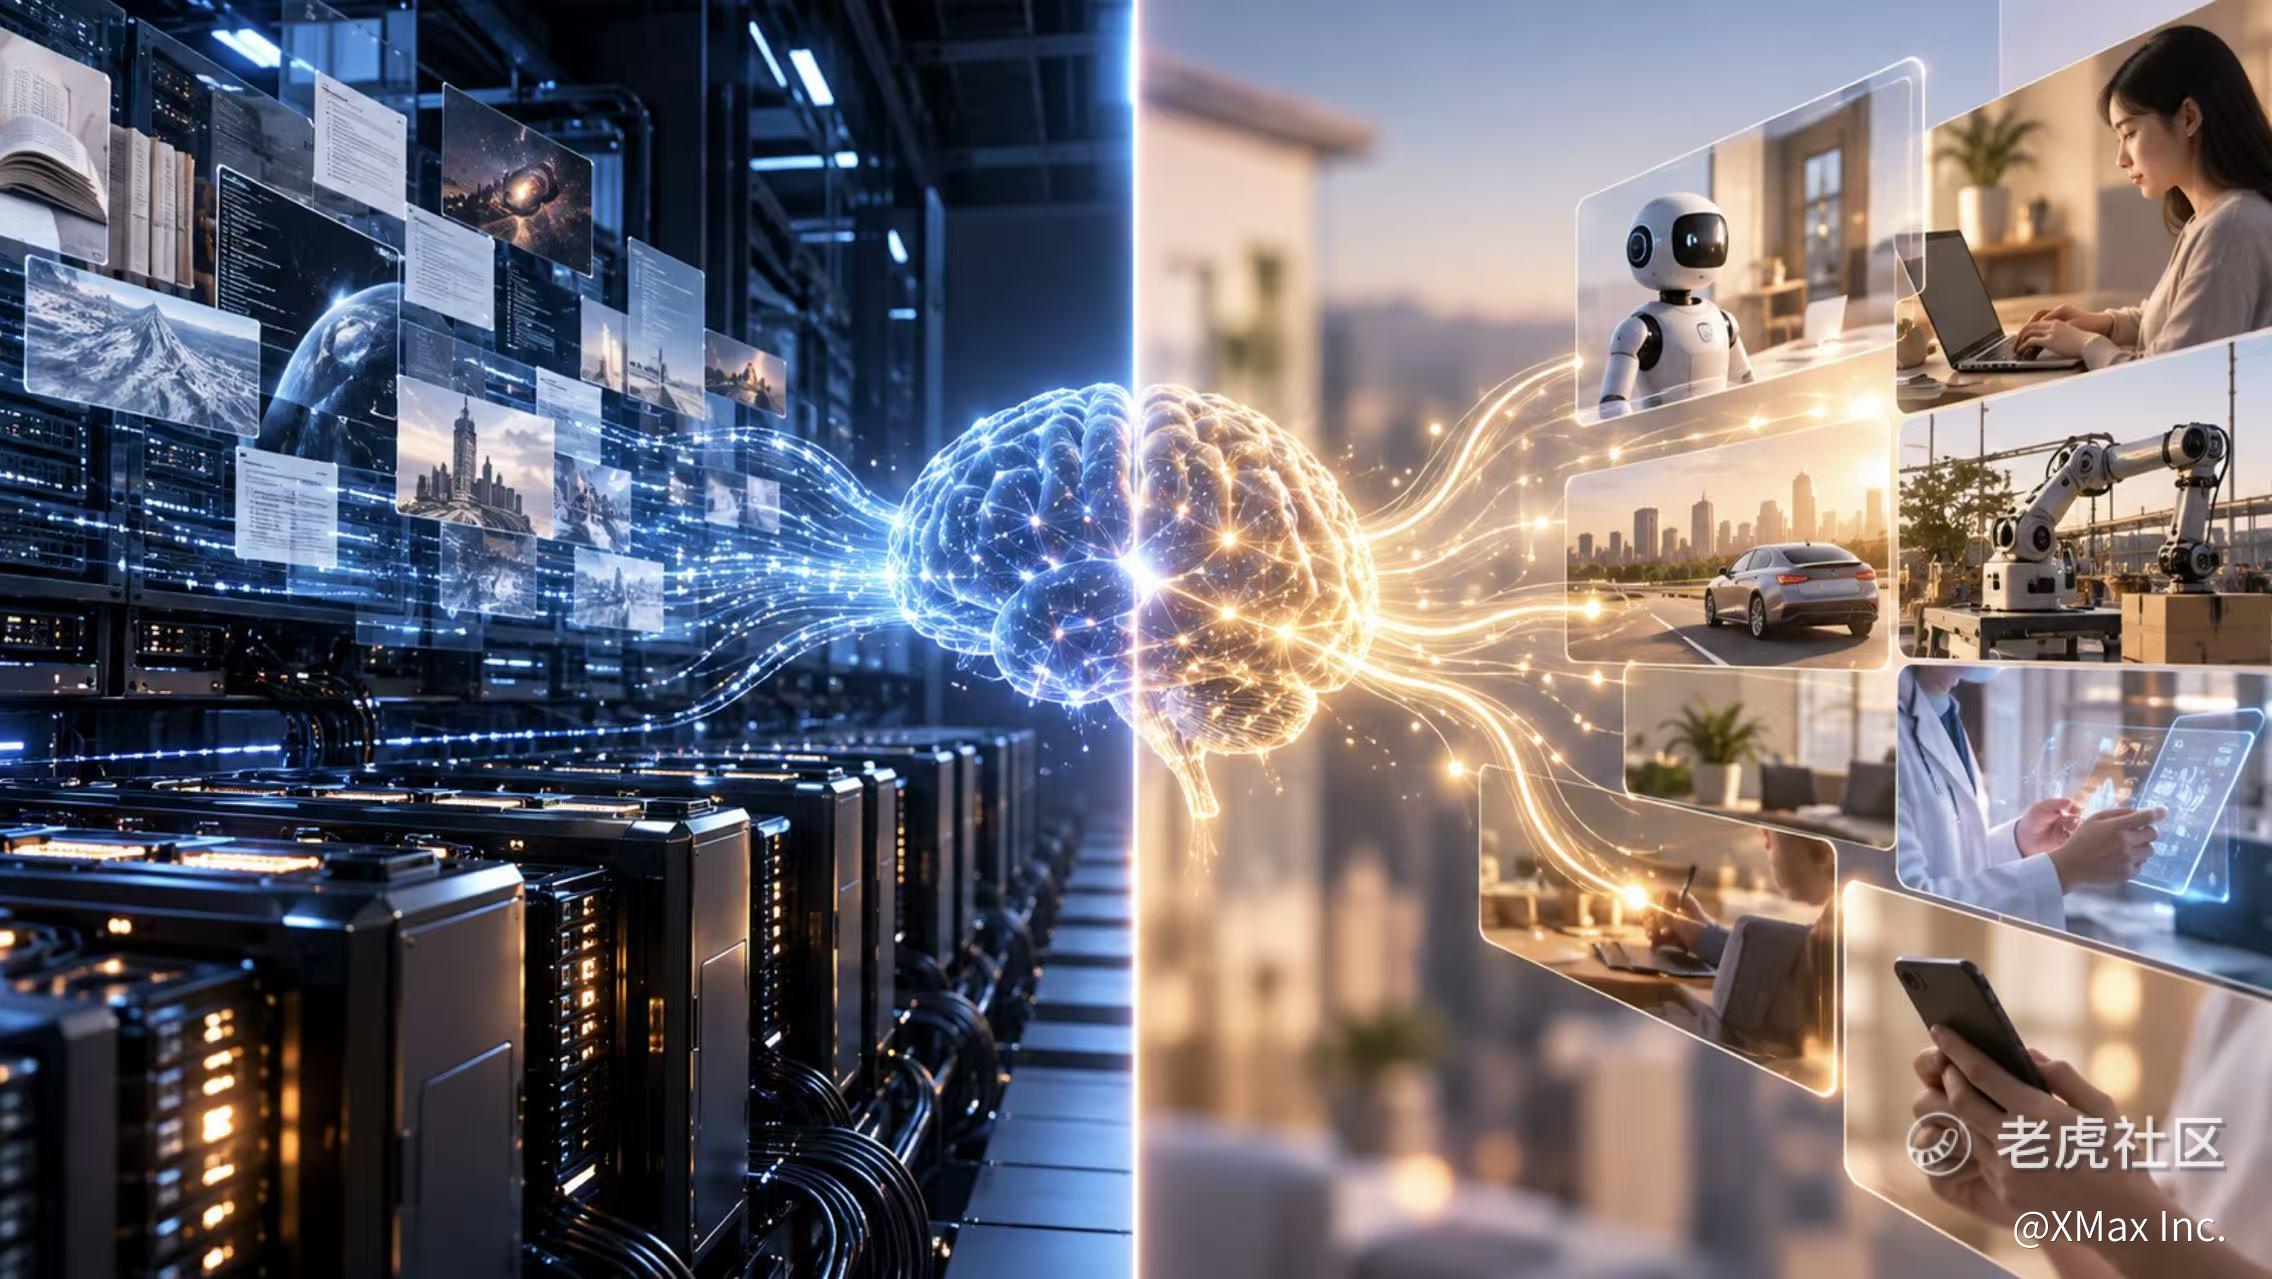
简单来说,训练是让AI学会能力,推理是让已经训练好的AI使用这些能力。 比如训练一个语言模型,需要向模型输入大量文字、代码等数据。模型不断进行计算,发现自己的预测与正确结果之间存在差距,再调整内部参数。这个过程反复进行,模型逐渐学会语言、知识、逻辑和代码能力。由于现在的大模型拥有庞大的参数规模,训练过程中需要进行海量矩阵运算,因此往往需要大量GPU组成计算集群协同工作。
训练完成以后,模型才真正进入用户手中。当你向ChatGPT、Grok等AI产品输入一个问题,让它总结文章、生成图片或者编写代码时,模型根据已经训练好的参数计算答案,这个过程就是“推理”。因此,我们日常使用AI时,真正持续发生的计算,大部分属于推理。
两者最大的区别之一,在于算力成本发生的方式。训练通常是一项高度集中的大型计算任务。开发一个新模型时,大量GPU可能连续运行数周甚至更长时间,但模型训练结束以后,这一轮大规模计算也会阶段性结束。推理则与用户使用量直接相关。只要有人继续调用模型,计算就会继续发生。
假设一个AI应用拥有1亿用户,每人每天产生10次模型请求,就意味着每天可能出现10亿次调用。未来如果AI继续进入搜索、办公软件、编程、客服、汽车、机器人和企业系统,这种计算需求还可能进一步扩大。因此,训练可以理解为AI产业的“建设成本”,推理则越来越接近一种持续发生的“运营成本”。
Agent的发展可能让这种变化更加明显。过去的聊天机器人通常是用户问一个问题,模型回答一次。Agent需要完成的任务更加复杂。例如用户要求AI“分析一家公司的财务数据,并与五家竞争对手比较后生成报告”,后台可能需要搜索资料、读取文件、调用工具、分析数据、生成内容并检查结果。用户只发出了一条指令,背后却可能触发多轮模型调用。也就是说,未来AI用户数量即使没有成倍增加,单个用户产生的计算量仍然可能继续增长。
这也解释了为什么AI产业开始越来越关注“推理成本”。训练阶段更关注模型能否训练出来、GPU之间能否高速通信,以及整个计算集群能否稳定运行;到了推理阶段,速度、吞吐量、能耗和单位成本的重要性明显提高。一个AI产品能力再强,如果每回答一个问题都需要消耗过高的计算资源,大规模商业化依然会面临压力。
从产业链角度看,这种变化值得关注。过去几年,AI基础设施建设很大程度上由大模型训练推动,大量资金进入GPU、服务器、高速网络、数据中心和电力基础设施。随着模型逐渐进入实际应用,算力需求的来源正在变得更加广泛。搜索一次、生成一段视频、运行一个Agent、让机器人执行任务,都可能产生新的推理需求。
所以,理解AI训练和AI推理,可以用一句话概括:训练决定AI能学会什么,推理决定AI能够工作多少次。
过去市场最关心的问题之一,是“训练下一代大模型需要多少GPU”。随着AI逐渐进入真实生产环境,另一个问题的重要性正在快速上升:全球每天运行这些AI应用,到底需要多少算力?
当AI从需要集中训练的模型,逐渐变成每天被数亿人和大量企业持续调用的生产工具,AI基础设施的需求逻辑也会随之发生变化。对于整个产业而言,模型训练完成,并不意味着算力需求的结束,它更像是另一种长期计算需求的开始。
精彩评论