一家公司说自己在做“AI基础设施”,它的收入可能来自完全不同的地方:有人把GPU服务器租给客户,有人负责搭建和管理算力集群,也有人把模型封装成API,按使用量收费。把这些业务统称为“卖算力”很方便,却很难看清钱究竟从哪里来。
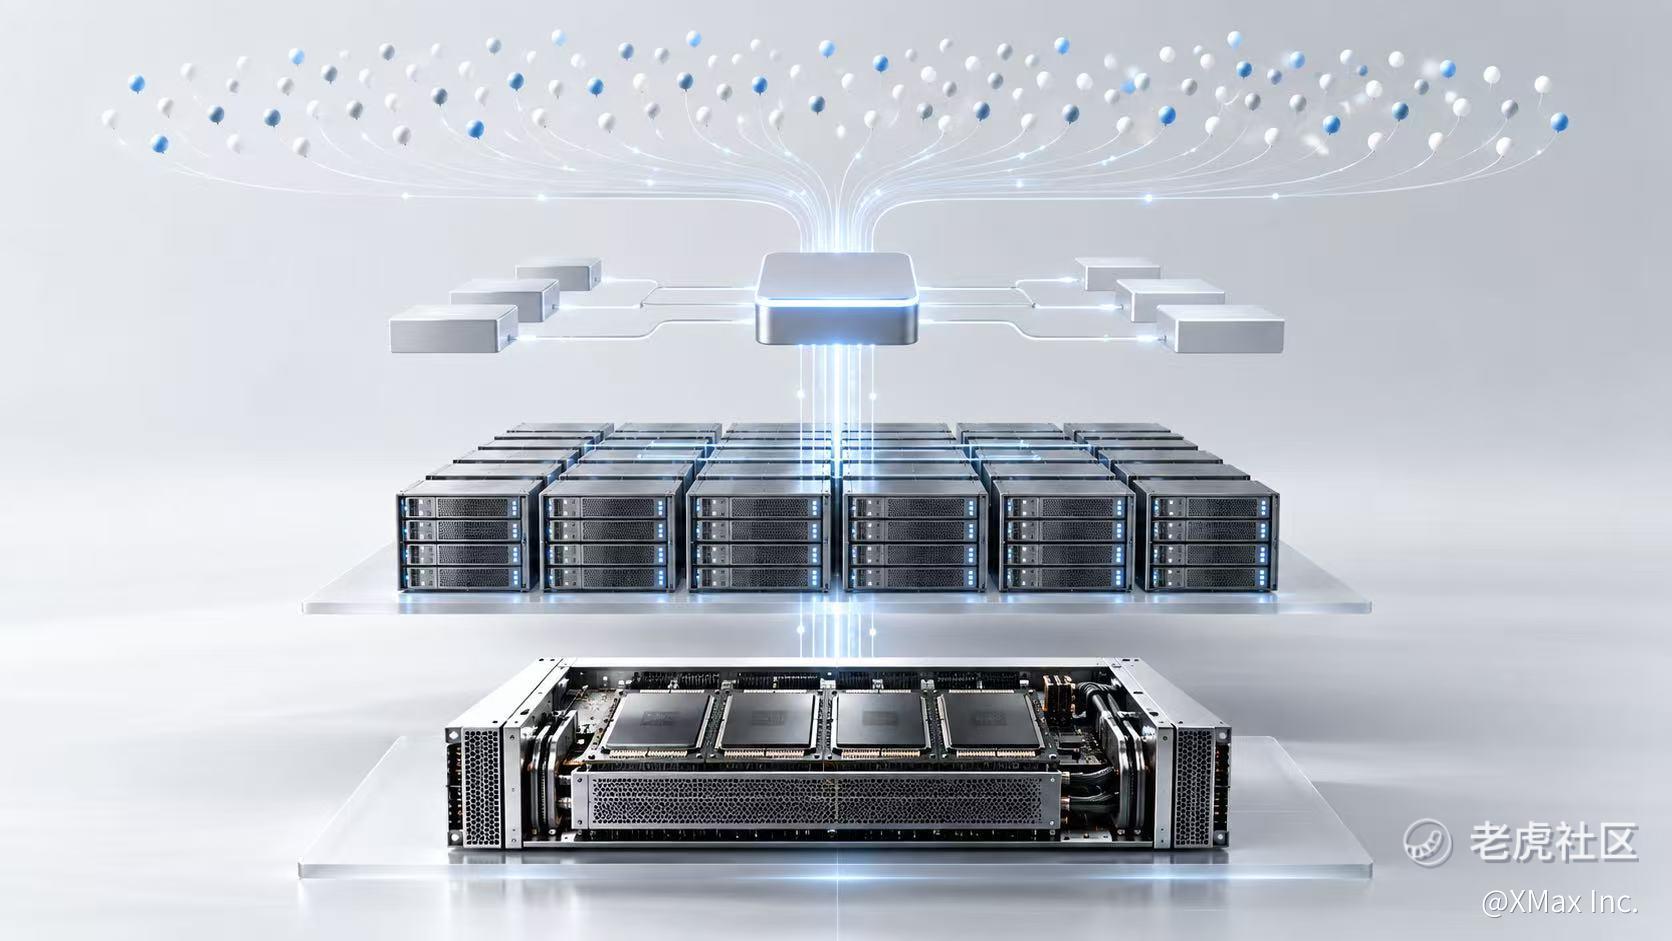
第一层是GPU云:客户租用计算设备。企业要训练模型,或者自行部署模型,可以向云服务商租用配备GPU的服务器。云服务商负责购买设备、建设机房并提供网络;客户按使用时间或预留资源付费。亚马逊云科技的按需实例就是一种按运行时间计费的方式。对这类业务来说,GPU价格只是成本的一部分,设备使用率、电力、机房、网络和运维同样影响最终收益。服务器闲置时,设备仍在折旧,收入却不会随之产生。
第二层是算力服务:客户购买可运行的计算能力。有些客户拿到GPU后,还需要自行安装环境、调度多台服务器、处理故障和监控任务。算力服务商把这些工作一起提供,让客户能够提交训练或推理任务,并按资源用量、服务时长或合同约定付费。客户购买的已经不只是一台机器的使用时间,还包括把机器稳定组织起来的能力。
这两层经常出现在同一家公司。区别在于:GPU云更接近资源出租;算力服务还承担部署、调度和管理工作。业务介绍里都可能出现“GPU数量”,但判断收入质量,还要看这些设备实际运行了多久、客户是否持续使用,以及服务商为交付付出了多少成本。
第三层是API:客户按调用模型的用量付费。假设一家电商公司想在客服系统中加入AI回答功能,它可以调用服务商提供的API,无须自己管理模型服务器。文本模型常见的计费单位是Token,可以简单理解为模型处理文字时使用的计量单位。用户输入的问题会消耗输入Token,模型生成答案会消耗输出Token,两部分可以分别计费。不同模型、图片或语音功能,也可能采用不同的计费规则。Google Cloud公开的生成式AI定价页面就列出了按输入、输出用量收费的方式。
第四层是推理服务:客户为模型持续运行付费。推理,就是已经训练好的模型处理新请求、生成结果。API通常是客户使用推理服务的入口,因此“API收入”和“推理服务收入”不能简单相加,当作两笔完全独立的生意。有的客户按实际调用量付费;请求量较大、对响应速度有要求的客户,也可以购买预留的处理能力。亚马逊Bedrock提供按需使用和预置吞吐量等方式,体现了推理服务在计费上的不同选择。
为什么企业愿意为推理持续付款?因为模型上线后,每次客服回答、文件总结和代码生成都会产生新的请求。使用人数、调用频率、输入材料长度和生成内容长度,都会影响资源消耗。服务商需要让这些请求稳定、及时地得到响应,同时控制每次响应的成本。
看AI基础设施公司的业务,可以顺着三个问题往下读:客户买的是设备时间、托管能力,还是模型调用?收入按时间、资源量,还是使用量计算?提供服务的成本由谁承担?这几个问题比单看“拥有多少GPU”更接近实际生意。
从服务器到API,AI基础设施的交付方式越来越贴近客户最终使用的功能。同一台GPU可以支撑不同服务,但每一层的收费方式、成本结构和客户需求都有差别。看清这条链路,才能读懂一家公司的收入究竟来自哪里。
精彩评论