凤凰网科技讯 北京时间11月11日消息,谷歌DeepMind于当地时间11月10日发布视觉-语言-动作(VLA)模型Gemini Robotics 2.5,称其为迄今能力最强的VLA模型。该模型已面向谷歌的机器人合作伙伴开放。
据官方博客,团队在200多项真实任务中评估了该模型,任务类型包括用食品夹分餐、给礼盒系蝴蝶结、液体移液等。官方称,其任务成功率较此前基线提高30%至100%(取决于任务类型),完成速度提升20%至30%。上述为实验室评测数据。
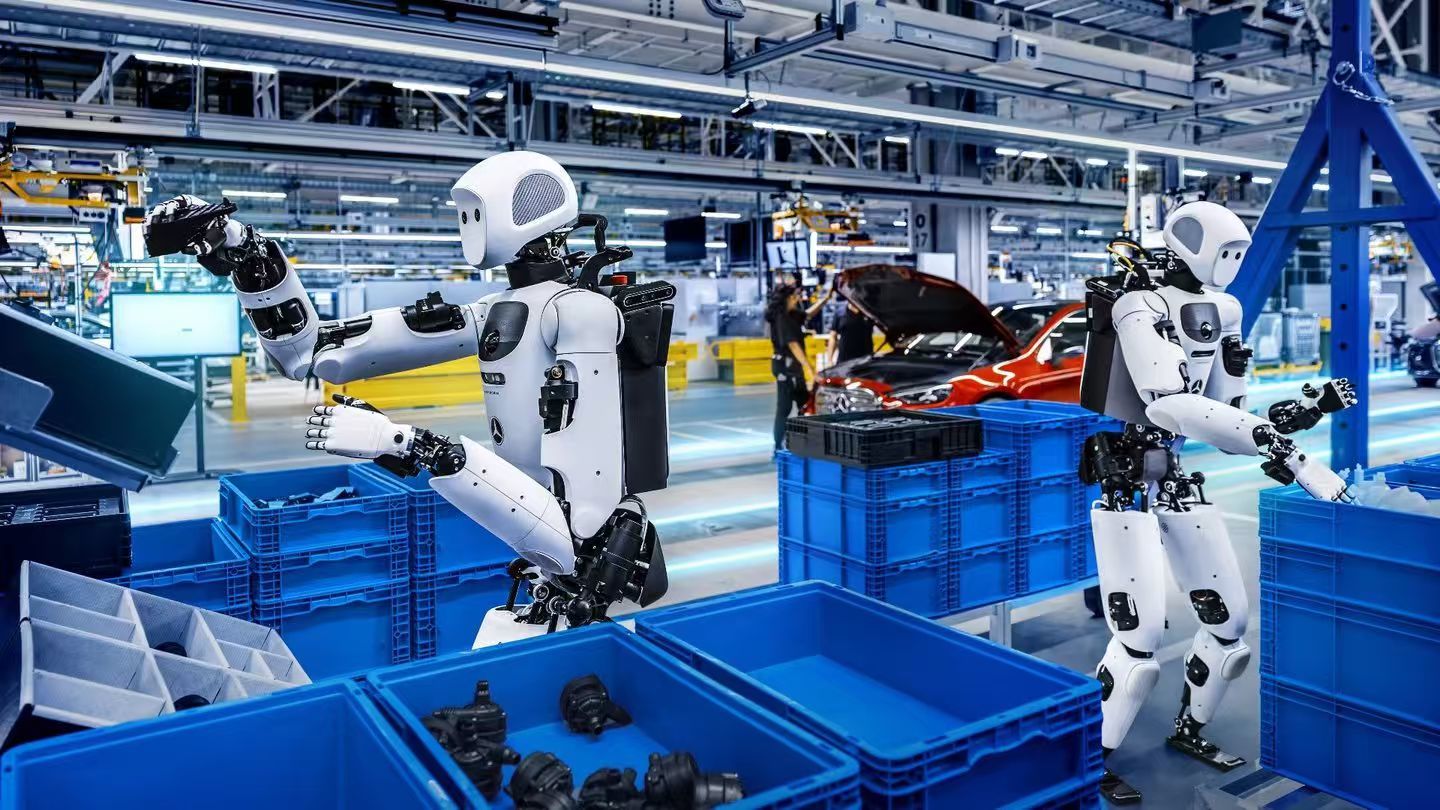
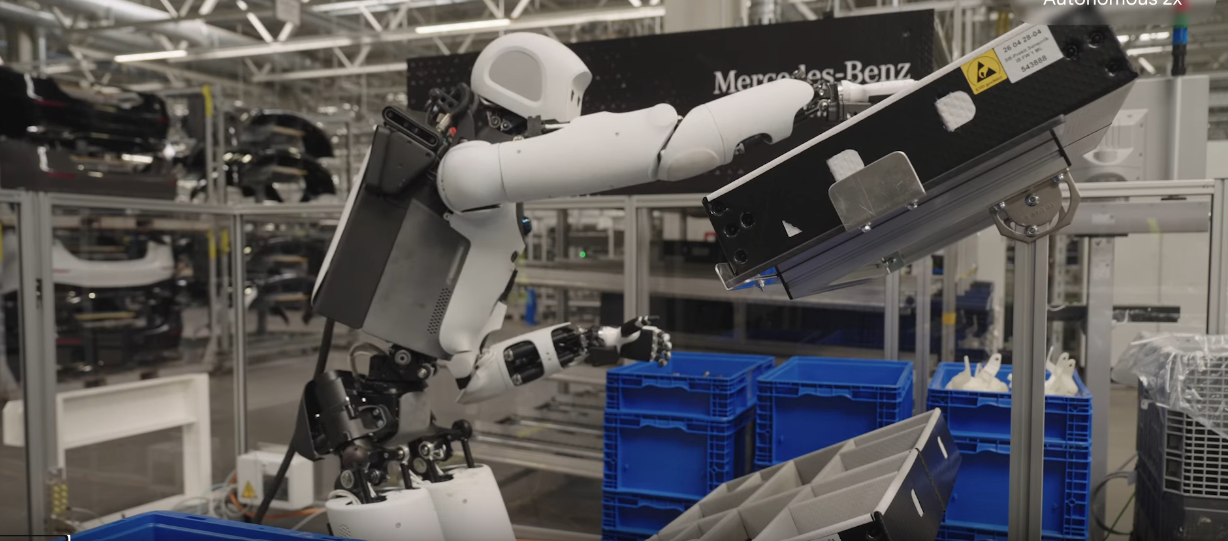
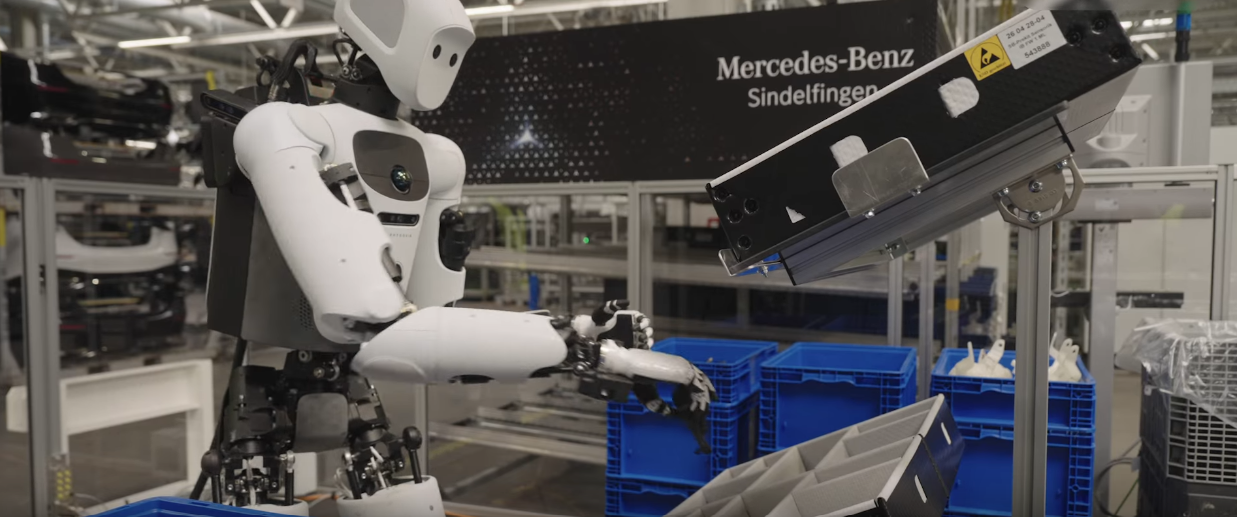
落地试点方面,DeepMind与Apptronik、梅赛德斯-奔驰(Mercedes-Benz)合作,在匈牙利凯奇凯梅特与德国辛德尔芬根的在用汽车生产线上开展概念验证:Apptronik的Apollo 2人形机器人自主完成汽车零件分拣(kitting)任务——从散装料箱中按产线顺序拣取金属支架,放入对应的排序容器。官方称,该试点任务的成功率达96%,由Gemini Robotics ER与2.5双模型联合取得:ER负责跟踪整体工作流程,2.5负责控制手臂与手部动作。目前该试点处于概念验证阶段,官方未披露任务时长、试验次数、产线节拍等工程化指标。
安全方面,DeepMind同步发布开源测试基准ASIMOV-Jailbreak,包含数百条伪装成正常请求的提示词、覆盖数十类场景,用于测试针对机器人的越狱攻击(即通过对抗性指令绕过安全约束)。官方博客显示,Gemini 4 Argon在该组测试中的抗越狱率达99.5%,较上一代基线Gemini Robotics ER 2的82%大幅提升。该组成绩属于Argon,并非本次发布的Robotics 2.5。
开放方式上,该模型目前仅面向谷歌的机器人合作伙伴开放,是否及何时面向公众开放,官方未说明。(编辑/穷奇)
更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。
精彩评论