雷递网 乐天 11月2日
XHEART新芯航途日前在苏州公开亮相。发布会当天,XHEART正式发布大模型芯片X7 Ultra,并现场宣布X7系列已量产8个月,累计出货超过20万颗,搭载10款量产车型,获得超过40款车型订单。
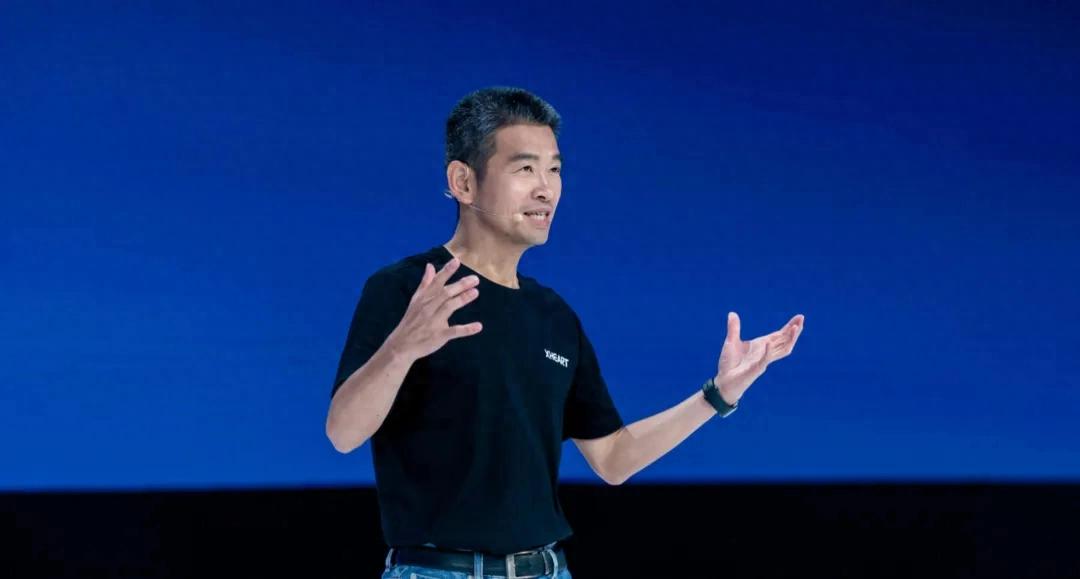
XHEART新芯航途CEO李宗霖也公开亮相。李宗霖在创办XHEART新芯航途前,曾任联发科无线通信事业部总经理,还曾担任OPPO旗下芯片设计公司哲库首席运营官(COO)。2023年,OPPO解散了哲库,随后李宗霖带领核心团队创办了XHEART新芯航途。
李宗霖说,2023年刚创业的时候,坦率说比较辛苦,因为那时候资本市场不景气,在资源很有限的情况下,团队只能做一次选择,只有一次机会。
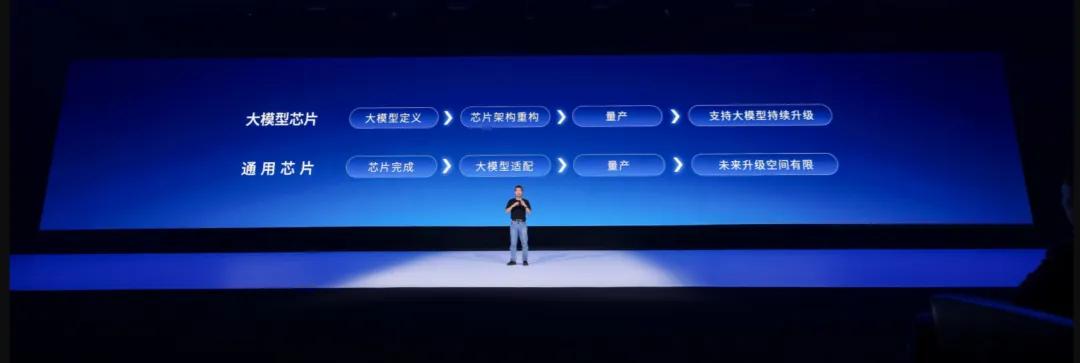
对团队当时来说,有两个大方向选择,一个是做非常安全、不容易犯错的选择,就是跟所有人一样,做一个比较通用性的架构芯片,这是一个安全的方向。也就是说,不管模型怎么变,芯片都能跑,但它不可能有太好的性能。另一条路线有风险,有不确定性,但坚信这个路线是能够给用户提供巨大价值的。
当时李宗霖跟Momenta CEO曹旭东做了非常大量的讨论,彼此的看法是,相信智驾行业会从传统的规则判断,非常剧烈地转成数据为驱动的算法。在往数据驱动方向上,模型会变成一个快速转动的飞轮,而这个飞轮是有大量海量的数据在驱动。数据的飞轮越转越快,会让模型的迭代速度越来越快,进步越来越快,用户体验会越来越强。
“我们当时觉得要做这种芯片,有风险,有不确定性,但这才是一个对的方向,对的方向能提供客户、用户真正的价值。我们非常欣慰,三年走来,确实也验证了当时对数据驱动,大模型趋势方向的判断。”
李宗霖说,XHEART的大模型芯片“X7 Ultra”,大模型算力,700 TOPS。是用真实量产智驾模型来评测芯片,同时基于量化后模型精度达到99.99%以上,这个严苛条件所得到的性能。
模型还在进化,应?还在深?。芯?也必须提前做好准备:既要有更强的计算能?,也要让数据跟得上计算,让整个系统?效协同。所以,今天还有?个X more thing。
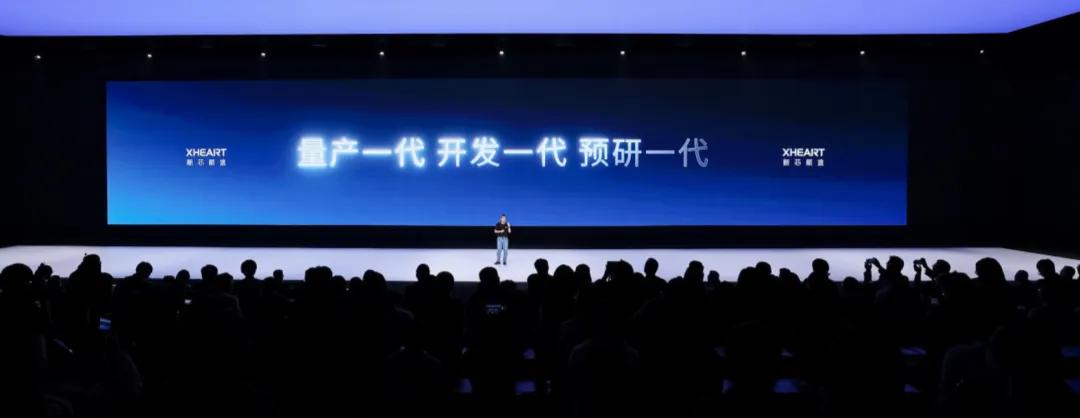
XHEART四团队研发节奏始终是:量产?代、开发?代、预研?代。
“今天发布的X7 Ultra,带来了这?阶段软硬协同的最新成果。??向下?代更?规模的模型,XHEART也已经在推进?颗全新的芯片,就是XHEART?模型芯?X9。”李宗霖指出,X9核?研发目标是大模型算?3000 TOPS,同时单芯片内存带宽达到创纪录的700GB/s。
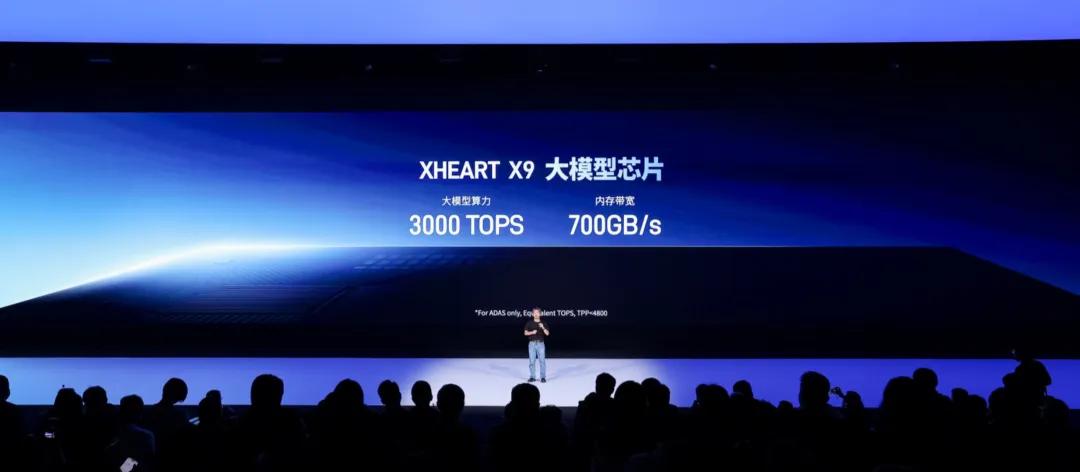
“我们认为,计算和访存带宽需要同步?幅提升,才能更好的适配未来更?规模的模型。所以X9会围绕下?代世界模型的需求,继续推进软硬件协同设计,让更?的模型能够?效运?,让更强的算?能够充分发挥。”李宗霖透露,公司计划在2027年推出X9,目标是成为全球领先的大模型芯片。
以下是新芯航途CEO李宗霖演讲主要内容:
李宗霖:大模型时代,我们究竟需要?颗什么样的芯片?这个问题,关系到模型的进步,能不能真正的变成产品的进步;也关系到更强的智能,什么时候能够进?更多人的?常?活。
今天,我想从更早?点开始讲起。因为在2023年决定重新创业的时候,我们就反复一直在问自己这些问题。那?年,我们几位同事经历了?次职业上的重新选择。大家在芯片这个?业已经做了十几、二十年,也?起做过相当复杂的芯片产品。重新开始,反?让我们更加谨慎。
这?次,到底要做什么?能解决客户什么问题?几年以后,芯片做出来,是不是市场所需要的?我们希望把过去积累的经验,做成真正被需要的产品。也就是在那段时间,非常好的缘份,我们认识了旭东,跟旭东聊了很多,聊技术,聊市场,也聊未来几年智能驾驶会发?什么的变化。
经过多次的交流,我们逐渐形成了两个判断。第?个判断,我们相信大模型会改变智能驾驶,也会改变芯片的设计方式。
过去的智驾系统,基本是由多个"小模型"拼出来的——感知是?个模型,预测是?个模型,规划又是另外?个模型。每个模型各司其职,看起来分?很明确,但是问题也恰恰出现在这?。首先,信息在模型传递过程中维度降低了,导致大量的有效信息丢失了,数据利用率也被拉低了。
第?,性能天花板比较低,泛化能力比较差。小模型能力的上限,本质上就是规则设计者的认知上限。所以小模型时代的智驾,本质上是?个"人脑驱动"的系统——?程师写顶层规则,机器通过小模型来执?这些规则。
随着基于transfomer端到端大模型的发展,海量数据被真正的高效利用起来,我们真正地?向数据驱动。模型正在改变汽车理解世界、作出决策的方式,也给芯片提出了三道新的挑战和题?。
?先,芯片算力能不能在真实的系统中发挥出来?用户最终需要的,不在于这些纸?上的数据,?在于量产大模型部署环境下,计算推理要快,系统判断要及时。
第?,今天设计的芯片能不能跟上明天的模型?如果在芯片设计的时候,缺少对模型架构发展趋势的预判并且预留足够的资源,那么随着产品落地,后续的OTA升级很快就会遇到限制。
第三,我们能不能以合理的能耗获得所需要的能力?提高算力,?个很直接的办法是堆砌晶体管,投?更多的计算资源。但是在车上,散热条件永远都有一个非常明确的边界。算力上去了,如果能耗也大幅度增加,这个方案就很难走向真正的大规模应用。这三道题是要放在?起回答的。
我们的判断是,需要从真实的大模型需求出发,重新思考计算、存储和数据流动怎么组织,才能让芯片的资源真正用在模型需要的地方。这就是我们认定的技术方向:大模型,定义芯片。我们坚信,这是值得投?的技术方向,能够让大模型的进步真正?进产品、服务用户。既然认定了,就应该从现在开始,把它做出来。这也是我们在2023年决定创业的原因之?。
第?个判断,大模型将推动新?轮科技变?,?汽车,是我们让这场变?率先惠及更多用户的起点。
一项好技术的价值,在于它最终能?进多少人的?活。我们希望让更多品牌、更多级别的车型都能搭载更好的智能驾驶,让更多人享受到科技进步带来的安全与便利。要做到这?点,芯片就必须要同时做好性能、能效和成本。让更强的模型能够高效运?,也让车企能够把这样的能力带进更多量产车型。我们希望用更好的大模型芯片,降低先进技术?向规模应用的?槛,让更多用户用得上、用得起好的智能驾驶。
当技术服务的人越来越多,真实场景和用户需求也会推动产品持续进步,规模化应用则能够?撑下?轮研发。从第?颗芯片开始,我们就希望?通这条路:把技术做好,把产品做出来,让更好的体验?向更?泛的人群。
基于这些判断,我们确定了全新的芯片设计思路:大模型定义芯片。当时,常?的路径是先做芯片,再让模型去适配。我们决定从真实应用中的模型需求出发,倒推芯片的架构。这条路走来事实上是不轻松的。当时正处于资本寒冬,团队规模比较小,做芯片又需要?期的投?,每?次取舍都事关?死。但是我们的?标是非常明确的:做出为大模型设计的芯片,并且实现规模化量产。
我们决定从汽车做起。在这个对性能、成本和安全都有严格要求的场景?,检验??的判断。今天,我们沿着“大模型定义芯片”的技术路线,打造出了?向量产的大模型芯片。
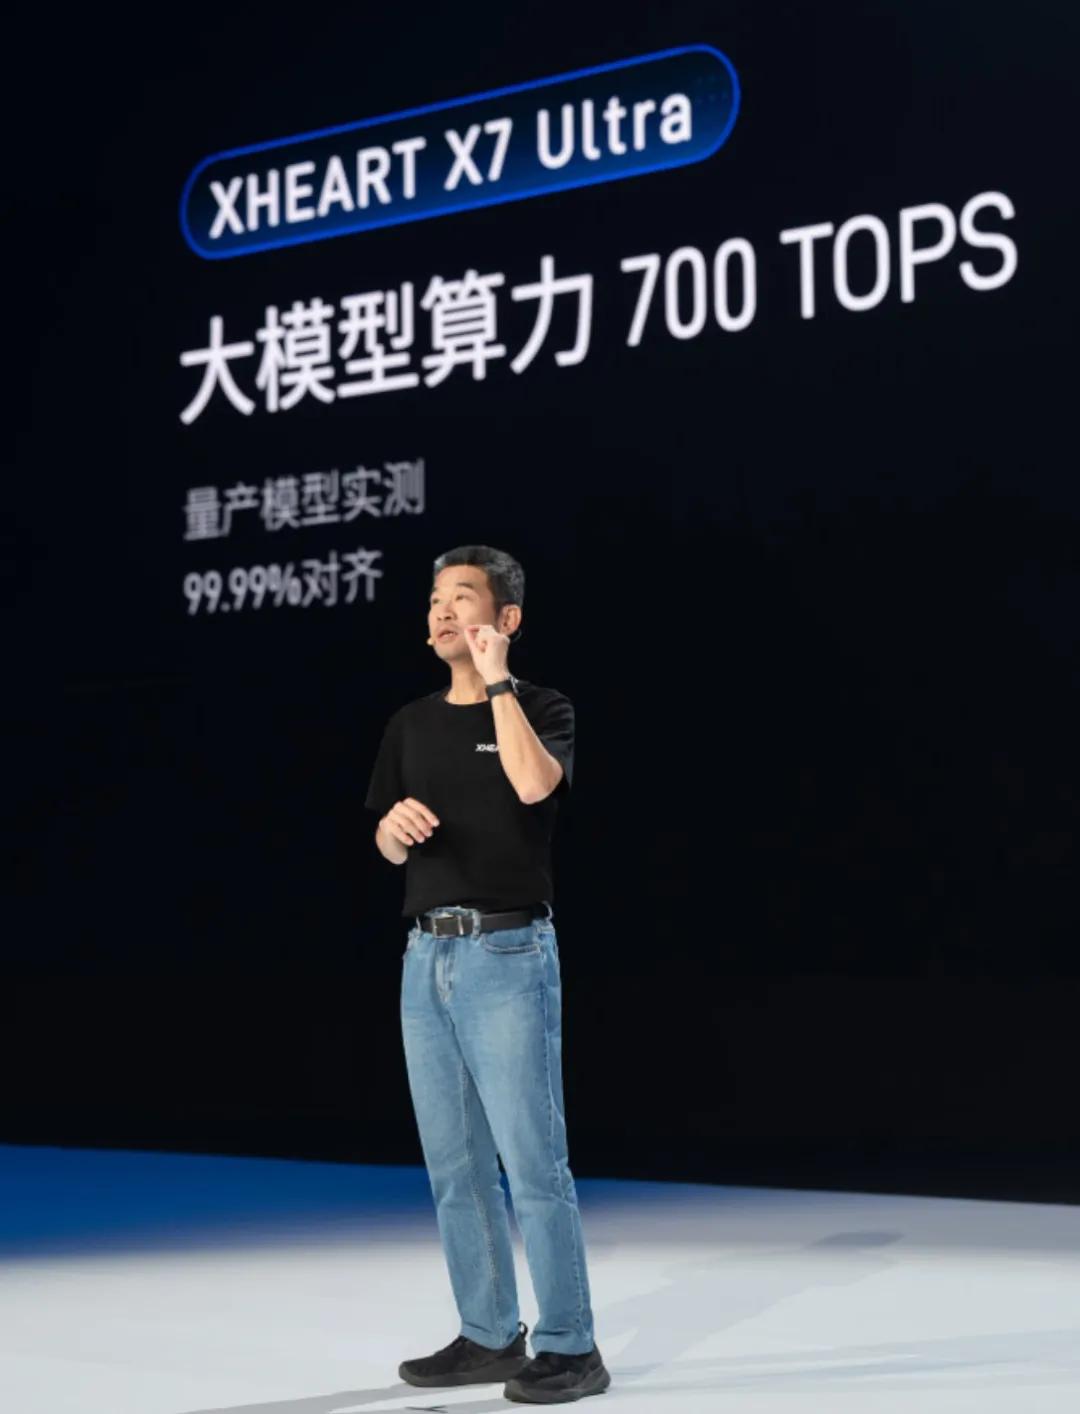
XHEART的大模型芯片“X7 Ultra”,大模型算力,700 TOPS。特别强调的是,我们是用真实量产智驾模型来评测芯片,同时基于量化后模型精度达到99.99%以上,这个严苛条件所得到的性能。
如何理解这个算力背后的价值呢?通常?业会通过实验室?的基准测试来评估芯片性能,比如说FPS或者模型运?耗时,但是实验室的结果与智驾量产模型的性能和体验往往相去甚远。所以我们直接用实际的量产智驾大模型来评测芯片,让性能评测从?开始就对准最终的智驾体验。这样做也意味着性能优化必须在更严格的约束下完成。包括模型结构不能随意调整,计算精度必须得到保证,最终的驾驶体验也不能有任何的折扣。
我们的要求是:量化部署以后,模型输出与训练后的FP32浮点模型相比,相似度要达到99.99%以上,也就是四个九以上。在这样的精度约束下,我们要确保芯片的性能能够充分释放出来。700 TOPS背后是?项项具体的设计与优化。接下来,我会为大家逐?介绍“X7 Ultra”组特的架构设计。
第一项,超大核NPU架构。研发开始的时候,我和SoC设计负责人讨论最多的一件事是:怎么样把我们对大模型的判断真正做进芯片的架构?模型正在?向集中,芯片架构就要为这种集中做好准备。因此,我们把优化重点放在NPU上面,并且选择了超大核架构。
超大核架构带来了什么?打个比方,过去协作的人分散在不同办公室,资料需要来回传递。而超大核就像把紧密协作的团队放进同?个宽敞的?作空间,让大量的交流在内部高效完成。模型数据交互,从传统小核之间的百GB/s级,聚合到超大核内部的TB/s级,互联速率实现了数量级的提升。
同时,我们设计了大容量、高并发的多级缓存,让计算需要的数据尽量留在身边,减少等待和搬运,让计算少等待,让数据少绕路,这就是超大核NPU?先要解决的问题。
第?项,为关键计算配备专用加速引擎。计算集中以后,还有一个问题要解决,那就是模型?的关键算?,能不能都在NPU内高效执?呢?
大家都知道,算?会直接影响整个模型的运?效率。早期的NPU主要?向卷积?络设计。当模型发展到了transformer架构的时候,?些原本不?持的计算就需要交回CPU去处理。这不仅带来了处理器之间的任务切换,也增加了对外部内存的读写,影响了整个模型的执?效率。
为了解决这个问题,业界开始在NPU内部加?了向量处理器,让更多类型的计算可以直接在NPU内直接完成。同时,利用芯片内部的高速片上SRAM,提高数据的访问效率。但我们发现,仅仅把计算放回NPU内部,带来的性能提升仍然非常有限。有没有比向量处理器更快的计算方式呢?有没有比片上SRAM更高效的访问路径呢?
我们继续深?研究,并且针对模型中使用频繁、对整体耗时影响较大的一系列计算环节,进?更加极致的优化。比如针对transformer模型中经常使用到的LayerNorm、Softmax和Transpose等?系列关键算?,我们专?设计了硬件加速器,并且搭配访问效率最高的缓冲寄存器,实现计算和数据访问双双极致优化。
在这?,我想讲?段当时芯片定义的经历。2023年我们就和算法模型团队?起,围绕持续演进的主线模型,深?讨论模型架构和算?需求:我们既要分析当时的模型是怎样运?的,还要充分结合算法团队的研发方向,判断未来几年哪些计算会变得越来越重要。最终找到最值得深度优化的哪些环节。模型告诉我们,计算时间花在哪?;软硬协同让我们进?步判断,硬件应该为未来做什么样的准备?
同时,对于智驾这样的高安全应用来说,模型推理速度是?方?,模型的推理精度同样重要。为了保障模型精度不丢失,我们精?设计的这些加速器要求原??持浮点高精度向量计算。我们的?标很明确,那就是让关键计算又快又准。
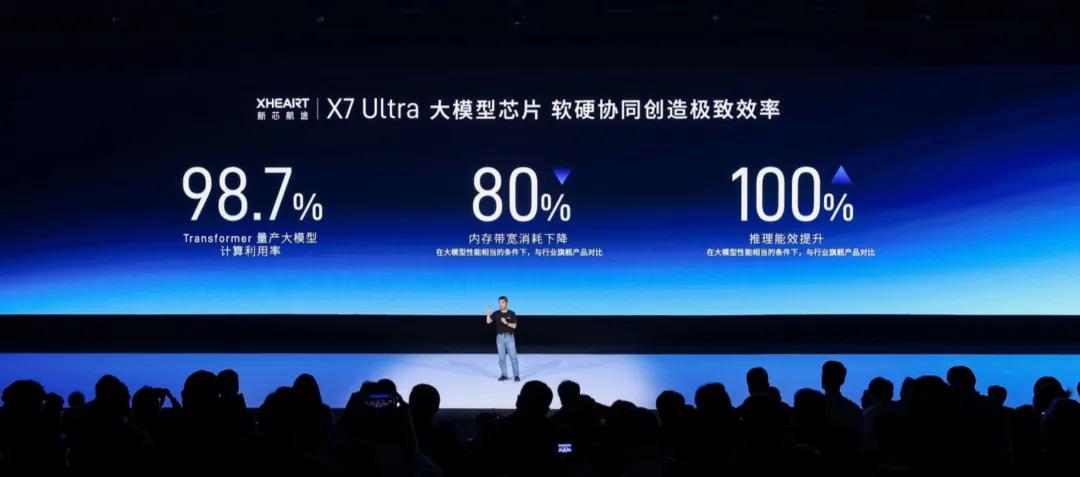
第三项,解锁硬件并?度并重构AI?具链。大模型下的计算利用率是?个非常有挑战的?标。基于量产智驾模型实测,X7 Ultra的计算利用率可以达到98.7%。这?有?个具体的技术取舍:计算的任务怎样安排才能充分发挥硬件的并?能力,又不让数据搬运成为新的瓶颈?
简单说,就是让芯片?的计算单元更充分的协同?作,减少等待,把硬件的能力真正释放出来。?方?,让更多计算单元同时?作;另?方?,让计算与权重加载同时进?。当前这批计算还在执?,下?批需要的数据就已经提前准备好了。打个比方,?条?产线上,设备已经具备很强的加?能力,我们还要把?序和供料安排好:不同的?位协同运转,原料提前送到,设备才能持续高效的?作。
为此,我们的软件团队和算法模型团队?起深?到底层,找到影响效率的根本原因,把原来需要排队等待的环节,尽可能变成并??作。
与此同时,我们也针对X7 Ultra的AI?具链进?了深度重构,让模型在芯片上运?的更高效。其中?个关键的能力就是整?级融合。常规的模型推理是把?个算?作为kernel单独来执?,每完成?步,往往都需要把中间的结果写回外部内存;下?步要开始的时候再把数据读回来。数据这样来回搬运,既占用内存带宽,也消耗时间和电力。
业界常?的优化方法是把几个连续的计算步骤合并起来,让中间结果尽可能留在芯片内部的高速缓存?面,减少对外部内存的读写。而X7 Ultra把这种优化进?步扩展到了整张?络。通过融?新的搜索算法和优化策略,我们的AI?具链可以从全局出发,对整张?络中不同分层、不同分?的计算任务,统?拆分、编排和合并,最终融合为?个整?级的大算?。
也就是说,优化的范围,从局部的几个计算步骤扩大到了整个模型的计算流程。这样做的最大价值就是实现了整?的内存零拷?:中间计算的结果不再需要反复的写回外部内存、再读取回来。外部内存的数据传输主要集中在最开始的输?、最后的输出,以及必要的模型权重加载。数据搬运减少了,内存带宽开销也就大幅下降,NPU也能够把更多时间用在真正的计算上面。
基于全新的NPU架构以及深度重构的AI?具链,X7 Ultra具有业界领先的极致效率,包括:1.基于量产智驾大模型实测,X7 Ultra NPU计算利用率可以达到98.7%。2.与?业旗舰产品相比,我们的内存带宽消耗下降了80%,同时能效提升了100%。这就是我们强调的“大模型定义芯片”所带来的巨大优势。
第四项,中国?发量产Armv9车规级CPU,大家知道,CPU是整颗芯片中的“超级调度官”。我们希望它精?,同时有?够强的能力把复杂控制和系统协同做好。X7系列上采用Armv9车规级CPU,我们是中国率先采用并?发量产的。今年3?已经随客户车型进?量产。
相比上?代CPU内核,Armv9性能提升20%,能效提升10%;全新SVE2向量处理引擎相比上?代NEON具备更强的DSP性能,大集群架构进?步提升了多核协同和L3缓存访问性能。这是我们与Arm共同完成中国?发的价值:以更高效的CPU?持整颗芯片的协同。
第五项,深度异构计算。有了CPU,也不能把所有事情都交给这个调度官处理。合适的任务应该由最合适的计算单元来做,这就是深度异构计算的设计初衷。
我讲?个当时参与讨论的具体例?,大家就比较容易理解了。各位都知道,激光雷达是智驾系统最重要的传感器之?。过去两年,车载激光雷达经历了?个跨越式的演进,从128 线、192 线,?路演进到 500 线级,甚?1000线级的图像级激光雷达。线束越高意味着在同样距离上看得越清楚,判断得越准确。
同样的碎片,以前只有?个点来覆盖,甚?还有可能被漏检,现在会被5-10个点云覆盖,检测置信度大幅提升,但是随之?来的则是海量点云数据在智驾芯片上的处理需求。为此,我们在传感器处理?系统中专?集成了激光雷达处理加速器,通过专用的计算单元和流?线设计,更加高效的?持高达2000万点/秒的处理带宽。这个2000 万点/秒的处理能力,?以?持千线激光雷达的点云处理需求,最终带给用户的是感知安全。
讲完激光雷达,我们再来看看摄像头处理。摄像头是智驾系统里面最核?的传感器,摄像头处理流?线的精细设计直接关系到端到端处理的时延。过去业界普遍关注的是平均时延——从摄像头曝光到特征输出,但是平均时延是会骗人的。真正决定系统安全的往往不是平均时延,?是时延的抖动。什么意思呢?比如说平时处理30毫秒,但是抖动范围在20-50毫秒之间波动,这就意味着差的时候50毫秒才处理完毕,那么在这个时刻,整个系统的安全性是由这50毫秒来保障,这50毫秒就变成了整个系统安全的下限。这就是为什么我们要关注更重要的词“确定性”。
X7 Ultra在传感器处理?系统中引?了专注于本地计算的高性能多核处理器系统,在更近的距离上实现了本地计算和流?线控制,在实测表现上,X7 Ultra的摄像头处理稳定性相比竞品提高了100%,这带给用户的是更安全、更安?。
第六项,软硬兼备的安全能力。我想重点讲一讲X7 Ultra的安全理念:实现真正的智驾安全,X7 Ultra满?ISO26262 ASIL-B功能安全要求,同时内置的MCU则通过了最高ASIL-D认证;信息安全也满?了国密?级要求,?持多项物理攻击的防护?段。
这些能力为硬件提供了底层安全基础,但对于智驾来说,这是远远不够的。就好比?个人身板很硬朗,并不代表办事靠谱。据统计,智驾系统故障中,真正属于硬件故障的比例其实是不高的,大部分都是因为超出了模型算法的边界。
因此我们认为,评价智驾这样?个复杂系统是否安全和值得信赖,还有?个重要层?就是由智驾芯片和算法所?撑的?驶安全。硬件安全好比身体,?驶安全好比大脑。两者构成的智驾安全才是用户最直观可感受的安全保障。因此,除了硬件安全,X7 Ultra在?驶安全上也能提供强大的?撑,拥有?业领先的高效算力,以及为模型持续迭代预留的空间,可以更加全?的保障整个系统的智驾安全。?句话,硬件安全+?驶安全才是真正意义上的智驾安全。先有安全,才有安?。
我觉得这不只是?颗芯片的突破,更是智驾体验的跃升。专为大模型设计的超大核NPU,互联带宽数量级提升,让关键计算和数据交流更高效。同时,高精度专用算?加速引擎,让算?的执?又快又准。
硬件架构与AI?具链双重优化释放了700 TOPS智驾大模型算力,同时能效达到?业旗舰的2倍。中国?发量产Armv9车规级CPU让整颗芯片高效协同。深度异构计算,本地任务,本地处理,传感器预处理稳定性提升100%。软硬兼备的安全能力为这?切系好安全带。
这六项能力都来?同?个起点,那就是先理解大模型,再设计芯片,实现模型参数的10倍释放。从第?个提出“大模型定义芯片”到第?个让大模型芯片实现量产,我们?到了?业的前列。X7 Ultra芯片的成功,不仅需要产品优秀,还要有??高效协作的团队。
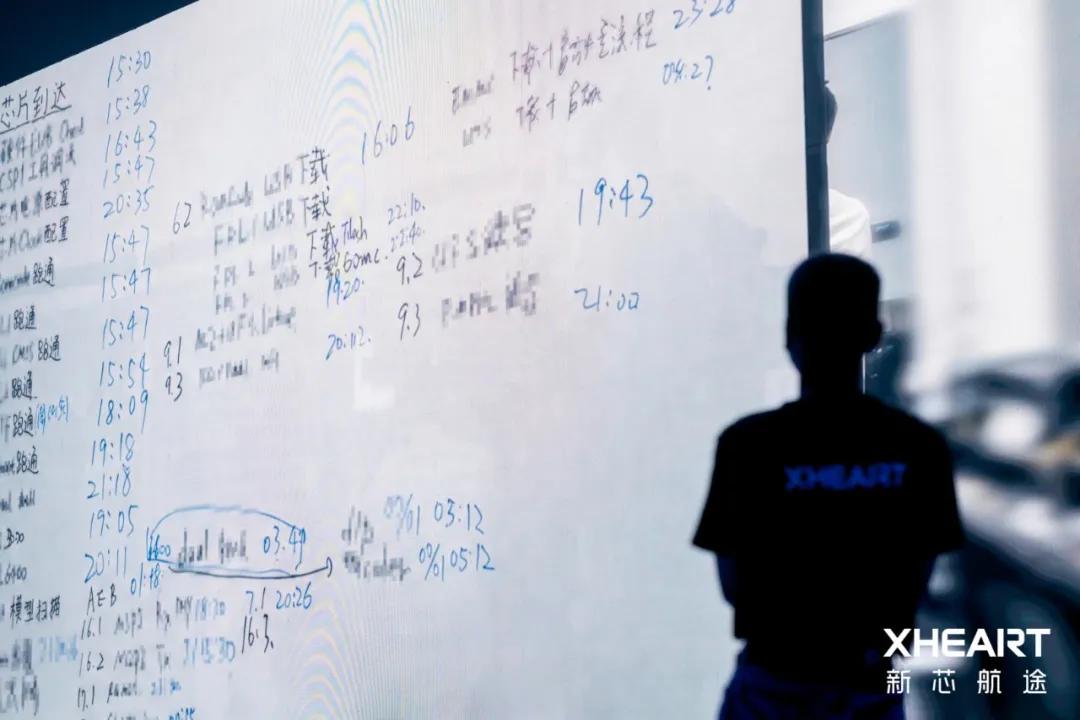
不到24小时,我们就成功点亮芯片,主要数据通路全部打通。快速的成功点亮是?个好的开始,但只是第?步。
接下来,还要经过严苛的系统验证和实车检验。我们要交付的是?颗能在真实车辆上稳定、可靠?作的芯片。
其中,有件事情令我印象深刻:我们的?台测试车,其实短短几天就已经成功上路,但是经过内部充分讨论,我们决定,这一次要用更严格、更接近量产的标准来重新定义“回片上车”这个节点。
我们希望验证的是由芯片、底层软件和智驾模型所组成的完整系统,能不能在真实道路上跑出接近量产的表现。细致到每?个路?的转弯,模型所规划出来的?驶轨迹都要和量产项?标准保持?致。这个严苛的要求,对于?颗刚回来的芯片是?常有挑战的。
经过团队的?夜攻坚,整个系统从芯片,到底软,再到算法,磨合的越来越稳定,直到我们的测试车辆可以在城区道路上连续稳定?驶数小时,全程?接管。?论?天、夜晚,还是那段时间经常出现的暴?天?,我们的系统都经受住了考验。?这距离这颗芯片的出?仅仅过了17天。
第21天,驶?了真实的车流,并且向客户开放体验。随后,我们邀请大量合作伙伴和客户来试乘测试车。他们对系统的表现、落地的速度以及团队的专业给予了高度认可,这份认可让我们感受到?业对大模型芯片的期待,也推动我们加快脚步,把这样的体验带进客户的量产车型。
回顾整个回片和上车的过程:不到24小时点亮;17天实现整车闭环;然后接受合作伙伴和客户的实车检验。每?个节点都让我们对这颗芯片在真实车辆上的能力,多了?份验证,也多了?份信?。在这?要感谢每?位选择我们的客户。感谢他们对“大模型定义芯片”的共同认可,也看到了软硬协同带来的价值,大家志同道合?到了?起;这份信任,也让双方团队在量产攻坚中并肩作战,?起解决问题、力保高质量交付。
有件事让我印象特别深:XHEART团队有?位同事在当时准备去客户现场,出发前被HR问到什么时候回来。他说:“我也不知道什么时候可以回来,所以就先买了一张单程机票。”
那张票没有返程的?期,作为HR的同事,他把归期留给了问题解决的那?天,当时我非常触动的。最终,我们与客户成功打造的多款重磅车型,顺利通过各项严格的测试和评审,成功上市。
从?款车型的成功?向更多客户的规模量产,?颗芯片,从设计、制造到真正搭载上车需要产业链伙伴共同努力。对XHEART来说,把芯片做出来之后,我们还要进?步帮助客户降低开发难度,让项?更快?向量产。为此,我们围绕X7芯片系列提供了丰富的解决方案参考设计。
我们的定位非常明确:我们不做直接向车企供应硬件系统的?级供应商,也就是硬件Tier1。但是对于参考设计,我们会尽可能的按照主机?的量产标准严格要求,比如进?了大量域控级的PreDV测试。我们希望交到客户?中的是经过充分验证、能够?撑量产开发的成熟方案。客户用得更省?,开发落地的效率才会更高。
这?,我特别想和大家分享的是,除了会场外大家看到的L2++(城市NOA)量产车型,X7还成功导?多个L3和L4?动驾驶项?。比如这套参考设计:这是我们基于两颗X7芯片为L3、L4级?动驾驶打造的计算平台。?前,它已经获得多个车型项?定点,预计不久后就会和大家??。
这套L3/L4计算平台采用统?双大脑架构,统?硬件兼容L3和L4;通过冗余的电源域设计、冗余的传感器接?,以及冗余的通信互联设计,再搭配强劲的算力和基于安全操作系统的安全软件栈,满?L3/L4对硬件安全和?驶安全的高标准要求。
从公司成?到芯片流片,再到量产,我们用了两年。在这些关键阶段,我们实现了?业通常需要几倍的时间才能完成的跨越。
今天,我很荣幸跟大家宣布,X7系列芯片已经量产8个?,累计出货超过20万颗,搭载于10款量产车型,获得超过40款车型的订单。这20万颗芯片的背后是客户?次次的选择,也是产业伙伴与我们的并肩协作。
从第?个提出“大模型定义芯片”,到将这条技术路线落地量产,我们?到今天,靠的是对技术方向的判断,也靠?路同?的朋友。
———————————————
雷递由媒体人雷建平创办,若转载请写明来源。
精彩评论