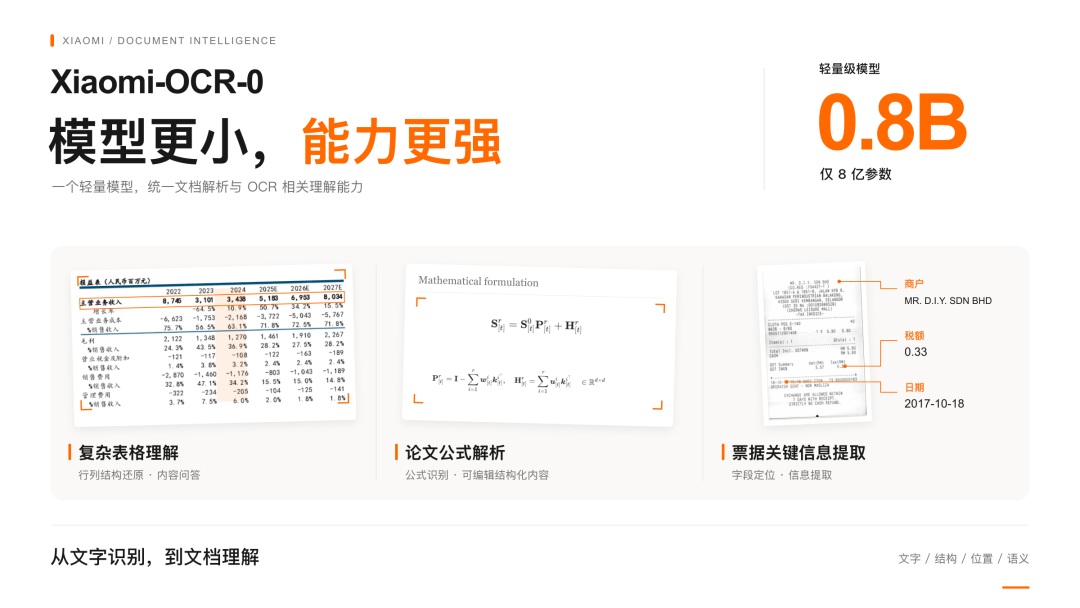
凤凰网科技讯(作者/于雷)10月31日,小米昨日发布并开源轻量级文档理解模型Xiaomi-OCR-0。该模型仅0.8B参数,将文档解析、关键信息抽取与OCR视觉问答三类能力合为一体,主打在轻量级体量下实现复杂文档的结构化解析与语义理解。
从评测表现看,Xiaomi-OCR-0在真实拍摄干扰场景的Real5-OmniDocBench上取得95.24分,位列对比模型第一。
在OmniDocBench v1.6上取得96.83分,以0.8B参数夺得总榜第二、1B以下模型第一。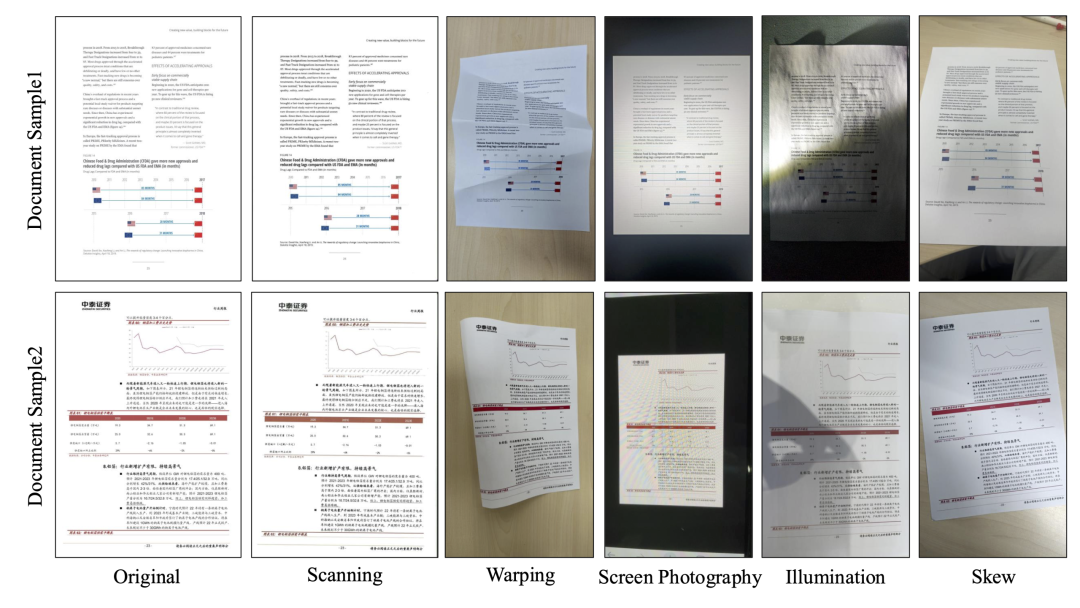
在五项主流OCR视觉问答基准上,其平均分为83.2,超过部分专用OCR模型和更大尺寸通用多模态模型,展示出较高的参数效能比。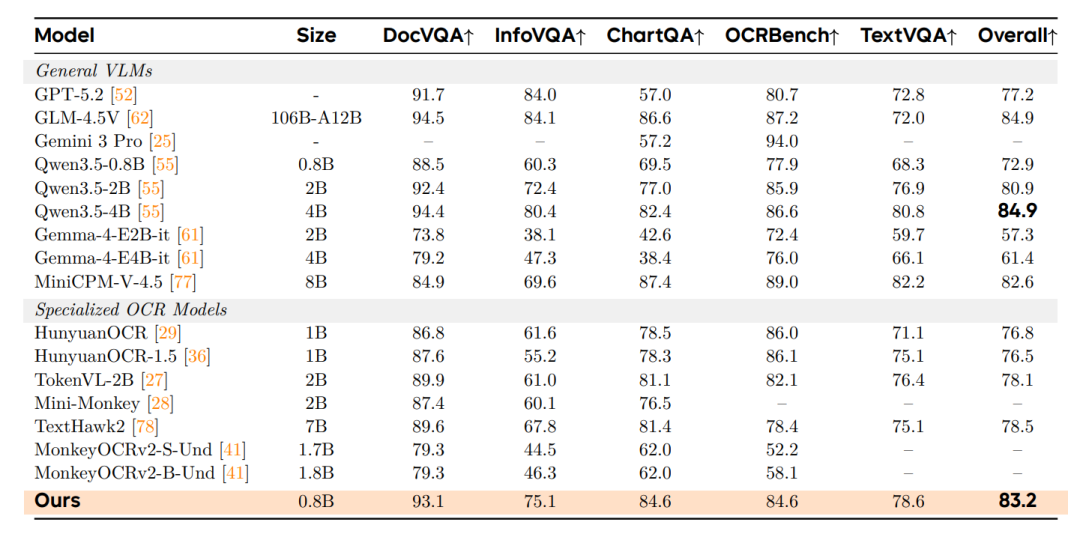
技术层面,小米称该模型基于约1.7亿条高质量样本训练,核心在于可扩展数据引擎与“先解析、后理解”的渐进式训练策略,以降低伪标签噪声并补足复杂版式和长尾场景能力。
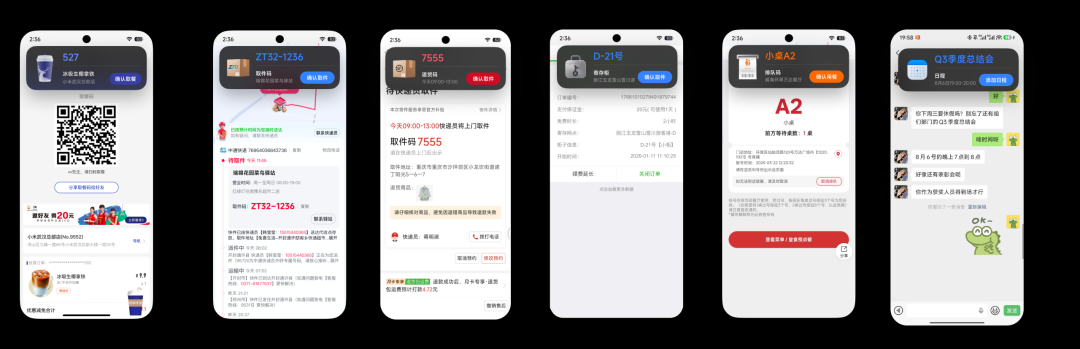
落地方面,相关技术已进入小米手机与“超级小爱”场景,可用于取餐码、账单、卡证、日程和航班信息等屏幕信息的识别与后续操作。小米同时开源模型权重与推理代码,并提供Demo、MCP服务及Agent Skill工具包,面向开发者开放集成。
精彩评论